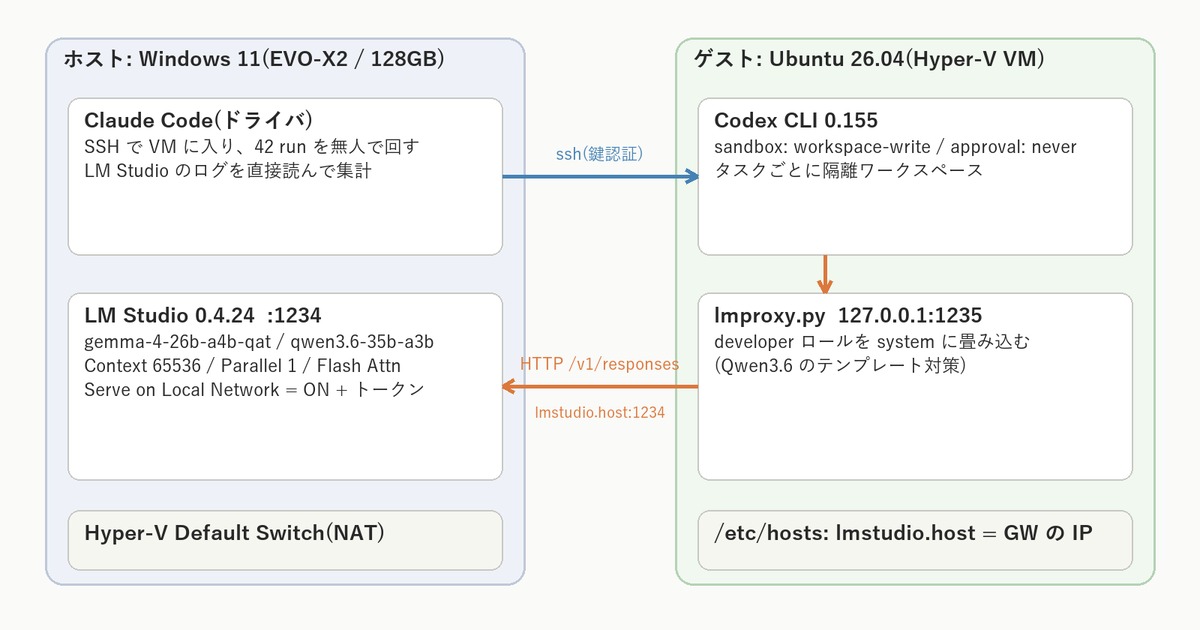
前回、LM Studio Bionicを入れる前に安全性を調べ倒して、「128GBあるなら、Hyper-VのVMでエージェントを動かして、モデルはホストのLM Studioに置くのが現実的」と書きました。机上の結論です。
今回はそれを実際に組みました。EVO-X2(Ryzen AI Max+ 395 / 128GB)の上にHyper-VでUbuntuを立て、その中でCodex CLIを動かし、モデルはホスト側のLM Studioから供給する構成です。
先に白状しておくと、組み上がるまでに踏んだ地雷の数が、前回の調査で想定していた数を軽く超えました。設定のミスでプロンプト処理が0.66 tok/sまで落ちて「モデルが壊れているのか」と本気で疑いましたし、片方のモデルだけが全リクエスト500エラーで返ってくる朝もありました。そのすべてを、原因と対処つきで残しておきます。
なお、この記事は「環境構築編」です。組んだ環境で2つのローカルモデルをエージェントとして比較した結果は、次の「性能評価編」にまとめました。先に結果だけ知りたい方はそちらへどうぞ。
まず、できあがった構成をどうぞ
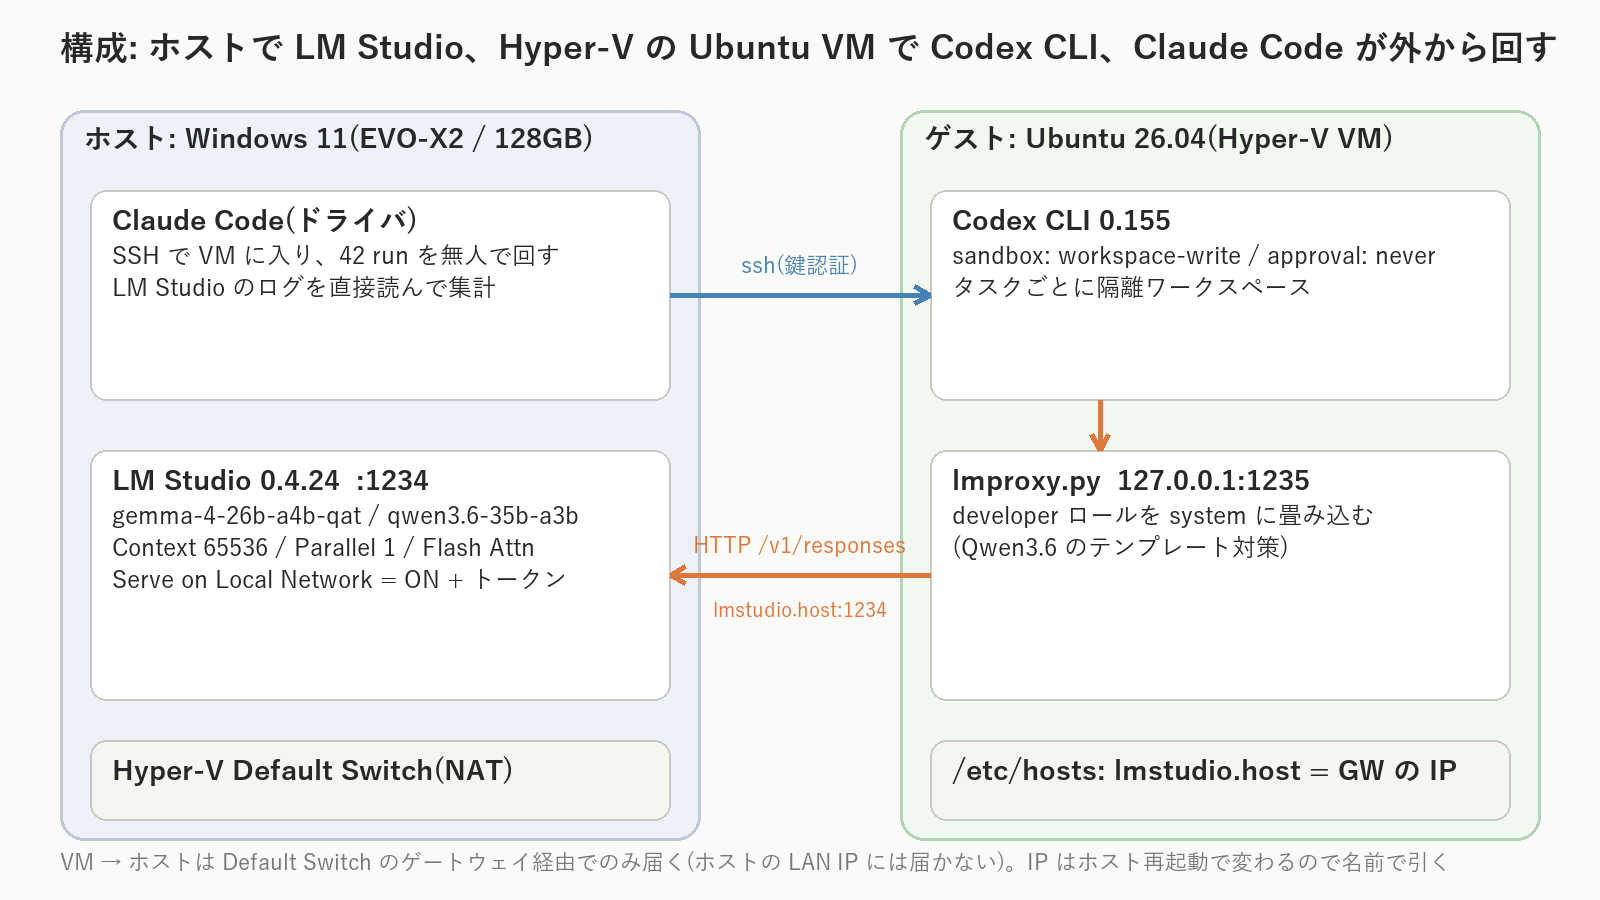
- ホスト(Windows 11): LM Studio 0.4.24。
google/gemma-4-26b-a4b-qatとqwen/qwen3.6-35b-a3bをロード。Serve on Local Network = ON、APIトークン認証 = ON - ゲスト(Hyper-V VM): Ubuntu 26.04 LTS。Codex CLI 0.155.1。サンドボックスは workspace-write
- VM → ホスト: Hyper-VのDefault Switch(NAT)経由。
lmstudio.hostという名前で引く - 実測: 生成 49〜58 tok/s、プロンプト処理 900〜1,100 tok/s(Q4量子化、Thinking有効、コンテキスト64K)
そして、この構成で検証を回したのは私ではなくClaude Codeです。前回までは Claude Cowork で作業していたのですが、Coworkのシェルは隔離サンドボックスなので、LANの向こうのVMには届きません。手順書を書いて自分で打つ、を繰り返す羽目になりました。そこで検証フェーズに入るタイミングで Claude Code に切り替え、SSHでVMに入って題材の配布・Codexの実行・判定・ログ回収までを自動で回してもらいました。42回の実験を3時間半、無人でです。私がやったのは、区切りごとに届く報告を読んで判断を返すことだけでした。
なぜ「Hyper-V + ホストのLM Studio」なのか(おさらい)
前回の結論の要点だけ。
- エージェントにファイルとシェルを預ける以上、やらかしたときの被害範囲をVMの中に閉じ込めたい
- でも26B〜35BクラスのモデルをVMの中でも動かすのはメモリの二重投資。モデルはホストに1つだけ置いて、VMからはAPIで使う
- LM Studioは
0.0.0.0で待ち受けられるので、VMからはHTTPで届く
仮想スイッチは、前回「Internalスイッチで外部と繋がない構成」も検討していましたが、今回はDefault Switch(NAT、外部接続あり)にしました。Codex CLIのインストール自体にインターネットが要りますし、apt も pip も止まるのは不便が勝ちます。エージェントが動くときのネットワークは、Codex側のサンドボックス(既定でネットワーク遮断)で絞る、という切り分けです。
ネットワークで詰まったところ
Default SwitchのIPは、ホストを再起動すると変わる
これが最初の地雷でした。Default SwitchはNATで、ゲートウェイ(=ホスト)のIPが 172.20.0.1 のような値になるのですが、このレンジがホストの再起動ごとに変わります。仕様です。VMの /etc/hosts にホストのIPを直書きすると、翌朝には繋がりません。
対処は「IPを書かずに、名前で引く」。VM側に小さなスクリプトを置いて、デフォルトゲートウェイを調べて /etc/hosts の lmstudio.host を書き換えるようにしました。systemdのタイマーで起動30秒後と2分ごとに実行します。
タイマーにしたのには理由があって、Hyper-Vの自動停止アクションが既定の「保存された状態」だと、ホスト再起動後にVMが起動処理を経ずに復帰するので、起動時だけ実行するサービスでは間に合わないのです。
#!/usr/bin/env bash
# /usr/local/sbin/update-lmhost
GW=$(ip -4 route show default | awk '{print $3; exit}')
sed -i '/[[:space:]]lmstudio\.host$/d' /etc/hosts
echo "$GW lmstudio.host" >> /etc/hosts
これを update-lmhost.service(oneshot、After=network-online.target)から呼び、update-lmhost.timer(OnBootSec=30s / OnUnitActiveSec=2min)で回します。
ホスト → VM は名前で入れる。逆はできない
Default Switchは hosts.ics に <VM名>.mshome.net というマッピングを作ってくれるので、ホストからは ssh <ユーザー名>@<VM名>.mshome.net で入れます。便利なのですが、この名前解決はホスト→VM方向でしか効きません。VMからホストを名前で引く仕組みは用意されていないので、上の lmstudio.host が必要になります。
ホストのLAN IPには、VMから届かない
LM Studioは 0.0.0.0:1234 で待ち受けているので、VMからホストのLAN側IP(192.168.1.11)を叩けば届くはず、と思っていたのですが、届きません。ゲートウェイ経由(172.20.0.1)だけが通ります。原因はWindowsのstrong host modelかICSのNATの挙動だと推測していますが、確定していません。実害はないので深追いはやめました。
Codex CLIの設定で踏んだ罠、7つ
Codex CLIをLM Studioに向けるには ~/.codex/config.toml にプロバイダを書きます。最終形はこれです。
model                = "google/gemma-4-26b-a4b-qat"
model_provider       = "lmstudio_host"
model_context_window = 65536

sandbox_mode    = "workspace-write"
approval_policy = "on-request"

[model_providers.lmstudio_host]
name     = "LM Studio on host"
base_url = "http://lmstudio.host:1234/v1"
wire_api = "responses"
env_key  = "LMSTUDIO_API_KEY"
たった十数行ですが、ここに至るまでに踏んだ罠を並べます。
| 事象 | 原因 / 対処 |
|---|---|
Missing environment variable: <キーの値> | env_key には環境変数の名前を書く。値を書くとその値を名前として探しに行く |
model_context_window が効かない | TOMLのトップレベルに書く。[model_providers.…] より後ろに書くとテーブルの中身になる |
wire_api = "chat" で起動エラー | 廃止済み。responses のみ。LM Studioは /v1/responses に対応している |
[model_providers.lmstudio] が無視される | openai / ollama / lmstudio は予約済みID。別名を使う |
プロジェクト直下の .codex/config.toml でプロバイダが効かない | model_provider / model_providers はユーザーレベルのみ有効 |
approval_policy = "untrusted" が使えない | 廃止。on-request か never |
SSH越しに codex が見つからない、APIキーが空 | .bashrc は対話シェル専用。ssh host 'codex …' では読まれない。ラッパースクリプトで PATH とキーを明示する |
最後の .bashrc の件は、あとで自動化するときに最初の壁になりました。GUIログインでも .profile が読まれない(Waylandセッション)ので、環境変数の置き場所には少し悩みます。
Codex CLI本体のインストールは公式の curl … | sh ですが、実行前にリポジトリの scripts/install/install.sh を読みました。チェックサム検証あり、sudoなし、~/.local/bin に置くだけ、と分かってから流しています。前回あれだけ「信頼境界」の話を書いた手前、ここは省けません。
0.66 tok/sの地獄──モデルが弱いのではなく、設定だった
ここが今回いちばん時間を溶かした話です。
最初にgemma-4-26bで「フォルダ内にどんなファイルがありますか?」と聞いたら、ループして終わりませんでした。LM Studioのログを見ると、プロンプト処理が144 tok/sで始まって、進むほど劣化して0.66 tok/sまで落ちている。生成も6.87 tok/s。これはモデルが弱いのか、Strix Haloの限界なのか、と一瞬本気で思いました。
原因はLM Studioのモデルロード設定でした。ログにこう出ていました。
load_model: initializing, n_slots = 4, n_ctx_slot = 262144Parallel(並列スロット)が4、コンテキストが256K。つまりKVキャッシュが実質1Mトークン相当まで膨らんでいて、スロット同士が競合していたわけです。1リクエストしか投げていないのに、です。
Parallel = 1、Context = 65536 に直したら、こうなりました。
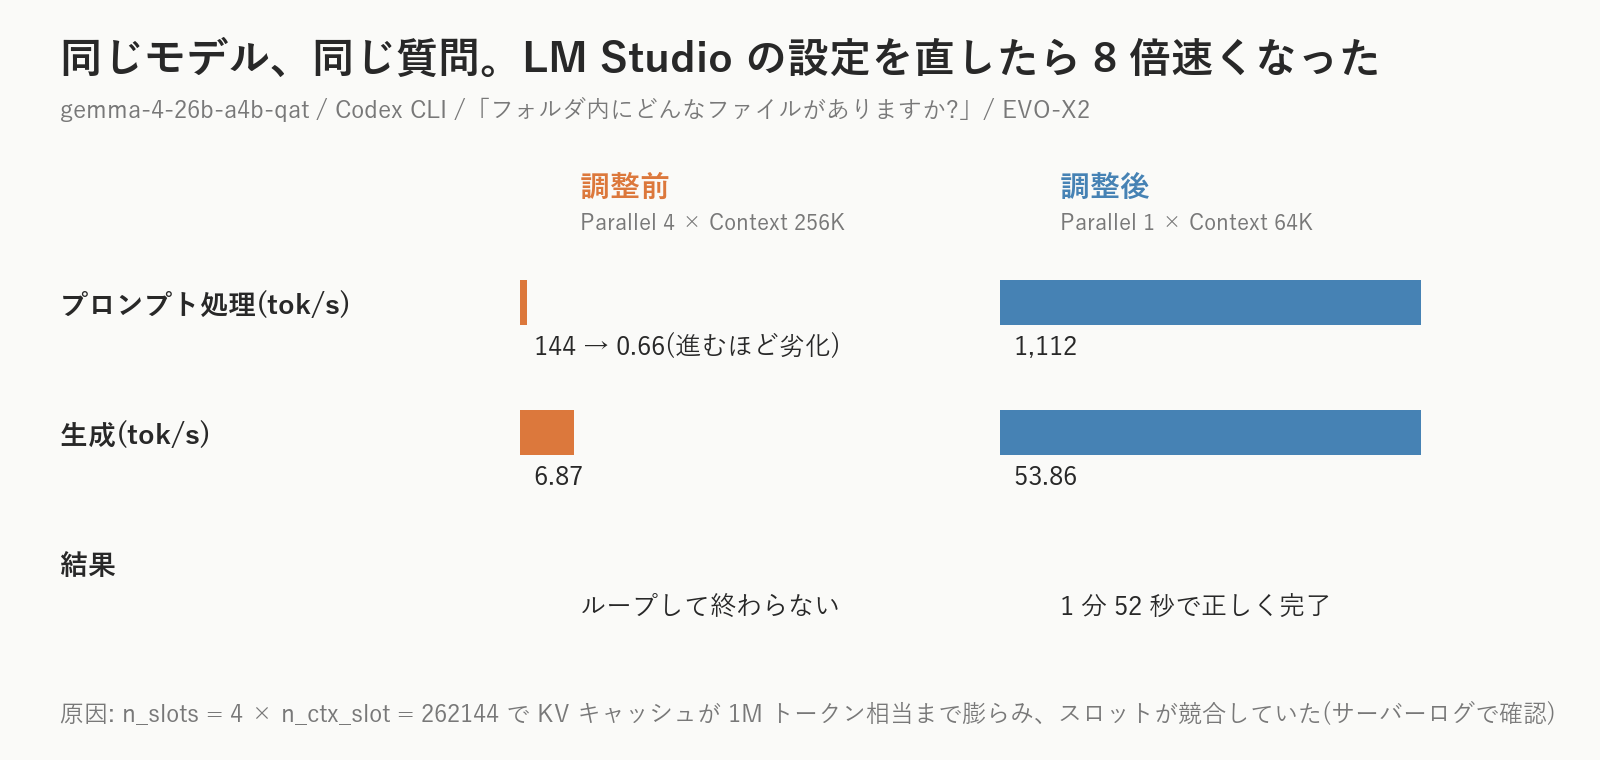
教訓は2つ。「ローカルLLMが遅い・ループする」と感じたら、モデルを疑う前にParallelとContextを疑う。そして、LM Studioのサーバーログは読む価値がある。C:\Users\<名前>\.lmstudio\server-logs\ に日付ごとのログがあり、llama.cppそのままの prompt eval time = … / N tokens と eval time = … / N tokens (… tokens per second) が1リクエストごとに出ます。あとで触れますが、このログが生成トークン数の正本になりました。
最終的なLM Studio側の設定はこうです。
- Parallel = 1(1人で使うなら1でいい)
- Context = 65536
- Flash Attention = ON
- Idle TTL = 10分(使わないモデルを勝手に降ろしてくれる)
- Serve on Local Network = ON、APIトークン認証 = ON
検証をClaude Codeに任せるために整えたこと
ここから先は「エージェントの評価を、別のエージェントに回してもらう」ための下ごしらえです。読み飛ばしても構いませんが、同じことをやる人には効くはずです。
- SSHの鍵認証: WindowsのOpenSSHの ssh-agent サービスは既定でDisabledでした。鍵を作って
authorized_keysに登録するだけの話ですが、パスワード認証のままだと自動化が止まります - sudoをパスワードなしに:
/etc/sudoers.d/にNOPASSWDを1行。実験用VMで機密データがないからできる割り切りです。本番機では絶対やりません - VMにgitが入っていなかった: Codex CLIはワークスペースがGitリポジトリかどうかを見ますし、判定スクリプトも
git diffを使います。pytest共々apt install - ホストとVMの時計が5.5秒ずれていた: VMはNTP同期、ホストが進んでいました。LM Studioのログ(ホスト時刻)から実験ごとの区間を切り出すのに困るので、LM Studioが返すHTTPの
Dateヘッダ(=ホスト時刻)を実験の開始・終了マーカーにしました - Codexの非対話モード:
codex exec --jsonで、承認プロンプトなし・イベントをJSONLで吐く形にしました。各実験は使い捨てのワークスペースにコピーして、終わったらverify.shで機械判定、git diffで差分を保存、Codexのセッションログ(rollout)も回収
そして、ここで気づいたのがCodexが報告するトークン使用量が当てにならないことでした。あるセッションでLM Studioのログは「4,877トークン生成」と言っているのに、Codex側の usage は output_tokens=48。/v1/responses 経由だと、推論(Thinking)のトークンが正しく返ってこないようです。以降、トークン数はすべてLM Studioのログから集計しています。
Qwenだけ全リクエスト500エラー──犯人はチャットテンプレート
環境ができて、gemmaで一通り回せて、さあQwenも、と切り替えた瞬間に全リクエストが7秒で失敗しました。
Error: Jinja Exception: System message must be at the beginning.切り分けはcurlで直接やりました。
| 送ったもの | 結果 |
|---|---|
instructions + user | OK |
instructions + developer + user | 500 |
| developer + user(instructionsなし) | OK |
Codex CLIは /v1/responses に、システムプロンプトを instructions として送るのとは別に、developer ロールのメッセージ(スキル一覧の案内、約3,000文字)を送ります。LM Studioはこの developer を「system に読み替える」と警告を出して処理するので、system メッセージが2つ並ぶ。Qwen3.6のJinjaテンプレートは「system は先頭に1つ」を検査していて、2つ目で例外を投げていました。gemmaのテンプレートにはこの検査がないので、gemmaだけ動いていたわけです。
Codex側でこの developer メッセージを消す設定は見つかりませんでした(スキルのディレクトリを退避しても、起動時に再生成されます)。そこでVMに130行のプロキシを置きました。Codexからのリクエストを受けて、developer の内容を instructions の末尾に畳み込み、system を1つにしてからLM Studioへ流すだけのものです。Codex側は [model_providers.lmstudio_proxy] を1つ足して、base_url を http://127.0.0.1:1235/v1 に向けます。
比較実験としては、両モデルとも同じプロキシを通すことで条件を揃えました。それでも「モデルの差を測る前に、テンプレートの差で片方だけ動かない」という事態は、ローカルモデルを複数抱える人には他人事ではないと思います。
実測 tok/s
というわけで、ようやく数字です。
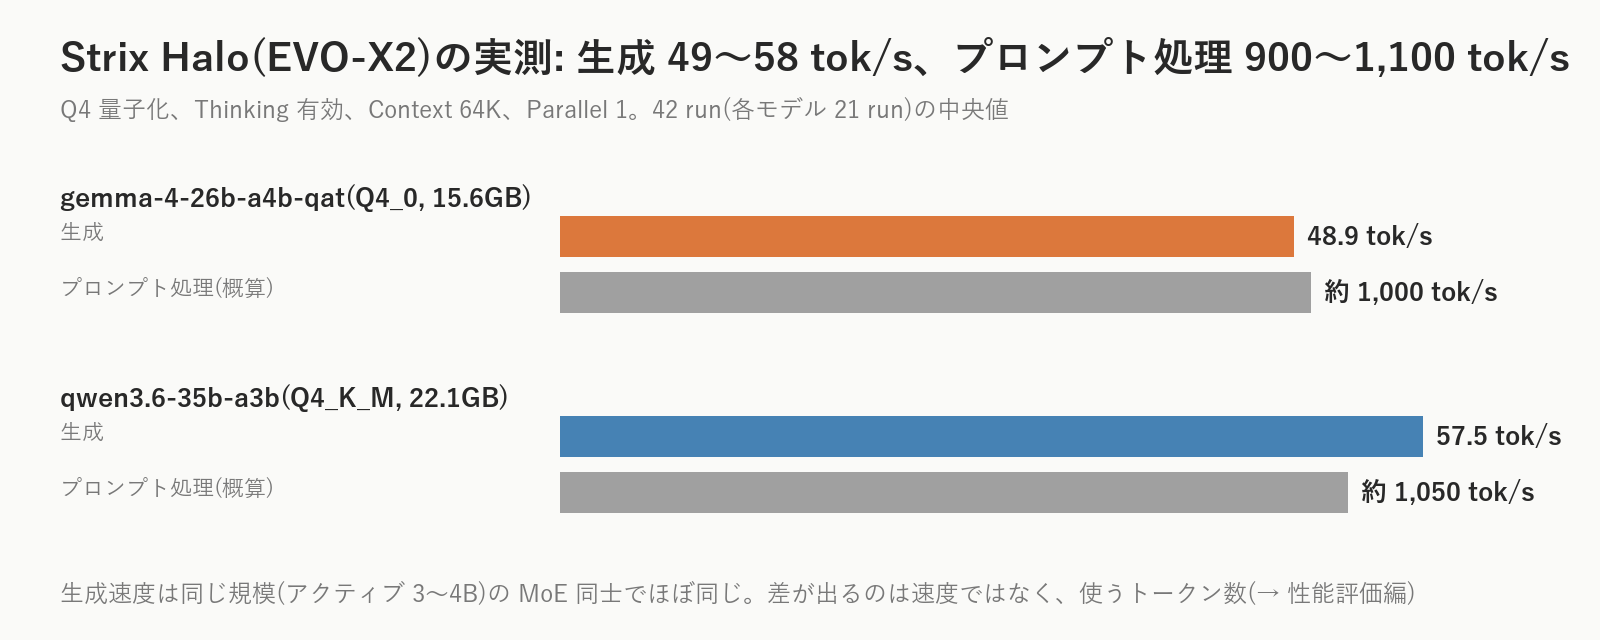
- 生成: gemma 48.9 tok/s、qwen 57.5 tok/s
- プロンプト処理: 900〜1,100 tok/s
- コンテキストが64Kまで膨らんだ実験では、生成が46 tok/s台まで落ちる
前回の記事で「コンテキストは32Kが最低・64Kが実用」と(未検証のまま)書きましたが、これは性能評価編で少し違う見え方をします。qwenは6タスクで最大でも16.7Kしか使わなかった一方、gemmaは64Kを使い切る実験が8回ありました。使い切った理由は、推論ではなくループです。
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 構成の決定(Hyper-V + ホストLM Studio、Default Switch) | SSH鍵の生成、VM側の前提確認(git / pytest / bubblewrap / 時刻ずれ) |
| LM Studioの設定変更(Parallel / Context)、モデルの選定 | 実験ハーネスの設計と実装(隔離ワークスペース、codex exec、判定、ログ回収) |
| sudo NOPASSWD の許可、GitHubログインなど権限の付与 | Qwenの500エラーの切り分け(curl)とプロキシの実装 |
| 「介入回数は測らなくていい」など、実験の判断 | 42回の実験の無人実行、LM Studioログからのトークン集計、採点 |
| この記事の方針と最終チェック | 図表の生成、原稿の下書き |
Coworkのときは「手順書をClaudeが書き、私が打つ」だったのが、Claude Codeでは「Claudeが打ち、私が判断する」に反転しました。VMという安全に壊せる箱があるからこそ、任せられた面はあります。
正直、気になっていること
- プロキシを挟んだ状態は、素のCodex + LM Studioとは厳密には違います。developer メッセージを system に畳み込んだぶん、システムプロンプトの構造がわずかに変わります。両モデル同条件ではありますが、「Codexが本来意図した形」ではありません
- VMからホストのLAN IPに届かない理由は未確定のままです
- Bionic は、まだ入れていません。前回予告した「BionicとCodex CLIを同一モデルで比べる」「Auto Reviewの自動承認率82%は自分の環境でも出るのか」は、この構成に慣れたあと、コントローラーに足るモデルが見つかってからやるつもりです
まとめ
- Hyper-V + ホストのLM Studioは実際に組めた。VM → ホストはDefault Switchのゲートウェイ経由、IPは名前で引く
- Codex CLIの設定は十数行だが、罠が7つ。特に
.bashrcが非対話で読まれない件は自動化の最初の壁 - 遅い・ループするときは、モデルより先にParallelとContextを疑う。0.66 tok/sは設定ミスだった
- Codexが報告するトークン数は当てにならない。LM Studioのサーバーログが正本
- Qwen3.6はCodexのdeveloperロールで500を返す。プロキシで畳み込めば動く
次回は、この環境で gemma-4-26b と qwen3.6-35b を同じ6タスクで3回ずつ回した結果です。「26Bクラスのローカルモデルは、エージェントとして成立するのか」という問いに、42回分の数字で答えます。片方は21回中21回成功し、もう片方は「I’ll use apply_patch.」と1,476回つぶやきました。
→ 公開しました: 26Bクラスのローカルモデルはエージェントとして成立するのか──Gemma 4 26BとQwen3.6 35BをCodex CLIで6タスク×3回ずつ回した(性能評価編)
五十路の検証は、寝ている間に終わっている。
コメント