 テクノロジー
GPT-6 Lunaを、旧Lunaと同じ21回のテストで測ってみた──費用は4割減、でも速度は落ち、合格数は判定器どおりなら12/21で後退、しかし質も考慮して読みを緩めれば18/21。effortは上げても効かない(クラウド対決・追加報告編)
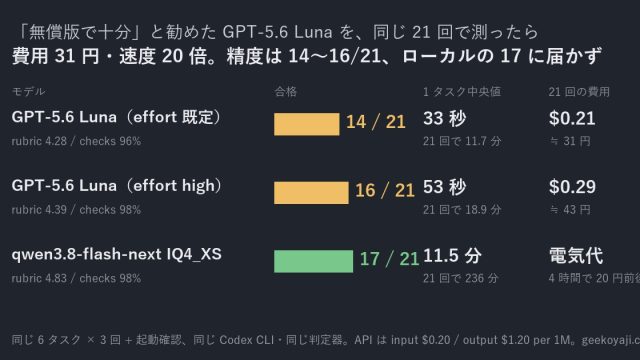
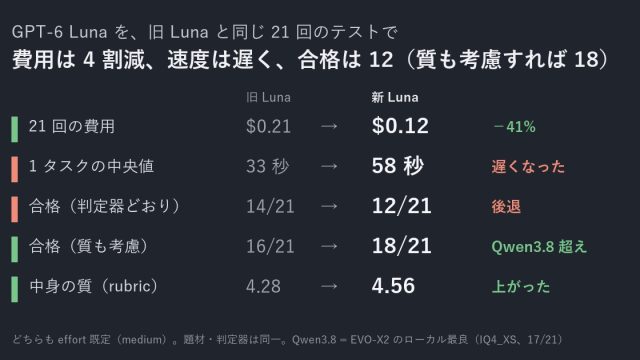
前回GPT-5.6 Lunaを測った記事を公開した当日に、OpenAIがGPT-6 Lunaを発表。同じVM・同じCodex CLI・同じ判定器で、同じ21回をeffort既定・high・xhighの3通りで回しました。費用は21回$0.124(約18円)で旧Lunaから4割減、ただし出力が1.4倍に増えて1タスクの中央値は33秒から58秒に。精度は数字が2つあり、判定器どおりなら12/21で旧Lunaの14/21より後退、中身の質は満たしているのに判定器の読みが厳しくて落ちた4か所を、全モデル共通の規則で緩めると18/21でローカル最良のQwen3.8 IQ4_XS(17/21)を超える。旧Lunaの「壊れた物差し」と家計簿は直り、動画プロンプトは話者IDを書きすぎから書かなさすぎに反転。落ち方は「足す」から「省く」へ。effortは12→12→11で、上げても効かない。