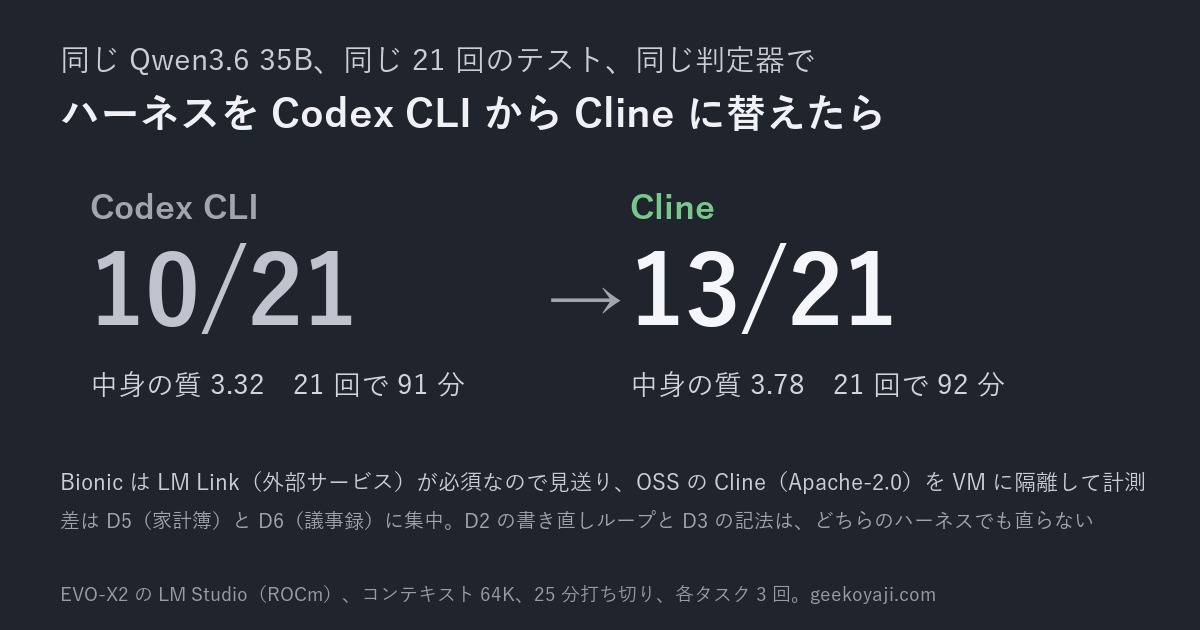
前回のハーネス比較編で、同じQwen3.6 35Bでもハーネスを Codex CLI から Cline に替えたら、合格が10→13/21に動きました。そうなると気になるのが、ほかのハーネスです。Clineのような、OSSのAIエージェント基盤はほかにもある。全部並べたら、どれが一番なのか。
そこで、Claude Codeに候補を徹底的に探してもらい、上位3つ(OpenCode・OpenHands・Goose)を同じ21回のテストで回してもらいました。もう1つ、前から知りたかったことも一緒に測ってもらっています。同じ世代のモデルで、Dense(全部のパラメータを毎回使う)とMoE(一部の専門家だけを使う)はどう違うのか。 こちらは、成績の良かったハーネスとQwen3.8 27B(Dense)の組み合わせで測りました。
先に結論を書きます。
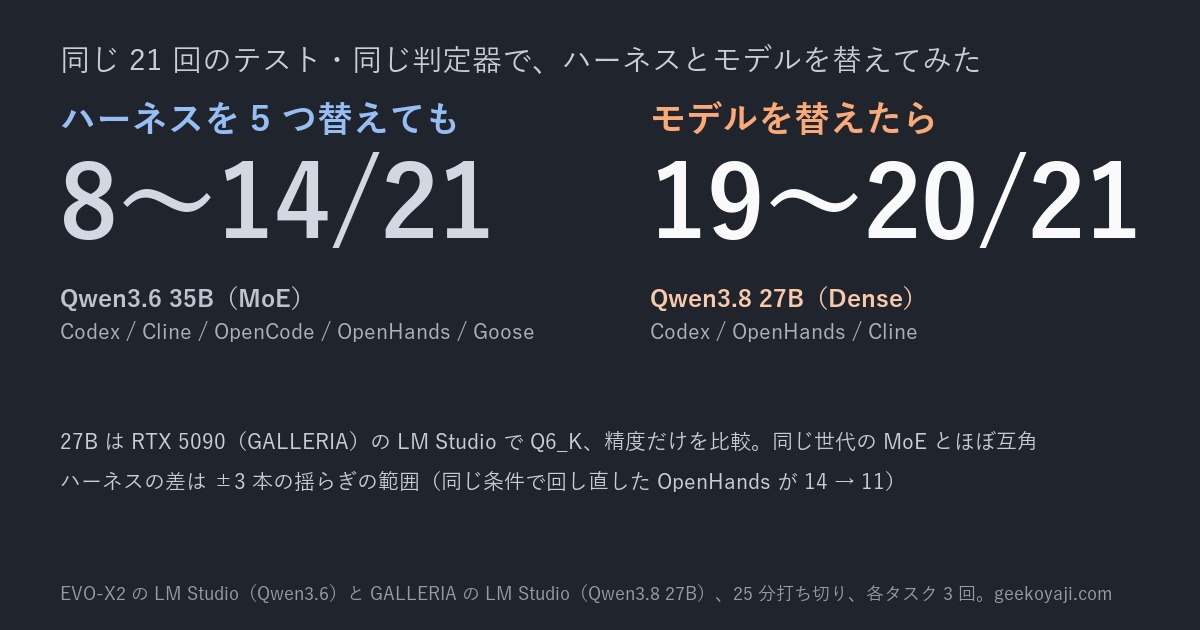
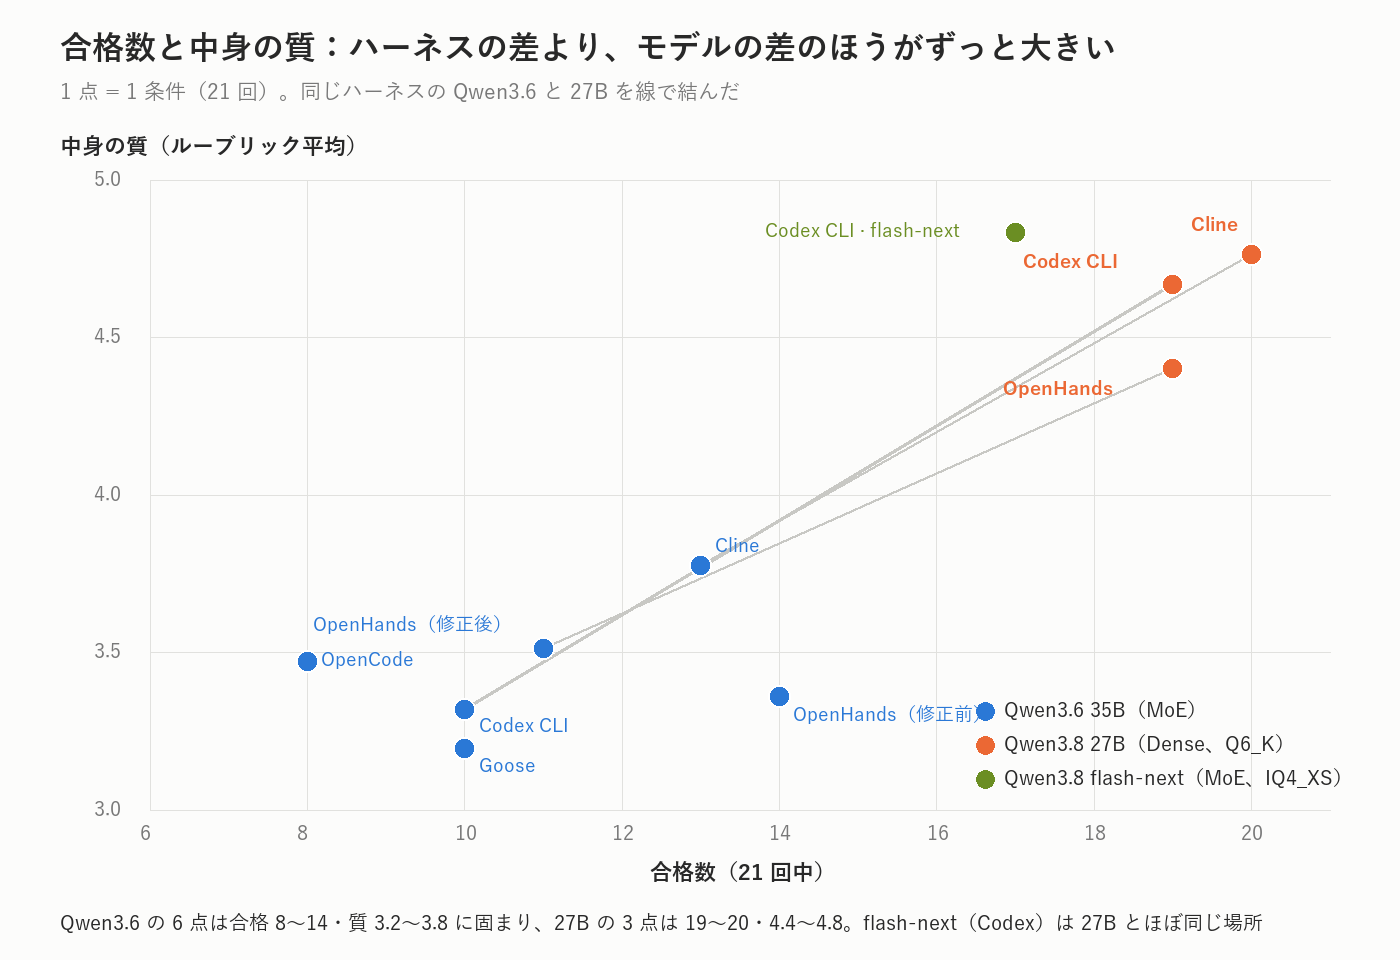
- Qwen3.6 35Bでは、ハーネスを5つ替えても合格は8〜14/21の範囲でした。 Codex 10、Cline 13、OpenCode 8、OpenHands 14、Goose 10。ただし、OpenHandsを同じ条件で回し直すと11に動いたので、±3本くらいの差は「揺らぎ」の範囲です
- モデルをQwen3.8 27B(Dense)に替えたら、どのハーネスでも19〜20/21。 Codex 19、OpenHands 19、Cline 20。同じハーネスで7〜9本増えました。ハーネスの差より、モデルの差のほうがずっと大きい
- 同じ世代のDenseとMoEは、ほぼ互角でした。 Codex CLIでQwen3.8 27B(Dense、23GB)が19/21、Qwen3.8 Flash Next(MoE、88GB)が17/21。中身の質はMoEがわずかに上です
- Qwen3.6で起きた失敗の多くは、モデル側の癖でした。 1回の返答が数万トークン止まらなくなる暴走や、「です・ます調」の取りこぼしは、ハーネスを替えても出ます
まず、結果をどうぞ
| Codex CLI | Cline | OpenCode | OpenHands | Goose | |
|---|---|---|---|---|---|
| Qwen3.6 35B(MoE) | 10・3.32 | 13・3.78 | 8・3.47 | 14・3.36(回し直し 11・3.51) | 10・3.19 |
| Qwen3.8 27B(Dense、Q6_K) | 19・4.67 | 20・4.76 | — | 19・4.40 | — |
| Qwen3.8 Flash Next(MoE、IQ4_XS) | 17・4.83 | — | — | — | — |
(合格数/21・中身の質。中身の質はタスク別のルーブリック0〜5点の平均)
題材・依頼文・判定器は日常タスク編からそのまま、各タスク3回、25分で打ち切りです。今回の147回(7条件×21回)は、Claude Codeが9月26日の朝から夜まで、無人で回しました。
候補の選び方:CLIで自動評価できる3つ
Claude Codeに頼んだ条件は、こうです。
- 個人で自由に使えるライセンスで、ソースコードが公開されていること(商用で使えるかは問わない)
- マイナーで、品質の評価が固まっていないものは除く
候補は十数個挙がりました。そこから、アーカイブ済みや更新が止まったもの、出たばかりのものを外し、残った上位がOpenCode(MIT)、OpenHands(MIT)、Goose(Apache-2.0)です。私は「評価が手作業になるものは後回し」と決めました。Clineのデスクトップ版を1本ずつ手で回したのが、さすがにしんどかったので(笑。Claude Codeが調べたところ、3つともコマンドラインで依頼文を渡して、承認なしで最後まで走らせられることが分かりました。
構成:前回の箱をそのまま使い、RTX 5090を足した
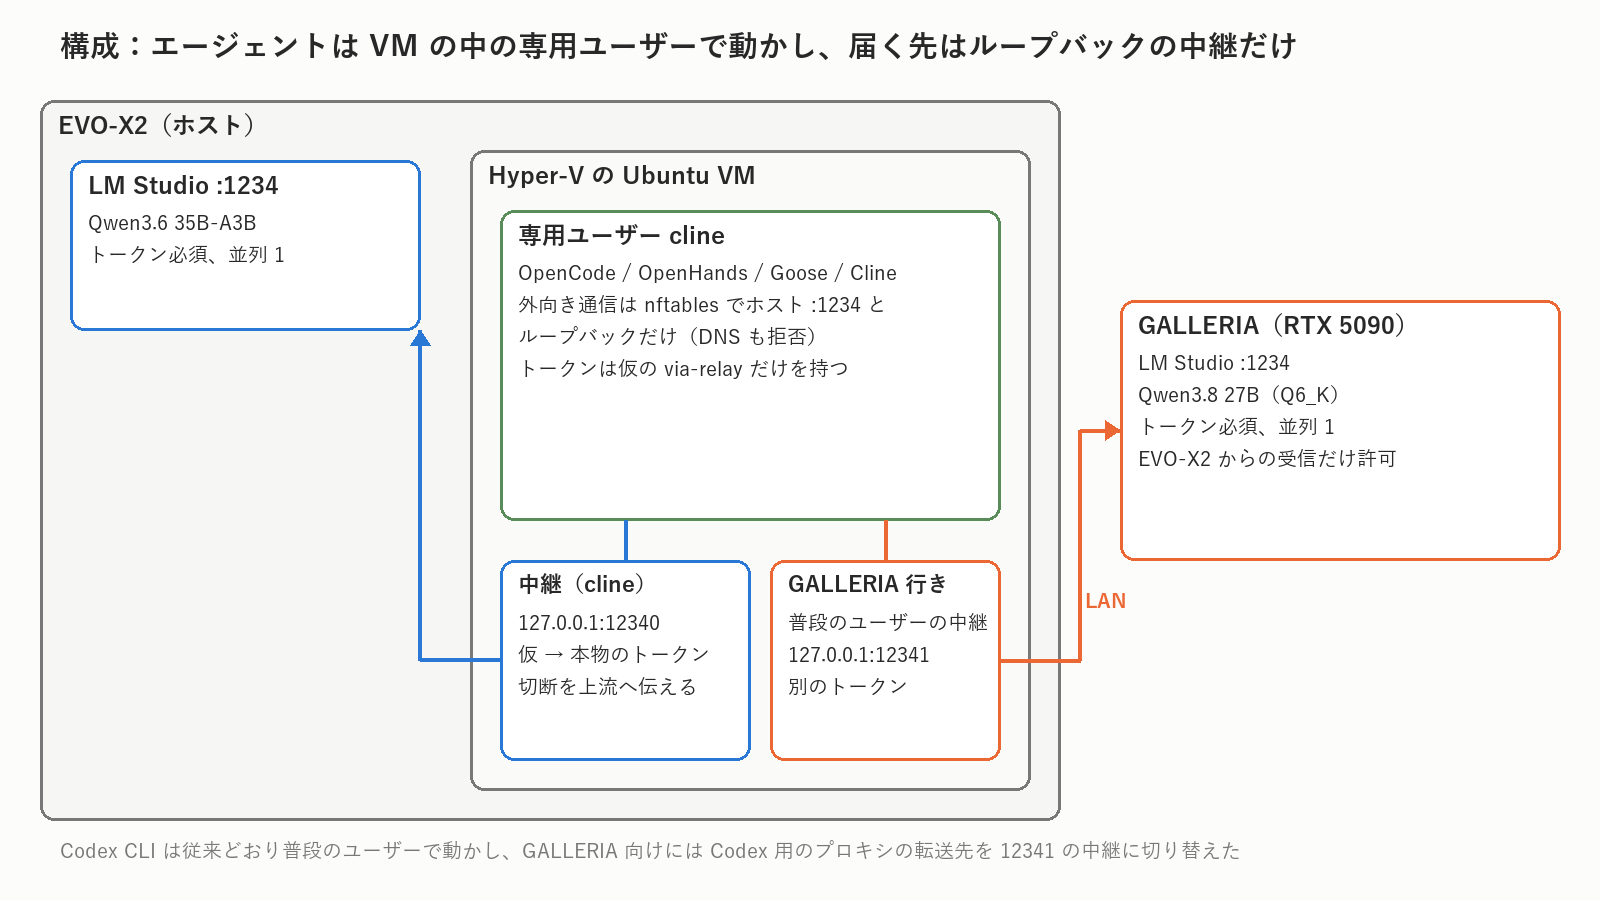
エージェントを閉じ込める箱は、前回Cline用に作ったものがそのまま使えました。
- VMの専用ユーザー
clineで動かす。 外向き通信はファイアウォール(nftables)で、ホストのLM Studioとループバックだけに絞っています。DNSも止めてあります - 3つとも、公開されたハッシュ値と照合済み。 Claude CodeがGitHubのリリースから入手し、ハッシュ値を照合してから入れています
- トークンは仮のものだけを渡す。 各ハーネスには
via-relayという仮のトークンを設定し、VMの中の中継が本物に差し替えます。本物のトークンは、どのハーネスの設定ファイルにも残っていません
Dense/MoEの比較では、RTX 5090のGALLERIAを使いました。Qwen3.8 27B(Dense)は、1トークン生成するたびに約23GBの重みを読みます。量子化編で分かったとおり、EVO-X2の速度は「1トークンで読むバイト数」で決まるので、見積もりは毎秒6トークン前後。これでは25分の打ち切りでほとんど落ちます。そこで、速度の比較はあきらめ、精度だけを比べることにしました。量子化は、単純な比較よりも最高精度を出せるかを優先してQ6_Kにしています。
GALLERIA側の準備(モデルのダウンロード、LM Studioのローカルネットワーク公開とトークンの発行、ファイアウォールでEVO-X2からの受信だけを許可)は、私がやりました。VMのclineユーザーの外向き制限は変えていません。GALLERIAへは、普段のユーザーで動かす中継(127.0.0.1:12341)がLAN越しに転送するので、エージェントから直接届くのは、相変わらずループバックの中継だけです。
Qwen3.6 35B × ハーネス5つ
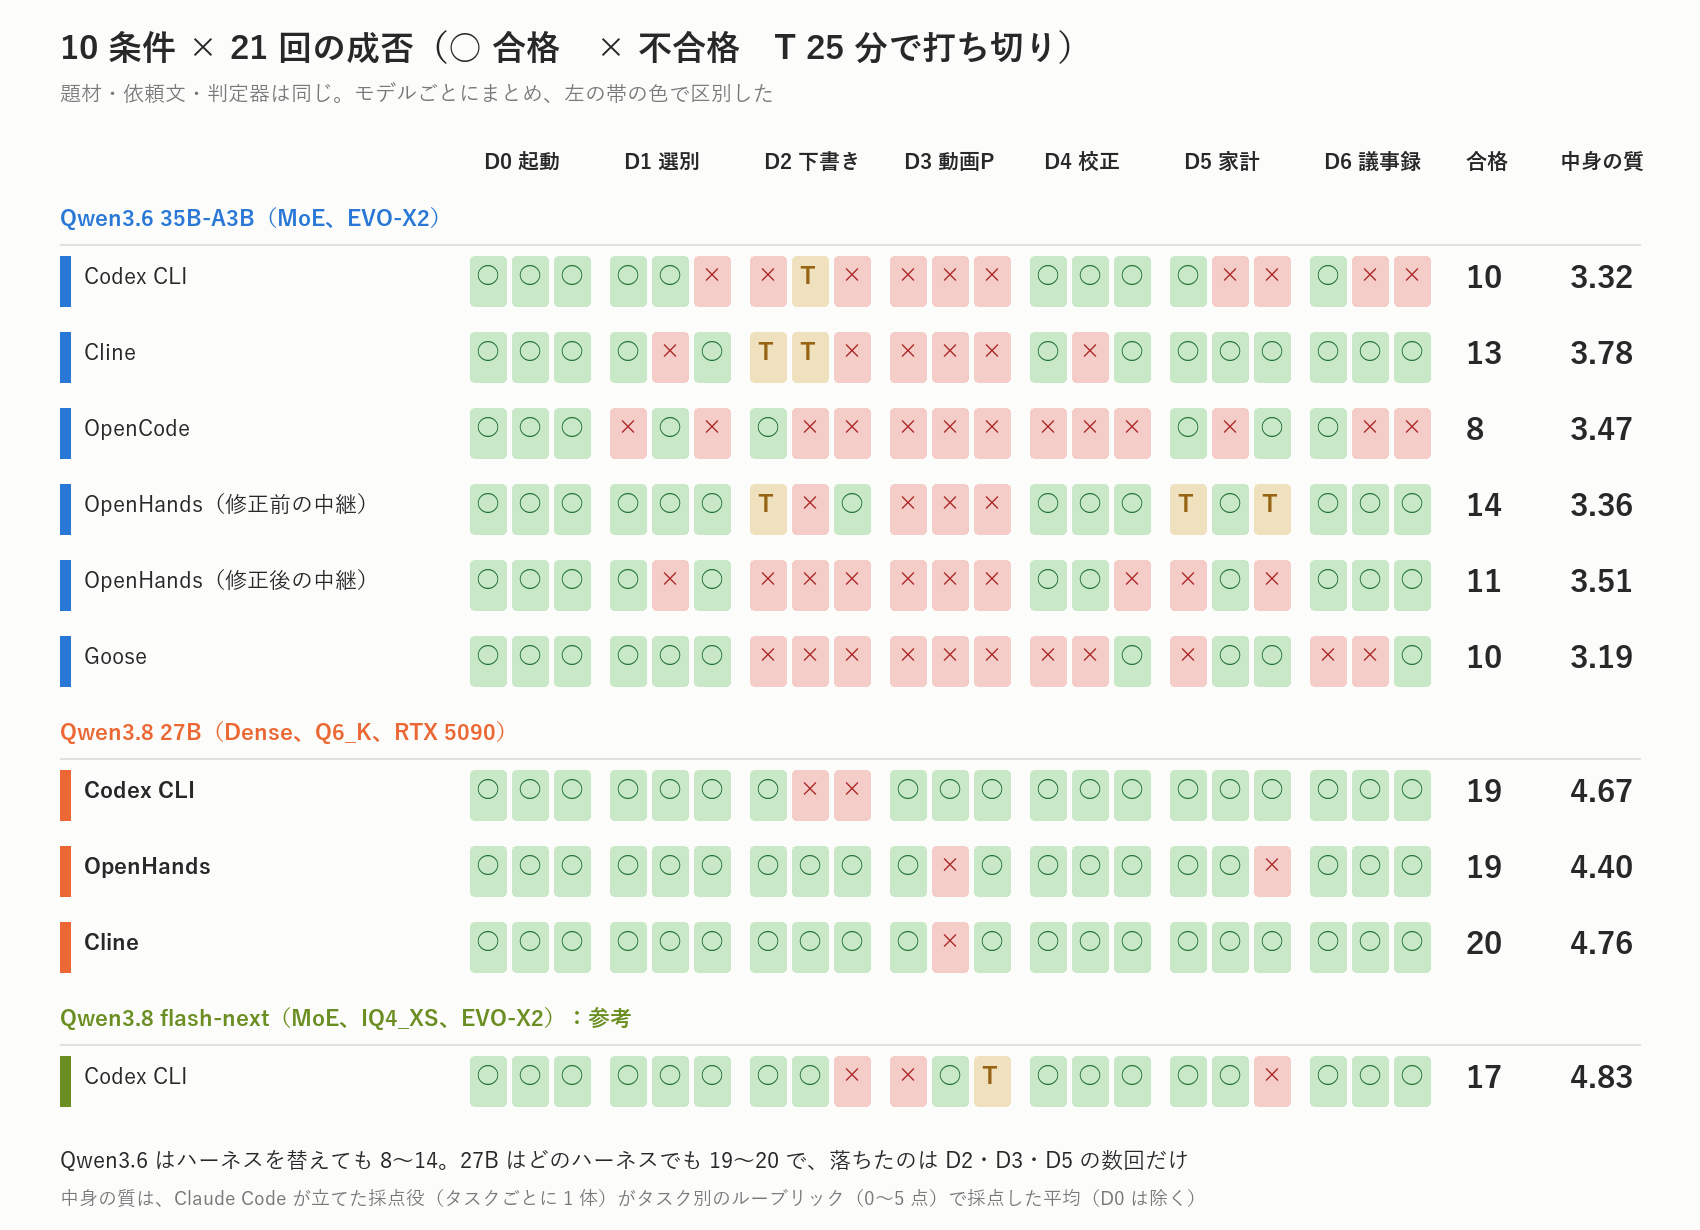
まずは同じQwen3.6 35Bで、ハーネスだけを替えた結果です。
| ハーネス | 合格 | 中身の質 | 21回の合計 | 1タスクの中央値 | 25分の打ち切り |
|---|---|---|---|---|---|
| Codex CLI 0.155.1 | 10/21 | 3.32 | 91分 | 95秒 | 1回 |
| Cline CLI 3.0.65 | 13/21 | 3.78 | 92分 | 123秒 | 2回 |
| OpenCode 1.18.32 | 8/21 | 3.47 | 51分 | 118秒 | 0回 |
| OpenHands CLI 1.16.0 | 14/21 | 3.36 | 168分 | 269秒 | 3回 |
| (OpenHands 回し直し) | 11/21 | 3.51 | 97分 | 202秒 | 0回 |
| Goose 1.52.0 | 10/21 | 3.19 | 92分 | 103秒 | 0回 |
OpenCodeは、21回を51分で終えた最速のハーネスでした。動画プロンプト(D3)は3回とも不合格ながら18項目中15〜17項目を通し、記法の正確さはGooseと並んでこのモデルで一番でした。ブログ下書き(D2)では、Qwen3.6として初めての合格も出ています(このあとOpenHandsでも1回通りました)。一方、校正(D4)は3回とも不合格で、原文と同じ文字列を「修正案」に書いたり、直す向きが逆だったりと、雑さが目立ちました。
OpenHandsは、合格数が14/21で最多。ただし一番遅く、25分の打ち切りも3回ありました。その原因は、実はClaude Codeが作った中継の不具合でした(次の節で書きます)。Claude Codeが中継を直して回し直すと、打ち切りは0回になり、21回の合計も168分→97分に縮みましたが、合格は11/21に下がりました。 中継以外は同じ条件なので、3本の差は揺らぎと見るしかありません。回し直しでは、記事の読み込みを任されたサブエージェントが、20本中12本だけを読んで残り8本の中身をでっち上げ、本体がそれを確かめずに使う、という失敗も出ました。
Gooseは、ニュース選別(D1)を3回とも100秒前後で通し、会議メモ(D6)は40秒台と、一番軽いハーネスでした。ただ、1回の返答が止まらなくなる暴走が3回ありました。Gooseは返答を少しずつ受け取る方式(ストリーミング)なので、打ち切りにはなりません。コンテキストの上限(65,535トークン)まで約18分回り続け、ほぼ空の成果物のまま「正常終了」します。暴走の中身は、同じ一文を思考の中で延々と繰り返すものでした。
中身の質は、前回に続いてClineが最上位です。合格数ではOpenHandsが上でしたが、回し直しで入れ替わる程度の差でした。
OpenHandsの打ち切りは、中継の不具合だった
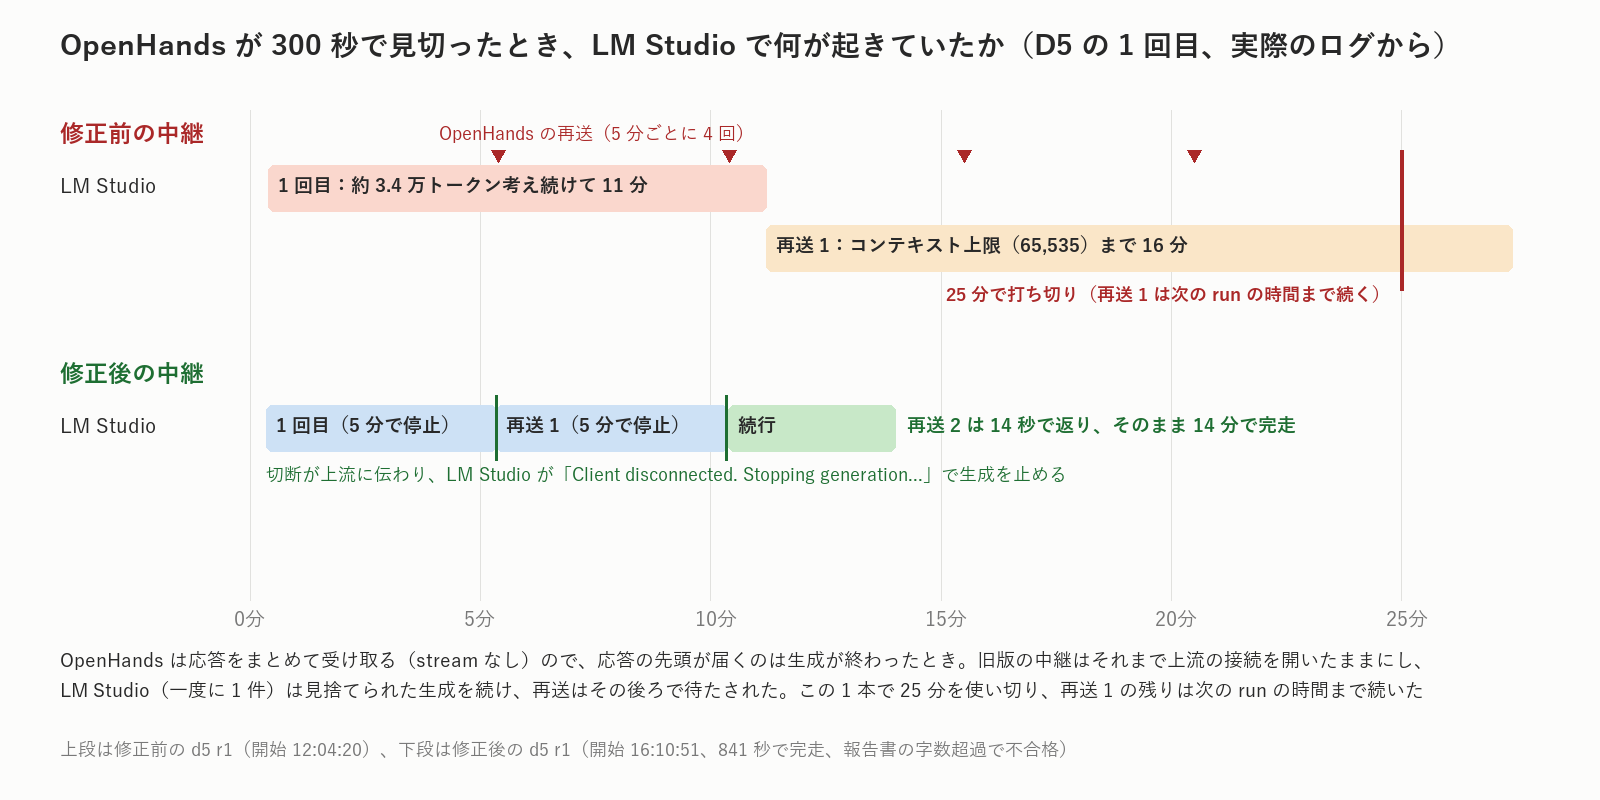
OpenHandsの25分打ち切りを、Claude CodeがLM Studioのログで調べると、こういう流れでした。
- Qwen3.6がときどき、1回の返答で10分以上考え込む
- OpenHandsは返答を300秒で見切って、同じ要求を出し直す
- ところが、Claude Codeが作った中継は、OpenHandsが切断しても、LM Studio側の接続を開いたままにしていた
- LM Studioは一度に1件しか処理しないので、誰も待っていない生成を続け、出し直しはその後ろで待たされる
Codex・Cline・OpenCode・Gooseは返答を少しずつ受け取る方式なので、この問題に当たりません。OpenHandsだけが返答をまとめて受け取るので、中継が「相手が切断したこと」に気づけなかったのです。Claude Codeが中継を直し、偽のサーバーで動作を確かめてから、LM Studioのログで「Client disconnected. Stopping generation…」と生成が止まることを確認しました。回し直しは、私が了承してから始めています。
ちなみに、1回の返答が1万トークンを超えて伸びる現象そのものは、Cline以外のすべてのハーネスで出ました(Codexで2回、OpenCodeで1回、OpenHandsで最初の21回に3回・回し直しでも3回、Gooseで3回)。ハーネスで違うのは、長考が止まらないときの止まり方です。 Gooseは上限まで回り、OpenHandsは見切って出し直し、OpenCodeは出力の上限(16,384トークン)で切れます。
Qwen3.8 27B(Dense)に替えたら
Qwen3.6の最良のハーネスは、合格数ならOpenHands、中身ならClineと割れました。そこで私は両方で回すことにし、比較用にCodex CLIでも回しています。
| ハーネス | Qwen3.6 35B(MoE) | Qwen3.8 27B(Dense) | 差 |
|---|---|---|---|
| Codex CLI | 10/21・3.32 | 19/21・4.67 | +9本・+1.35 |
| OpenHands(修正後の中継) | 11/21・3.51 | 19/21・4.40 | +8本・+0.89 |
| Cline | 13/21・3.78 | 20/21・4.76 | +7本・+0.98 |
3つのハーネスで、同じ向き・ほぼ同じ幅で伸びました。 ハーネスの順(中身の質でCline>Codex/OpenHands)は、2つのモデルで似ています。ただ、その差はモデルの差よりずっと小さい。
27Bが特に強かったのは、Qwen3.6がどのハーネスでも苦しんだタスクです。
- D3(動画プロンプト):Codex CLIで3回とも18/18の満点、ルーブリックも3回とも満点でした。このベンチでD3が満点になったのは初めてです。3ハーネス9回では7回が18/18で、残る2回のうち1回は、判定器の読み取り範囲(話者のIDを台詞の前260字までしか探さない)の問題で、実質は紐づいていました
- D4(校正):Codex CLIで再現率0.80〜0.90。原稿の「5台のHDD」と「壊れた1台+残り3台」の食い違いを3回とも拾いました。Qwen3.6は、全ハーネス18回で1回しか拾えていません
- D5(家計簿):計算スクリプトが、欠損月の検出・隔月の水道代の年換算・計画の金額とデータの照合まで行います。Qwen3.6の計算スクリプトは、削減額を定数で書き込む回がほとんどでした
- D2(ブログ下書き):OpenHandsとClineでは3/3。Qwen3.6で起きた「字数を数えては書き直す」ループは一度も起きず、多くても数回の修正で範囲に収めました。Qwen3.6は短い初稿を下限まで水増ししがちでしたが、27Bは長めの初稿を削って合わせる、と向きも逆でした
27Bにも弱点は残りました。Codex CLIではD2の3回中2回が「だ・である調」で不合格。ニュース選別では、指示を紛れ込ませた記事に、関心の区分から機械的に5点を付けた回が9回中4回ありました(指示に従ったわけではなく、要約からは外しています)。OpenHandsのD4では、正しい合計77,600円を計算違いで76,000円に「直す」、害のある修正案も出ました。判定器は行と分類だけで照合するので、これは「的中」扱いになります。 ルーブリックでしか拾えない失敗です。
Dense対MoE:同じ世代なら、ほぼ互角
同じCodex CLIで、同じ世代のMoEと比べるとこうなります。
| モデル | 種類 | ファイルの大きさ | 合格 | 中身の質 |
|---|---|---|---|---|
| Qwen3.6 35B-A3B | MoE | 約23GB | 10/21 | 3.32 |
| Qwen3.8 Flash Next(IQ4_XS) | MoE | 約88GB | 17/21 | 4.83 |
| Qwen3.8 27B(Q6_K) | Dense | 約23GB | 19/21 | 4.67 |
27B(Dense)は合格数で2本上回り、中身の質では0.16下回りました。1タスク3回では、どちらが上とは言えない差です。ファイルが4倍近い大きさのMoEと、23GBのDenseが同じ水準にいる、というのが今回の発見でした。一方、同じ23GBでも、世代の古いQwen3.6(MoE)とは大差がついています。今回の比較で一番効いたのは、DenseかMoEかより、モデルの世代でした。
なぜ23GBのDenseが、88GBのMoEと並んだのか
総パラメータが4倍以上あるMoEと、なぜ互角になったのか。ここは、広く知られている研究と、Qwenが公表している数字をもとに整理しておきます(資料はClaude Codeに集めてもらいました)。
「総パラメータ」と「1トークンで使うパラメータ」は別物
| Qwen3.6 35B-A3B | Qwen3.8 Flash Next | Qwen3.8 27B | |
|---|---|---|---|
| 種類 | MoE | MoE | Dense |
| 総パラメータ | 35B | 125B(+N-gram埋め込み51B) | 27B |
| 1トークンで使うパラメータ | 約3B | 約6B | 27B(全部) |
| 隠れ層の幅 | 2,048 | 2,560 | 5,120 |
| 層の数 | 40 | 48 | 64 |
| FFN(専門家) | 256個から8個+共有1個 | 512個から10個+共有1個 | 専門家なし(大きなFFNが1つ) |
| 注意の層(4層に1層) | 通常の注意 | 参照範囲を絞る注意(Qwen Sparse Attention) | 通常の注意 |
(各モデルの公式の構成ファイルとモデルカードから。3モデルとも、残りの3層は線形注意のGated DeltaNet)
MoE(Mixture of Experts)は、Transformerの各層にある「FFN(フィードフォワード層)」を、たくさんの小さな専門家に分けたものです。1トークンごとに、振り分け役(ルーター)が数個の専門家だけを選んで計算します。Qwenのモデルカードでも、Flash Nextは「注意 → MoE」、27Bは「注意 → FFN」という並びで、専門家に分かれているのはFFNだけです。注意の層はどちらも毎回全部使うので、「MoEは注意の力が弱い」というわけではありません。
違うのは、1トークンあたりの計算の量です。27Bは1トークンごとに27B全部を使い、これはFlash Next(約6B)の4倍以上、Qwen3.6(約3B)の約9倍にあたります。隠れ層の幅もFlash Nextの2倍で、層も16層深い。
知識の量は総パラメータ、考える力は1トークンあたりの計算
FFNは、学習した知識の多くを蓄えている場所だと考えられています。FFNが「キーと値の記憶」として働くことを示した研究があります(Geva ほか、EMNLP 2021)。専門家を増やせば、1トークンあたりの計算量はそのままで、知識をしまっておける場所を増やせる。これがMoEの強みです。
一方で、専門家を増やしても伸びにくいものがあります。2024年の研究「Mixture of Parrots」(Jelassi ほか)は、1トークンで使うパラメータを固定したまま専門家を増やすと、暗記や知識を問う課題は伸び続けるのに、推論の課題は頭打ちになることを示しました。理論の面でも、ある種のグラフの推論は、同じ幅の専門家をいくら増やしても解けないのに、少しだけ幅の広いDenseなら解けることを証明しています。
まとめると、知識の幅は総パラメータで、考える力(推論の深さや、いくつもの条件を同時に守る力)は1トークンあたりの計算で伸びやすい、という整理になります。
今回のテストは「知識を問わない」テストだった
日常タスクの評価セットは、判断に必要な資料をすべて渡します。ニュースの記事、会議メモ、家計簿のCSV、動画プロンプトのガイドライン。モデルが覚えている知識より、渡された資料を読み、いくつもの条件を同時に守りながら、矛盾なく手を動かせるかを見るテストです。MoEの強み(知識の幅)が出にくく、Denseの強み(1トークンあたりの計算)が効きやすい条件だったことになります。
Qwenの公表値も、この整理と合っています。モデルカードの比較では、Flash Nextはすべての項目で27Bを上回っていますが、差の大きさがはっきり違います。
| 課題の種類(Qwenの公表値) | Flash Next | 27B | 差 |
|---|---|---|---|
| 専門職の仕事(JobBench) | 55.7 | 33.4 | 22.3 |
| エージェントとしてのコーディング(DeepSWE 1.1) | 58.7 | 42.2 | 16.5 |
| 幅広い分野の難問(HLE) | 35.9 | 30.8 | 5.1 |
| 科学の推論(GPQA Diamond) | 91.7 | 89.2 | 2.5 |
| 指示への従い方(IFBench) | 81.3 | 79.5 | 1.8 |
| 競技プログラミング(LiveCodeBench v6) | 91.9 | 90.3 | 1.6 |
幅広い知識や長い作業を問う課題では大差、指示への従い方や、問題の中で完結する推論ではほぼ互角。今回の日常タスクは、後者に近い課題でした。
今回のデータでも、差が出たのは「条件の多いタスク」
同じCodex CLIどうしでタスクごとに見ると、合否の差がはっきり出たのはD3(動画プロンプト)だけでした。27Bは3/3、Flash Nextは1/3です。D3は、長いガイドラインの書式ルールを十数個同時に守らないと通らない、今回いちばん条件の多いタスクです。ほかのタスクは、中身の質でFlash Nextがわずかに上回っています(6タスク中5タスク)。全体の地力はFlash Nextがやや上、同時に守る条件が多いタスクではDenseが勝つ。 上の整理と矛盾しない結果でした。
注意の作りの違いも、効いている可能性があります。Flash Nextの注意の層は、1回に参照する範囲を絞る方式で、公式の説明では上限が2,048トークン分です。27Bは、文書全体を見る通常の注意です。D3のように、長い資料の離れた箇所を何度も突き合わせる作業では、全体を見るほうが有利になり得ます。ただし、これは今回は確かめていない仮説です。
割り引いて見るべき点
- 量子化が違います。 27BはQ6_K(1パラメータ約6.6ビット)、Flash NextはIQ4_XS(約4.3ビット)です。量子化編では、Flash NextはIQ4_XSの17/21から、IQ3_XXSで14/21、IQ1_Sで11/21と、ビットを減らすほど落ちました。同じ精度で比べれば、Flash Nextがもう少し上に出る可能性があります。Qwenの公表値でも、Flash Nextは全項目で27Bを上回っています
- 各タスク3回です。 D3の3/3対1/3にも、揺らぎが含まれます
知識の量は総パラメータ、考える力は1トークンあたりの計算。判断の材料を全部渡す日常タスクでは後者が効きやすいので、23GBのDenseが、総パラメータ4倍以上のMoEに並んだ。これが、今回の結果のいちばん素直な読み方だと思います。
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| OSSのエージェント基盤を探す依頼と条件(個人で自由に使えるライセンス、ソース公開、マイナーは除外)、手作業になるものは後回しにする方針、3つのダウンロードの許可 | 候補の調査、3つの入手(ハッシュ値の照合)と設置、自動化のスクリプト、偽のサーバーでの配線の確認 |
| Dense/MoE比較の発案、RTX 5090で精度だけを比べる方針、量子化(Q6_K)とCodex CLIでも回す判断、最良のハーネスが割れたときに両方で回す判断、OpenHandsの回し直しの了承 | 147回の無人実行・回収・判定、中継の不具合の特定と修正(自分で作った中継の不具合)、LM Studioのログの解析 |
| GALLERIA側の準備(モデルのダウンロード、LM Studioの公開設定とトークンの発行、ファイアウォール) | ルーブリック採点(タスクごとに採点役のサブエージェントを1体ずつ立て、全条件を同じ採点役が採点)、REPORT、この記事の下書きと図 |
| この記事のレビュー |
正直、気になっていること
- 各タスク3回です。 OpenHandsの14→11のとおり、±3本はハーネスの差として読めません。ハーネスの順位は、参考程度に見てください
- 中身の質(ルーブリック)はClaude Codeの採点役によるもので、私は中身を確かめていません。 27Bの採点では、Claude Codeが同じ世代の参考としてFlash Nextの過去の採点を採点役に渡したため、1項目で最大0.25点ほど甘めになり得ます
- 27Bの実行は別の機械です。 GALLERIAの27Bは毎秒約84トークン(読み込み込みの中央値)で、EVO-X2のQwen3.6(約57)より速く、25分の打ち切りの効き方が緩くなっています。27Bは打ち切り0回・最長634秒だったので、結果への影響は小さいと見ています。GALLERIAのLM Studioでは投機的デコード(先読みで速くする仕組み)が有効でしたが、これは出力の中身を変えない仕組みです
- ハーネスの設定は、ほぼ既定のままです。 OpenHandsの300秒の見切りも、そのまま使いました。遅いローカルモデルに合わせて延ばせば、結果は変わるかもしれません。OpenCodeの出力上限(16,384トークン)はClaude Codeが決めた値で、D2の1回はこれに当たって終わっています
- OpenHandsの最初の21回(14/21)は、不具合のある中継での数字です。 見捨てられた生成が次のタスクの時間に食い込んだため、所要時間も膨らんでいます。合否は各回の成果物で決まるので、参考値として残しました
- 判定器には限界があります。 害のある修正案を「的中」と数えたり、話者のIDを読み取り範囲の外で見落としたりしました。判定器は変えていません
まとめ
- Qwen3.6 35Bでは、ハーネスを5つ替えても合格8〜14/21。±3本は揺らぎの範囲で、中身の質はClineが最上位
- Qwen3.8 27B(Dense)に替えると、Codex 19・OpenHands 19・Cline 20。3つのハーネスで、同じ向き・ほぼ同じ幅で伸びた
- 同じ世代のDense(27B、23GB)とMoE(Flash Next、88GB)はほぼ互角。効いたのは、DenseかMoEかより世代
- MoEの総パラメータは主に知識の幅に、1トークンで使うパラメータは考える力に効く。資料を全部渡す日常タスクでは後者が効きやすく、1トークンで27B全部を使うDenseが、約6Bを使うMoEに並んだ
- 長考の暴走や「です・ます調」の取りこぼしは、ハーネスを替えても出るモデル側の癖。ハーネスで違うのは、長考が止まらないときの止まり方
- OpenHandsは返答をまとめて受け取り、300秒で見切って出し直す。LM Studioとの間に中継を挟むなら、切断を上流へ伝える作りにしておく
これからの使い方
前回の最後に「Qwen3.8 Flash NextをClineで回したら、ローカルでも20本に届くかもしれない」と書きました。Flash Nextではなく同じ世代の27Bでしたが、Clineで20/21に届いています。
とはいえ、RTX 5090は、これからもLoRAの学習や動画生成に優先して使う予定です。日常使いのローカルLLMサーバーにするつもりはありません。なので、170万円の自宅AI環境での運用は、こう考えています。
- 普段は、EVO-X2でMoEのモデルを使う。 Qwen3.6 35BのようなMoEは、EVO-X2でも実用的な速さで動きます。合格はハーネス次第で21回中8〜14回なので、任せられる範囲で使います
- ここぞという時は、RTX 5090でDenseの27Bを動かす。 多くの条件を同時に守らせたい作業や、失敗できない作業は、こちらに回します
ハーネスより、モデル。分かってみれば当たり前ですが、147回回して数字で見ると、納得感が違います(笑
コメント