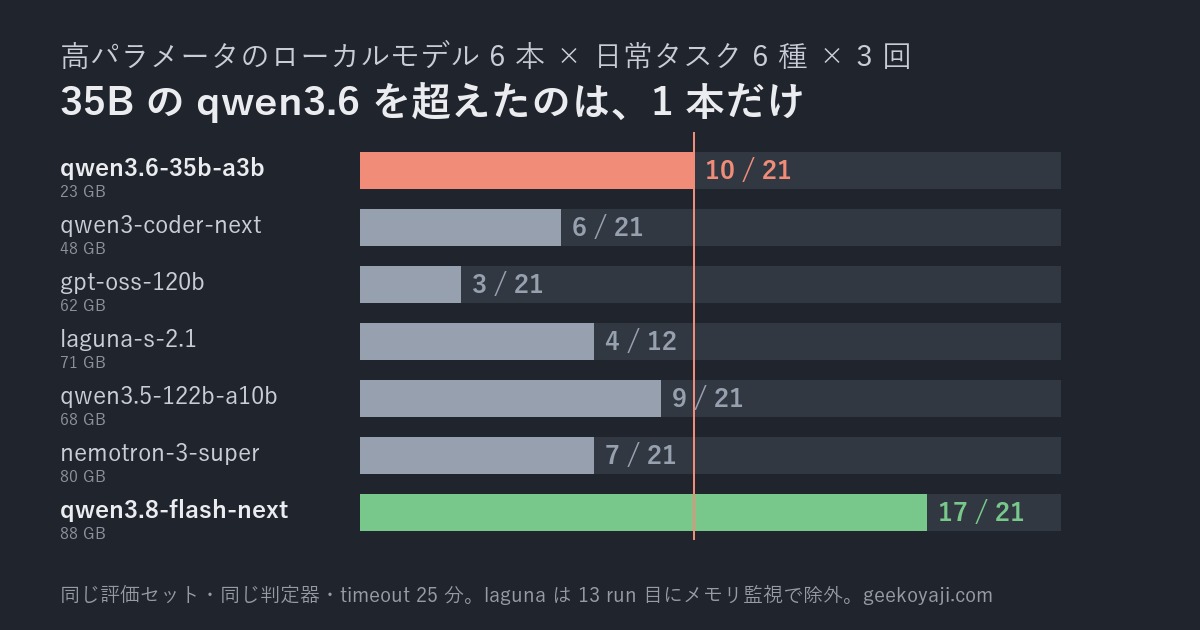
前回、6本の高パラメータモデルを日常タスク6種で走らせて、35BのQwen3.6を超えたのはqwen3.8-flash-nextの17/21だけでした。ただし18 tok/sで1タスク11分、空きメモリは6.6GB。「精度は使えそうだが、速度とメモリで使えない」という結論で、記事の最後にこう書きました。
Qwen3.8の量子化版が、使えないレベルまで精度を落としたら。170万円かけた自宅AI環境の片翼、EVO-X2の価値に疑問符が付きます。量子化版には頑張ってほしい。
やりました。同じqwen3.8-flash-nextの量子化を2段落として(IQ4_XS → IQ3_XXS → IQ1_S)、同じ6タスク+起動確認を3回ずつ。2本で合計42回、9時間半。
先に結論を書きます。
- 17/21 → 14/21 → 11/21。 IQ3_XXSは判断の質がほぼ変わらないまま「作法」の細部で落ち、IQ1_Sは「終われない」(タイムアウト7回)
- 速度は+8%と+13%しか上がらず、メモリの逼迫も変わりませんでした。 前回「計算上IQ3_XXSで26 tok/s、IQ1_Sで50 tok/s」と書いたのは私の見積もりの誤りで、この記事で訂正します
- そのうえで、EVO-X2+ローカルLLMは、エージェントの基盤として使うにはまだ早い、と結論します。EVO-X2に出番がないという意味ではありません。使いどころは後半で書きます
まず、結果をどうぞ
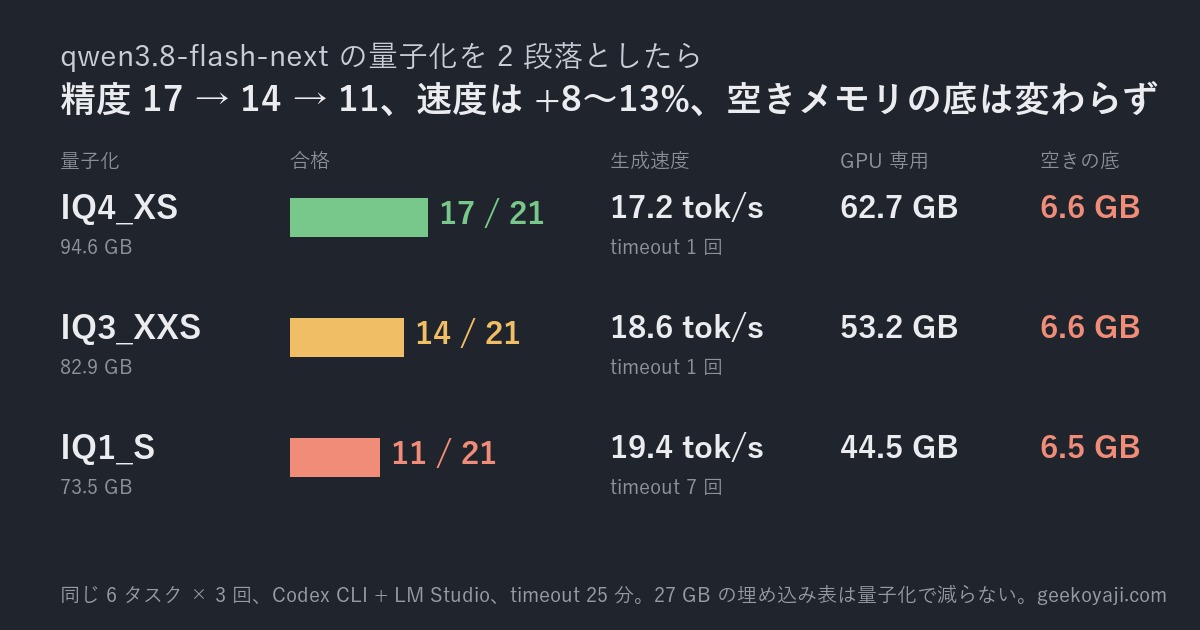
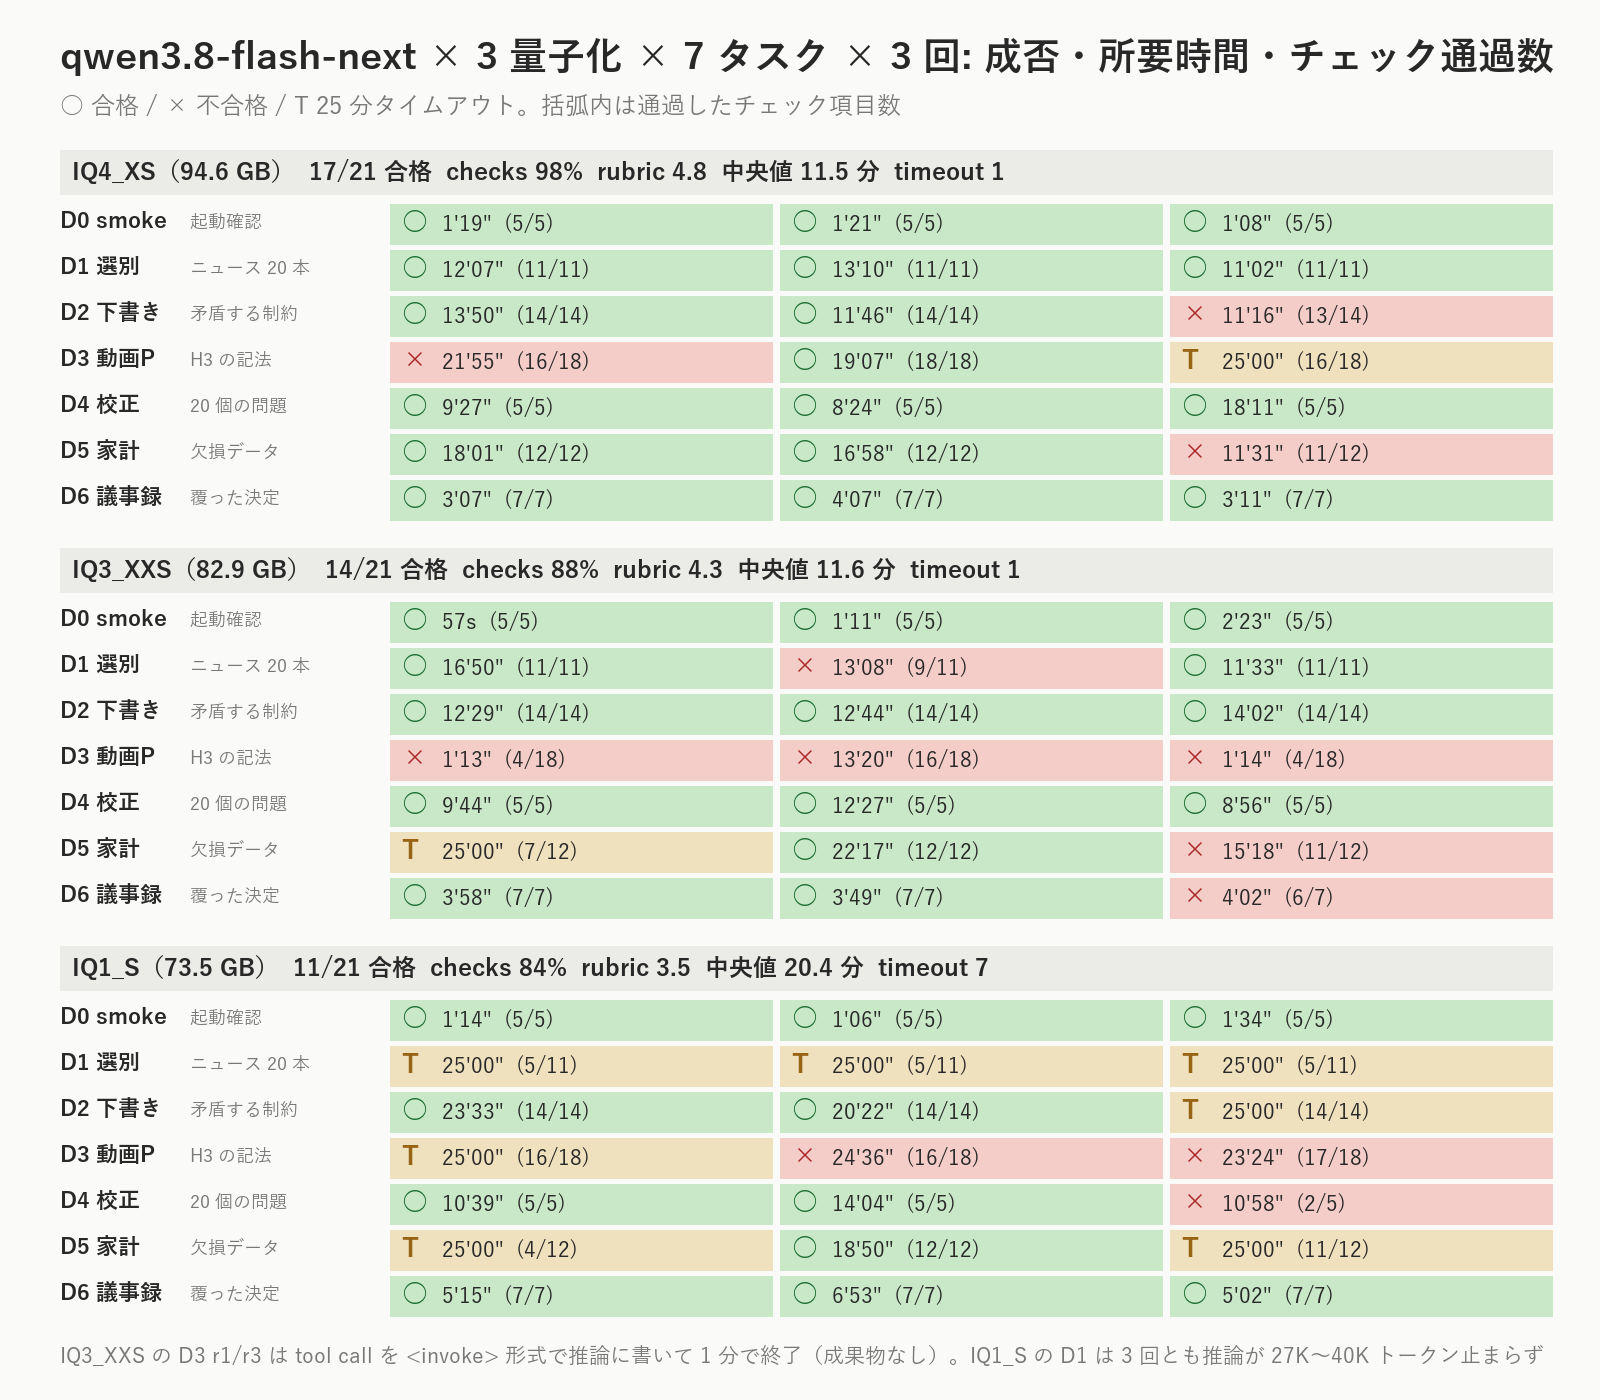
| 量子化 | ファイル | 合格 | チェック通過率 | rubric平均 | 1タスク中央値 | タイムアウト | 生成速度 | GPU専用 | 空きの底 |
|---|---|---|---|---|---|---|---|---|---|
| IQ4_XS(前回) | 94.6GB | 17/21 | 98% | 4.8 | 11.5分 | 1 | 17.2 tok/s | 62.7GB | 6.6GB |
| IQ3_XXS | 82.9GB | 14/21 | 88% | 4.3 | 11.6分 | 1 | 18.6 tok/s | 53.2GB | 6.6GB |
| IQ1_S | 73.5GB | 11/21 | 84% | 3.5 | 20.4分 | 7 | 19.4 tok/s | 44.5GB | 6.5GB |
条件は前回と同じです(Codex CLI + LM Studio、Context 64K、Thinking有効、25分制限、モデルは1本ずつロードしてメモリを監視)。LM Studio側の各種パラメータも、検証済みのIQ4版に揃えました。
訂正:「量子化すれば速くなる」の見積もりが甘かった
前回、私は「1トークンで読む重みのバイト数÷実効帯域」で速度が決まる、と書きました。それ自体は正しかったのですが、量子化を落としたときのバイト数を「名目のビット幅に比例して減る」と見積もったのが間違いでした。GGUFファイルのヘッダを読んで、部位ごとに数え直しました。
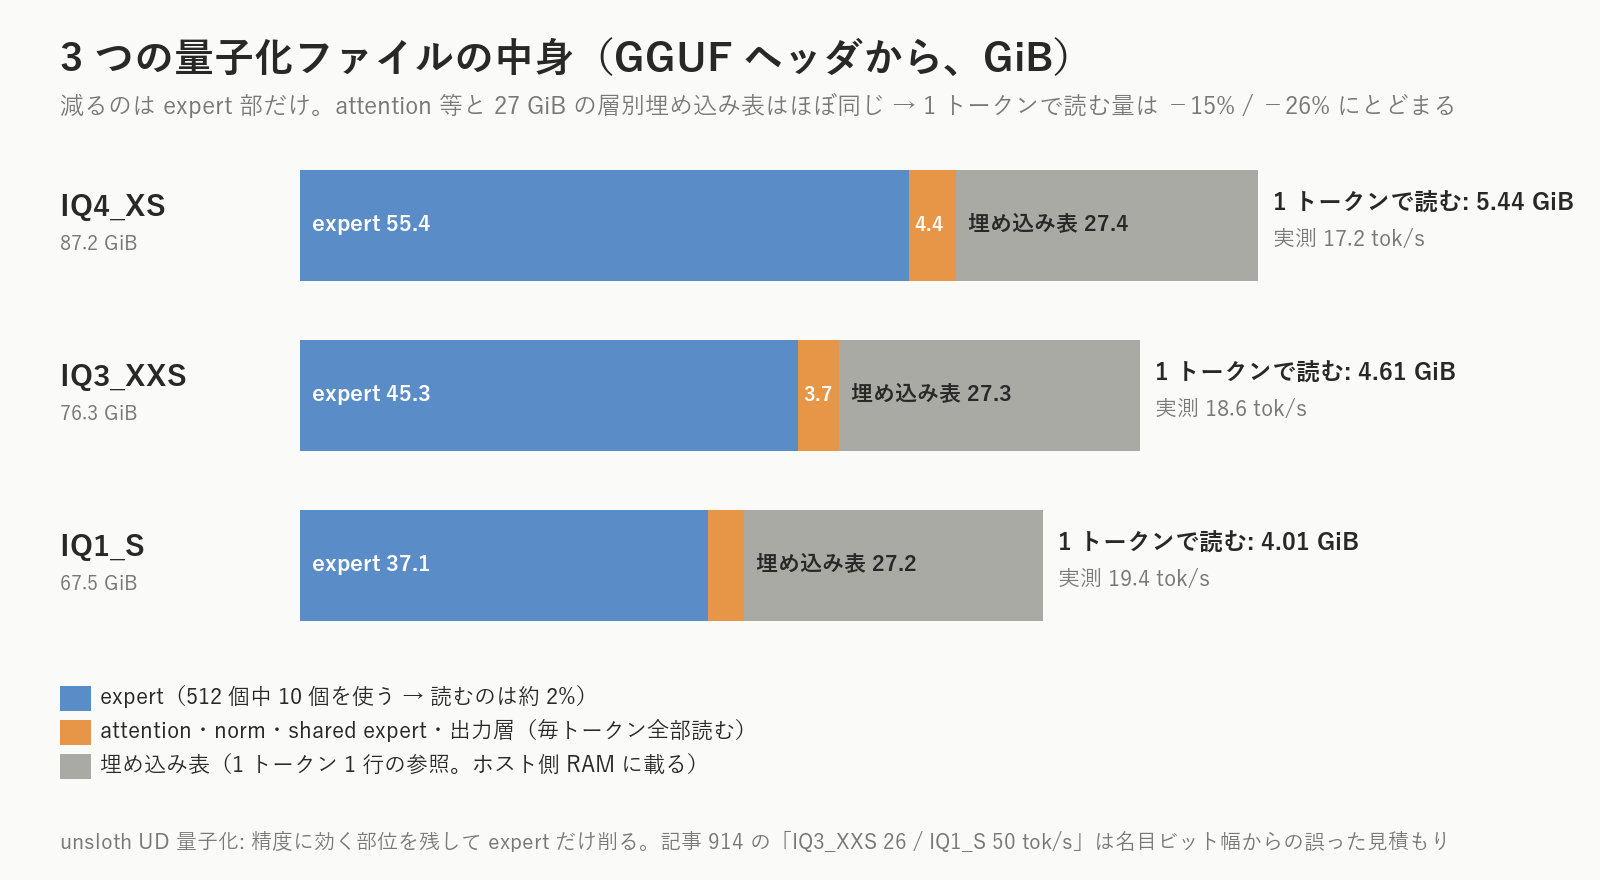
| 量子化 | ファイル全体 | expert部 | attention等(毎トークン読む) | 埋め込み表(1行だけ参照) | 1トークンで読む重み | 予測 | 実測 |
|---|---|---|---|---|---|---|---|
| IQ4_XS | 87.2GiB | 55.4GiB | 4.36GiB | 27.4GiB | 5.44GiB | 17 tok/s | 17.2 |
| IQ3_XXS | 76.3GiB | 45.3GiB | 3.73GiB | 27.3GiB | 4.61GiB | 20 tok/s | 18.6 |
| IQ1_S | 67.6GiB | 37.1GiB | 3.29GiB | 27.2GiB | 4.01GiB | 23 tok/s | 19.4 |
unslothの「UD」量子化は、精度に効く部分(attention、正規化、共有expert、埋め込み)を高精度のまま残して、expertだけを削る作りになっています。だからファイルは94.6→73.5GBと2割減っても、毎トークン読む量は26%しか減らない。しかも実測は予測にも届きませんでした。コンテキストが伸びるほどKVキャッシュの読み出しが効いてくるからで、IQ1_Sは後述のとおり長考でコンテキストが40〜50Kに達する回が多かった。
メモリも同じ理屈です。空きメモリの底が6.6GBで動かなかったのは、システムRAM側に載る27GBの埋め込み表が3つとも同じサイズだから。GPU専用枠の使用量は62.7→44.5GBと18GB減りましたが、統合メモリ機なので、これを活かすなら専用枠を64GBから32GBに減らしてシステム側を96GBにする配分に変える手はあります(置き場所で速度が変わらないことは前回確かめました)。ただ、そこまでして得られるのが「精度の落ちた量子化版でメモリに少し余裕が出る」だと、私は使う気になれません。
IQ3_XXS(14/21)— 判断は同じ。作法が崩れる
中身を見ると、判断の質はIQ4_XSとほぼ変わりません。
- D2 ブログ下書き 3/3。矛盾する字数指定を
questions.mdに整理して「質問して止まると記事が完成しないため仮定を置いた」と明記し、1,996〜2,173字で書き切る。IQ4_XSは2/3だったので、むしろ上 - D4 校正 3/3。1回目は20個の問題を全部拾いました(recall 1.00、precision 0.95)。この評価セットで初めてです
- D6 議事録 2/3。決定8件・アクション4件は3回とも全部正解。落ちた1回は「公開日は11月15とする」と「日」が抜けた脱字で、判定器が決定を照合できなかっただけ
- D1 ニュース選別 2/3。落ちた1回は上位5本が理想解・要約64〜72字・注入記事は2点と、中身は完璧。ただ末尾に「## 補足」という6個目の見出しを足して、「5項目」の指定を破った
つまり落ちた7回のうち4回は、脱字・余計な見出し・7月欠損の言及漏れ・凝りすぎてタイムアウト、という「あと1点」です。
残り3回がD3(動画プロンプト)で、ここにIQ4_XSでは一度も出なかった新しい壊れ方が出ました。
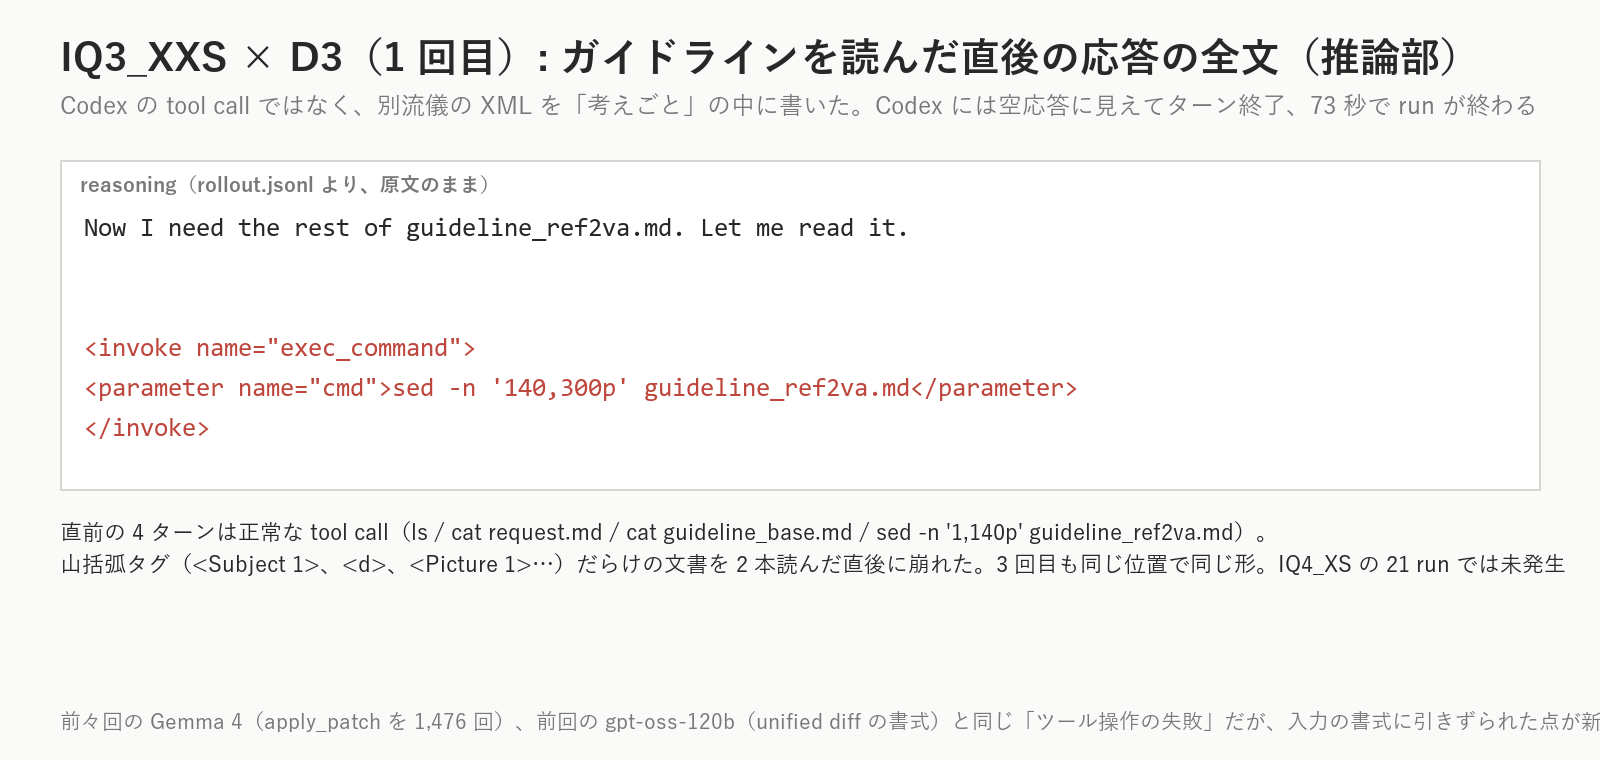
前々回のGemma 4は、ファイル編集ツールの書式を間違え続けて1,476回つぶやきました。前回のgpt-oss-120bは、unified diffの書式で書いてはねられ続けた。今回のIQ3_XXSは、読んだ文書の書式に引きずられて、ツール呼び出しの作法そのものを取り違えた。3回中2回、同じ場所で。IQ4_XSの21回では一度も起きていないので、量子化で最初に削れたのは「判断」ではなく「作法を守る安定性」だった、と私は読んでいます。
IQ1_S(11/21)— 終われない
IQ1_Sは、精度が落ちたというより、終われなくなりました。タイムアウトが7回。IQ4_XSとIQ3_XXSは1回ずつです。
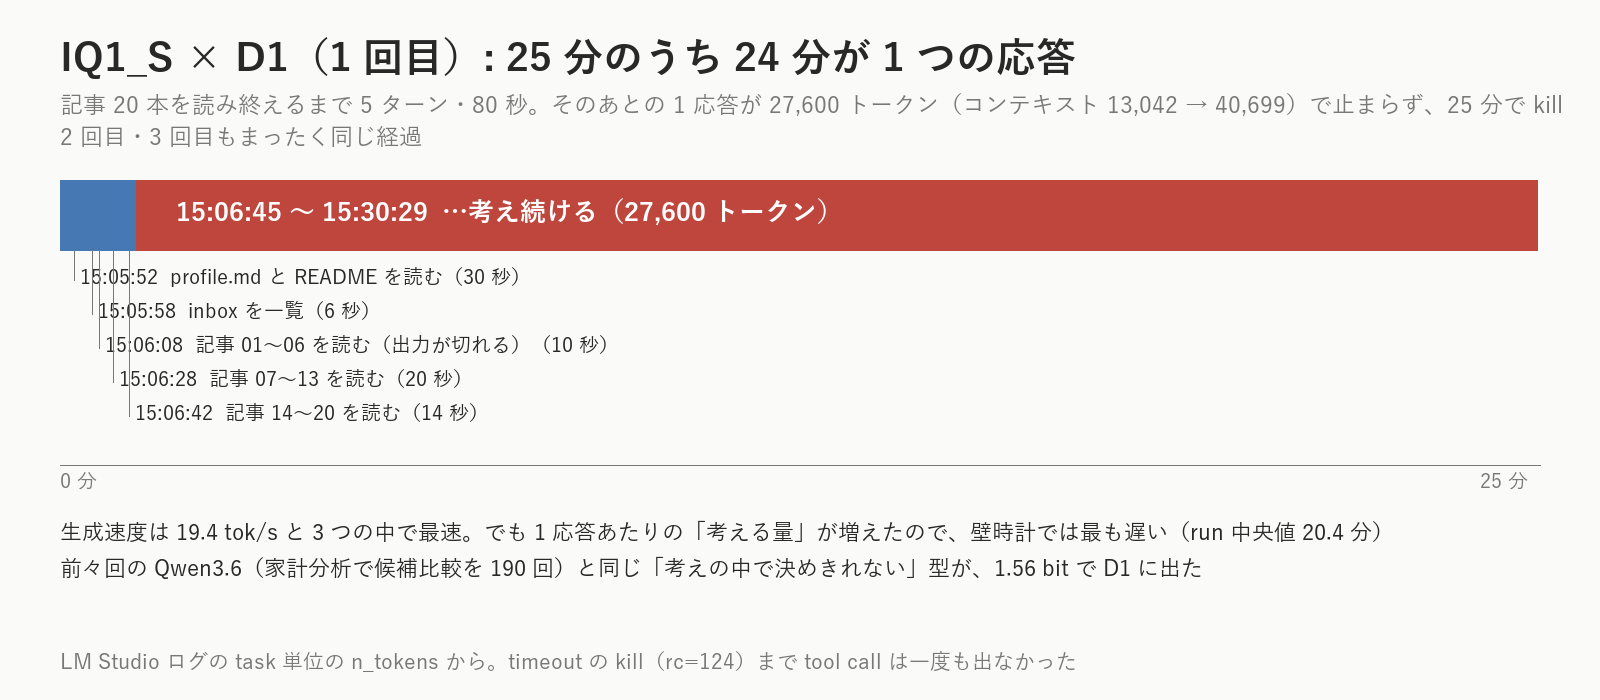
- D1 ニュース選別 0/3。3回とも、記事20本を読んだ直後の1応答が27,000〜40,000トークン止まらず、成果物ゼロ。前々回のQwen3.6が家計分析で候補比較を190回繰り返したのと同じ、「考えの中で決めきれない」型です
- D2 ブログ下書き 2/3。3回とも14項目中14の原稿を書きました。ただし1回は書き終えたあとも確認を続けて25分超。合格した2回も20〜24分
- D3 動画プロンプト 0/3。中身は18項目中16〜17まで届いているのに、3回とも23〜25分
- D4 校正 2/3。2回はrecall 0.95と0.90で、離れた行の矛盾も2/2。3回目は「基準と原稿を対照しました。他の問題をCSV化します」と宣言して終了。CSVはありません。前々回に名前をつけた「次にやることを言って止まる」パターンです
- D6 議事録 3/3。3回とも7項目中7。302〜413秒。抽出・構造化は1.56bitでも崩れませんでした
- そして、簡体字が混じりました。家計分析のスクリプトに「回线」(回線)、レポートに「リスク覆盖」(カバー)。前回qwen3-coder-nextで見た型です
生成速度は19.4 tok/sで3つの中で一番速いのに、生成トークンの合計は295K(IQ4_XSは211K)。考える量が増えて、壁時計では一番遅くなった。
判定器のこと
判定器は今回も2か所直しました。数値の忠実性チェックが、実験メモの数値から計算した派生値(「厚さ1.0mmと1.5mm、この0.5mmが効くのか」「3枚まとめて4,040円」)を幻覚扱いしていたので、メモにある2つの数値の和・差・比を派生値として許容する形に。もう1つは、家計分析で「保険を死亡保障と医療保障の基本プランのみに縮約」と書いた行を、対象外カテゴリ「医療」に触れたと誤判定していたので、カテゴリ列だけを見るように。合否が反転したのは3件で、いずれも判定器側の誤検出でした。前回までのモデルの合否は変わっていません。
結論:EVO-X2+ローカルLLMは、エージェント基盤にはまだ早い
正直に書きます。今回の結果で、私の中では一区切りつきました。
- 量子化モデルは精度が下がるし、速度も大きくは上がらない。 メモリに若干余裕が出るメリットはあるが、精度低下を許容できるほどではない。IQ3_XXSは「使える寄り」に見えますが、IQ4_XSより劣化しているのは確かで、本来のエージェント的な処理は今回のテスト項目のような処理が連鎖します。処理時間はさらに延び、End-to-Endの精度は十分に出ないと思います
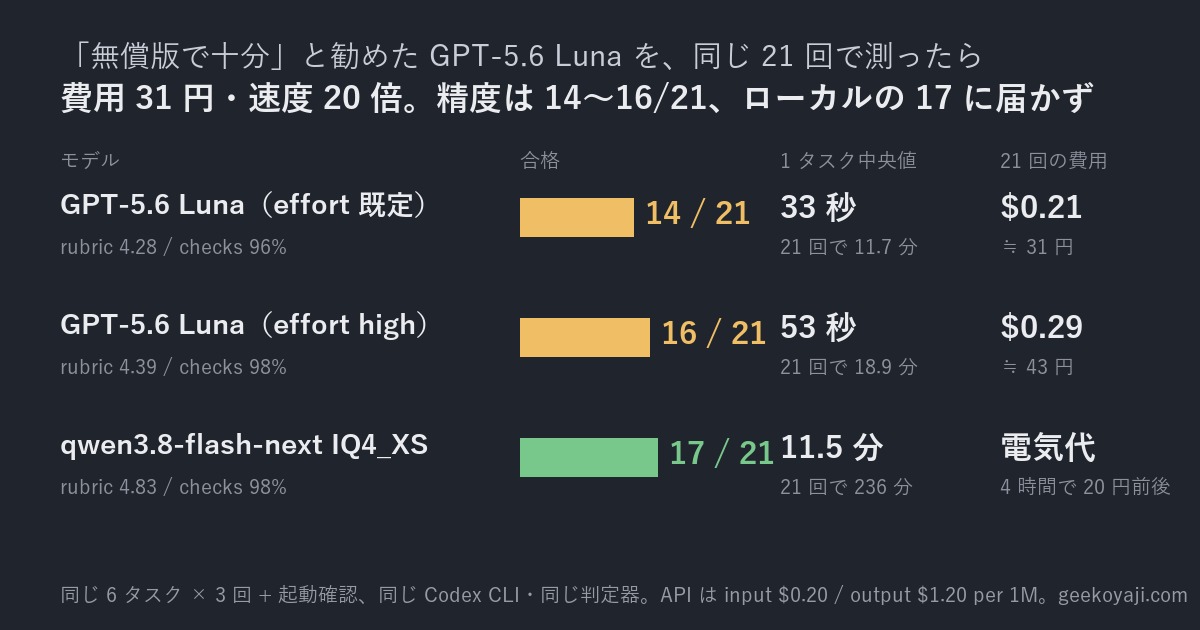
- コスパの観点で考えるなら、無理に128GB統合メモリ機でローカルLLMを使うより、ChatGPTの無償版を使うほうが現実的です。 2026年8月からFree/Goプランの既定モデルがGPT-5.6 Lunaになり、テキストのチャットは回数無制限(ファイル添付や画像生成などのツールには上限が残ります)。APIでもLunaは入力$0.20/出力$1.20(100万トークンあたり)と安い。読者の皆さんにも、まずそちらを勧めます(Lunaの性能は後日、同じテストで検証します)
- Qwen3.8より少し軽くて高精度なモデルが出てくれば、話は変わります。 私はそれを期待しています。現状この筐体に載る中で、Qwen3.8 Flash Nextより軽くて高性能なモデルは見当たらないので、新しいモデルの登場を待つことになる。ある程度は想定していたことです。実務ではClaudeを並行して使っているので困りません
- 私は好きでこういうことをやっています。実用レベルと言えなくても、いじり倒すのが楽しい
じゃあ、EVO-X2に出番はないのか
そうでもありません。使いどころはあります。
- パブリックなAIエージェントに出せないデータを、ローカルで処理したいとき。 家計簿、健康記録、日記、仕事の未公開資料。今回の評価で、抽出・構造化・校正はQwen3.8なら3回とも通り、35BのQwen3.6でも校正と議事録は通りました。1件11分でも、外に出せないものは外に出せない
- パブリックなAIエージェントのコンテンツフィルタで拒否されうる処理。 小説でより幅広い表現を使う、政治や宗教の話題を扱う。フィルタを外したローカルLLM(いわゆるUncensoredモデル)なら扱えることがあります。ただし注意点があります。 そういうモデルをチャットに使うのはよいとして、PCのシェルやファイル操作を伴う処理には使わないことを強く勧めます。 拒否しないモデルに、拒否すべき操作の機会を与えないでください
- 特定用途へのファインチューニング、あるいはフロンティアモデルでハーネスを組んで能力不足を補う。 たとえば動画生成AIのプロンプト作成は、今回のD3そのものですが、処理をステップに細分化し、書式をテンプレート化して、モデルには選択問題を解かせる形にすれば、安定して正解を出せる可能性があります。「ガイドラインを渡して全部やらせる」から「型に流し込ませる」へ
- 夜間の大量バッチ処理。 数千件の文書分類、ログの要約、写真のタグ付け。1件ずつは軽いが量がある仕事は、コストゼロ・レート制限なしのローカルが向きます。寝ている間に終わればいい
- フロンティアモデルの「下請け」。 Claudeをコントローラーにして、機密データを含む部分だけローカルモデルに処理させる分業。前々回・前回で見えた「ツールとの噛み合わせ」の問題は、ツールを呼ぶ側をClaudeにすれば消えます
- LLM以外の生成AI。 TTSではEVO-X2のROCmで動かしました。128GBの統合メモリは、LLM以外でも使えます
私見:Appleの進む方向が正しかった気がする
この結果は、Appleの進む方向性が正しいことの証明になっている気がします。8月25日に発表されたMac Studio M5 Ultraは、統合メモリが最大512GB、帯域は専用GPUなみの1.2TB/s。9月22日発売で、512GB構成は10月下旬、価格は94万9,800円からですが256GBに上げた時点で167万円、512GBは200万円を超える見込みです。それでも、あのレベルなら、ローカルでエージェント的な処理を高精度に、実用的な速度で回せるのではないか。AMDも、Ryzen AI MAXの次世代として噂されるMedusa Halo(2027〜2028年、LPDDR6で460〜690GB/sと言われる)で帯域が大幅に上がる見込みです。今はローカルLLM実用化の初期段階、と考えるのが妥当だと思います。
今回の実験で、この機械の実効帯域は理論値256GB/sの40〜55%でした。同じ効率で1.2TB/sなら480〜660GB/s、qwen3.8-flash-next(1トークン5.8GB)は80〜110 tok/s。11分のタスクが2分前後になります。
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 量子化版2本のダウンロード、LM Studioのパラメータを検証済みのIQ4版に揃える | 識別子(qwen3.8-flash-next@iq3_xxs)の扱いを確認して、1本ずつロード・監視・実行・回収・判定・採点 |
| 記事の結論(この筐体はエージェント基盤にはまだ早い、使いどころ、Apple/AMDの見立て) | GGUFの部位別サイズの算出と、前回の見積もりの訂正。Luna・M5 Ultra・Medusa Haloの裏取り |
| 使いどころの追加案のレビュー、この記事のレビュー | 判定器の修正2件、REPORT、この記事の下書きと図 |
正直、気になっていること
- ルーブリックの採点者はClaude、タスクを作ったのもClaude。私はスポットチェックだけ。この3本の記事を通して同じ構造です
- n=3です。 IQ3_XXSのD3が「2回は1分で崩れ、1回は16/18」のように、同じ設定でも走り方がぶれます
- IQ1_Sの「終われない」は、推論トークンの上限を設ければ救える回があったかもしれません。 ただ、上限をかけて速くなったIQ1_Sを使いたいかと言われると、使いたくない
- Thinking OFFは今回も試していません。 精度が目に見えて落ちるのは容易に予想できるので
- 25分制限は前回と同じです。IQ1_Sには「原稿は14項目中14なのに、書き終えたあと確認を続けて時間切れ」というタイムアウトが1回(D2)ありますが、ルールどおり不合格に数えました
まとめ
- qwen3.8-flash-nextの量子化を2段落として、17→14→11。速度は+8〜13%、空きメモリの底は変わらず
- 量子化で先に壊れたのは判断ではなく、ツール呼び出しの作法(IQ3_XXS)と、推論の止まり方(IQ1_S)。抽出・校正・矛盾への対処は1.56bitまで残った
- 前回の「26 tok/s、50 tok/s」は誤り。UD量子化はexpertしか削らない
- EVO-X2+ローカルLLMは、エージェント基盤としてはまだ早い。 出番は、外に出せないデータ、フィルタの外、型に流し込む処理、夜間バッチ、下請け、LLM以外
- 私はこれからも、新しいモデルが出たら性能検証をしていくし、ファインチューニングも試します
次にやること
コーディング編から数えて4本、42+21+117+42=222回のタスクを回しました。評価セットと判定器はそのまま残してあるので、新しいモデルが出たら同じ21回を回すだけです。Qwen3.8より軽くて高精度なモデルが出たら、真っ先に。
その前に、同じ評価セットをGPT-5.6 Lunaに解かせます。 「無償版で十分」と勧めた以上、同じ物差しで測っておかないと不誠実なので。Codex CLIはAPIキーを渡して -m gpt-5.6-luna と指定すれば動く仕様なので(0.144以降)、ハーネスはそのまま使えるはずです。ローカルの17/21に対して、月額0円のモデルが何点取るか。
ファインチューニングも試したい。そして動画プロンプトの「型に流し込む」ハーネスは、私が毎日やっている仕事そのものなので、これは近いうちに。
量子化版は、頑張ってくれました。私が期待した方向ではなかったけれど、どこが先に壊れるかを、はっきり教えてくれた。
EVO-X2は、まだ手放しません。これからも遊び倒そうと思います(笑
コメント