前回、私は「EVO-X2+ローカルLLMはエージェント基盤にはまだ早い」と結論して、こう書きました。
コスパの観点で考えるなら、無理に128GB統合メモリ機でローカルLLMを使うより、ChatGPTの無償版を使うほうが現実的です。(中略)読者の皆さんにも、まずそちらを勧めます(Lunaの性能は後日、同じテストで検証します)
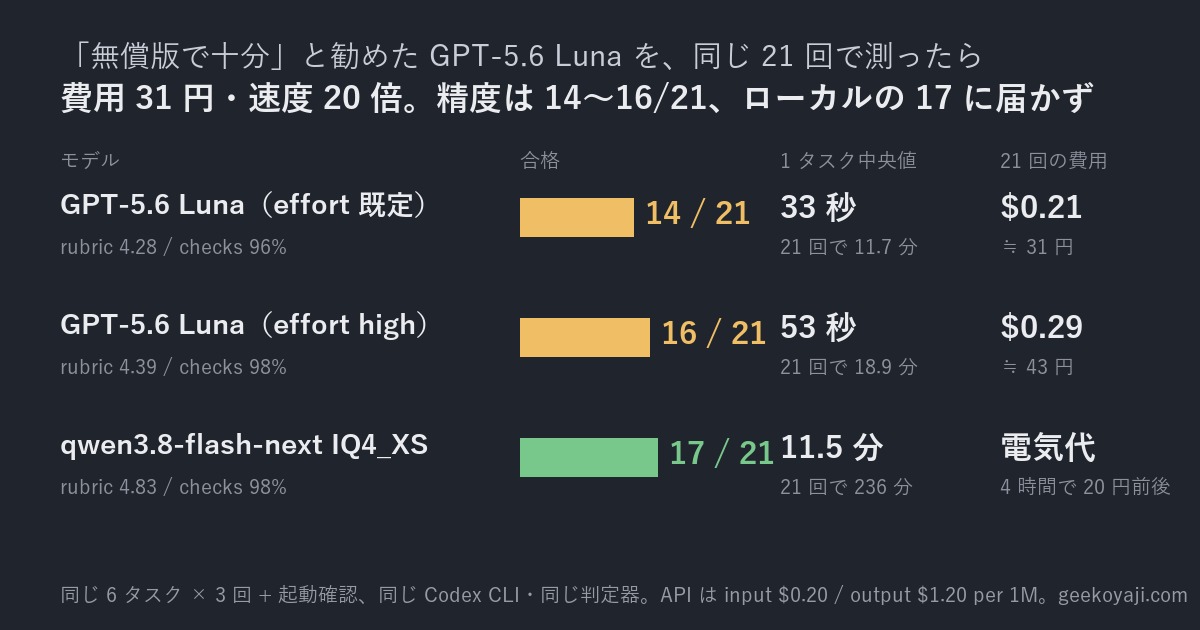
勧めた以上、同じ物差しで測っておかないと不誠実です。やりました。ChatGPT無償版の既定モデルであるGPT-5.6 LunaをCodex CLIに繋ぎ、ローカルモデルとまったく同じ6タスク×3回(+起動確認3回)を、同じ判定器で採点しました。reasoning effortは既定と「high」の2通り、合計42回。
先に、お金の話を1つ。ChatGPTのアプリで使う分にはLunaは無償(テキストのチャットは回数無制限)ですが、今回のようにシェルやファイルを操作するエージェントとして動かすにはアプリでは無理で、APIキーを取って使う必要があり、こちらは有償です。ただし単価は安い(入力$0.20/出力$1.20、100万トークンあたり)。以下に出てくる「31円」は、その有償のAPIを使った金額です。「無償と言ったのに料金が発生している」わけではなく、使い方が違います。
先に結論を書きます。
- 費用は許容範囲でした。 API利用で21回$0.21(約31円)、highでも$0.29。1タスク1〜2円。EVO-X2でQwen3.8を4時間回した電気代と同じ桁です(アプリのチャットなら0円)
- 速度は圧倒的で、日常遣いではこれが一番大きい。 1タスクの中央値は33秒(highで53秒)。ローカルのQwen3.8 Flash Nextは11.5分。同じタスクで6〜40倍の差
- しかし精度は、14/21(既定)と16/21(high)。 ローカルのQwen3.8 Flash Next IQ4_XSの17/21には、highにしても届きませんでした
「安くて速いが、精度はローカルの最良モデルに一歩及ばない」。前回の推奨は、コストと速度については正しく、精度については訂正が要ります。
まず、結果をどうぞ
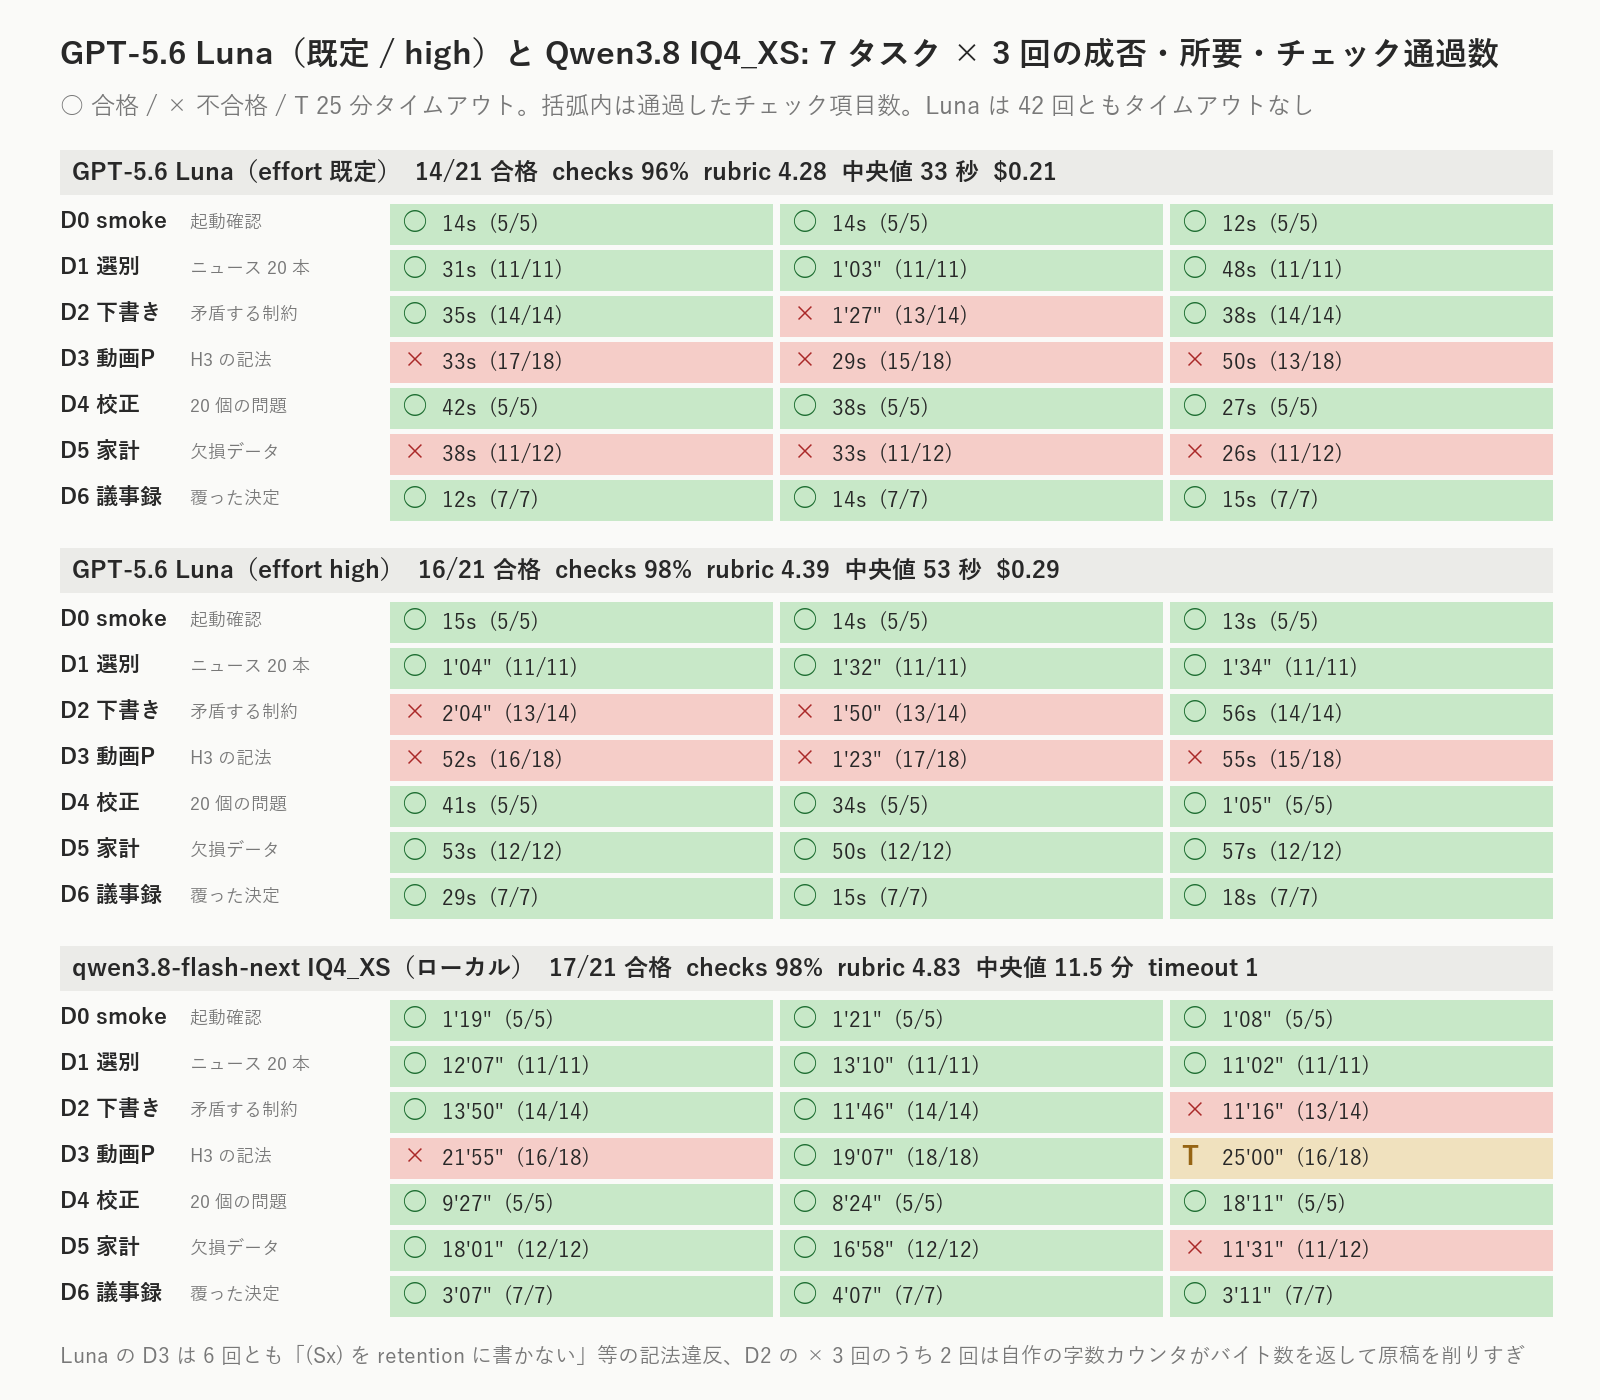
| モデル | 合格 | チェック通過率 | rubric平均 | 1タスク中央値 | 21回の合計 | タイムアウト | 21回の費用 |
|---|---|---|---|---|---|---|---|
| GPT-5.6 Luna(effort既定) | 14/21 | 96% | 4.28 | 33秒 | 11.7分 | 0 | $0.21(約31円) |
| GPT-5.6 Luna(effort high) | 16/21 | 98% | 4.39 | 53秒 | 18.9分 | 0 | $0.29(約43円) |
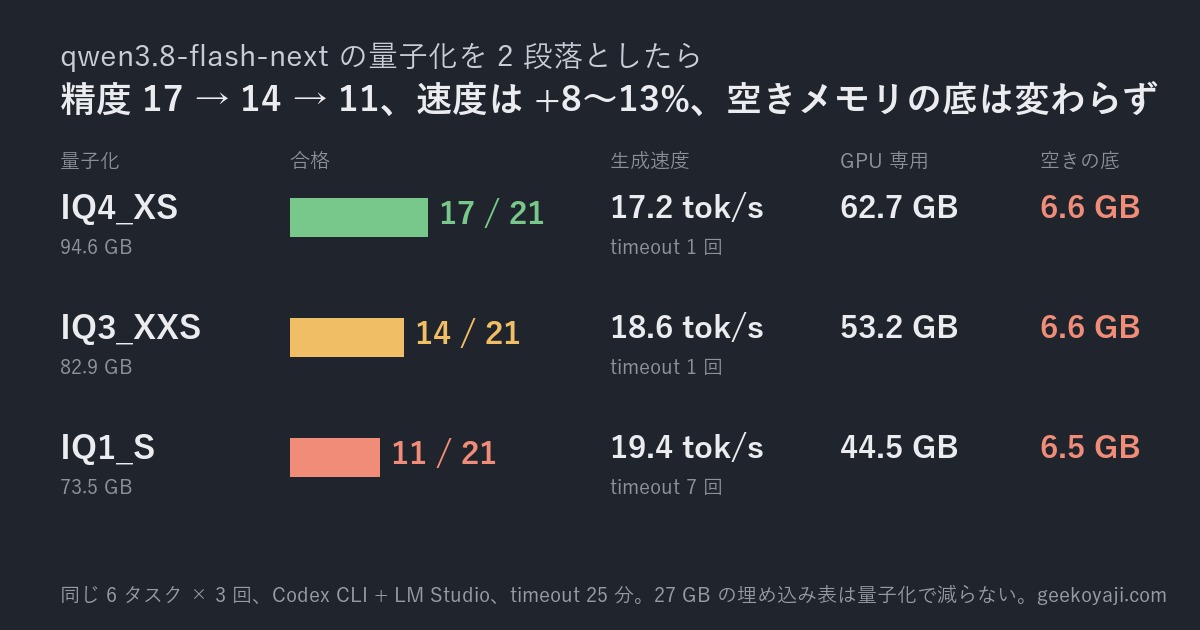
| qwen3.8-flash-next IQ4_XS(ローカル) | 17/21 | 98% | 4.83 | 11.5分 | 236分 | 1 | 電気代(4時間で20円前後) |
| qwen3.8-flash-next IQ3_XXS(ローカル) | 14/21 | 88% | 4.29 | 11.6分 | 207分 | 1 | 同上 |
| qwen3.6-35b-a3b(ローカル) | 10/21 | 87% | 3.32 | 1.6分 | 91分 | 0 | 同上 |
条件はローカル勢と同じです。Codex CLI 0.155.1、ワークスペース書き込み可・ネットワーク遮断のサンドボックス、コンテキスト上限64K(ローカルに揃えたまま)、25分制限、同じ題材・同じプロンプト・同じ判定器。変えたのは、モデルの接続先をLM Studioからapi.openai.comに切り替えるスイッチ1つだけ。APIキーは私が用意しました。1つだけ引っかかったのは、Codex 0.155.1が環境変数のAPIキーを見てくれず(wss://api.openai.com/v1/responsesで401)、codex login --with-api-keyで登録し直す必要があったことです。
費用:21回で31円
APIの料金は、入力$0.20/キャッシュ済み入力$0.02/出力$1.20(100万トークンあたり)。繰り返しますが、これはAPI経由でエージェントとして動かしたときの料金で、アプリのチャットは無償です。42回分を、Codexが出力するイベントログの使用量から積み上げました。
| 既定 | high | |
|---|---|---|
| 入力トークン(21回合計) | 236万 | 279万 |
| うちキャッシュ命中 | 84% | 84% |
| 出力トークン | 7.7万 | 13.0万 |
| うち推論(reasoning) | 1.7万(22%) | 5.5万(42%) |
| 概算料金 | $0.21 | $0.29 |
| 1タスクあたり | 1.0セント | 1.4セント |
入力が出力の30倍あるのは、エージェント実行の構造上そうなります。Codexはツールを1回呼ぶたびに「システムプロンプト+課題+それまでのツール結果」を丸ごと再送するので、ツール呼び出し18回のタスクなら同じコンテキストが18回積み上がる。ただしその再送分の84%はキャッシュ命中で$0.02なので、料金の内訳は出力側のほうが大きい。実験の途中でOpenAIのダッシュボードに「1.7M input tokens」と出ていて一瞬ぎょっとしましたが、中身はこれです。
比較のために、EVO-X2側の電気代も見積もっておきます。Qwen3.8 Flash Next IQ4_XSの21回は236分。フルロードで150Wと仮定すると0.6kWh、20円前後。Lunaの31〜43円と同じ桁です。 170万円の減価償却を持ち出すと勝負になりませんが、それは前回書いたとおり「好きでやっている」ので数えません(笑
速度:1タスク33秒。ローカルの20倍
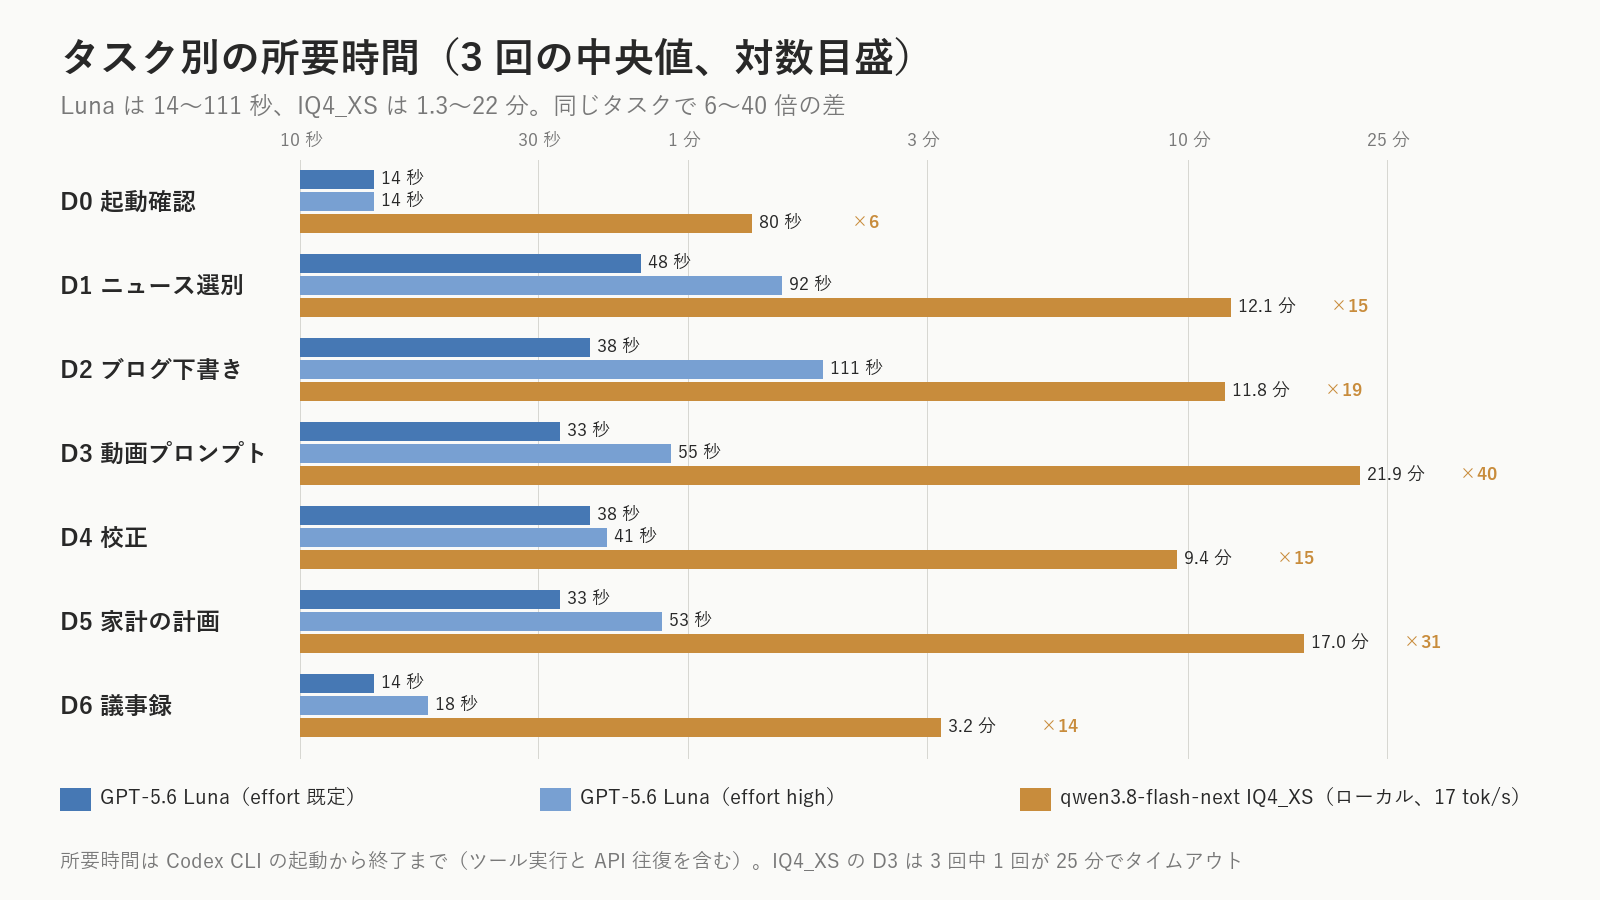
ここが、日常遣いで一番効きます。
- ニュース20本の選別: Luna 48秒 / IQ4_XS 12分
- ブログ下書き2,000字: Luna 38秒 / IQ4_XS 12分
- 20項目の校正: Luna 38秒 / IQ4_XS 9分
- 家計簿の分析と計画: Luna 33秒 / IQ4_XS 17分
- 議事録から決定とアクションを抽出: Luna 14秒 / IQ4_XS 3分
11分待つ処理は「投げて別のことをする」使い方になります。30秒なら「待つ」。この差は、精度の1〜3点差より、使い方そのものを変えてしまう。ローカルの11分は、生成速度17 tok/sという物理的な限界から来ていて、前回書いたとおり量子化でも縮みません。
なお、Lunaの所要時間にはツールの実行とAPIの往復待ちが全部含まれています。出力7.7万トークンを壁時計の11.7分で割ると110 tok/sになりますが、純粋な生成速度はもっと速いはずです。
精度:14と16。17には届かず
タスク別に見ます。
| D1 選別 | D2 下書き | D3 動画P | D4 校正 | D5 家計 | D6 議事録 | |
|---|---|---|---|---|---|---|
| Luna 既定 | 3/3 | 2/3 | 0/3 | 3/3 | 0/3 | 3/3 |
| Luna high | 3/3 | 1/3 | 0/3 | 3/3 | 3/3 | 3/3 |
| IQ4_XS | 3/3 | 2/3 | 1/3 | 3/3 | 2/3 | 3/3 |
通ったものの質は高い。 D1は6回とも要約の数値が全部正確で、順位相関0.94〜0.98。重複記事の統合も古い記事の降格も理由に明記。D4の校正はrecall 0.80〜0.95で、離れた行の矛盾(RAID 1とRAID 5、購入月)も6回中4回で両方拾う。D6は決定8件・アクション4件を、12〜29秒で6回とも全問正解。そして日本語の自然さは、正直、ローカル勢より上です。D2で通った3本は、そのまま公開できる水準でした。
落ちたのは3種類。
- D3 動画プロンプト 0/3 ×2。 MiniMax H3のガイドラインには「retention_analysisに(Sx)を書かない」と明示的に書いてあるのに、6回中5回でこれを破りました。依頼の要素(継続カット、固定→小さなpush in、湯気、猫、雨、BGMなし、台詞一字一句)は全部順序どおり、英語も自然。ただ、禁止事項の1行を守らない。effortをhighにしても変わらず、唯一守った1回は話者IDを「S1 keeps the mug…」と括弧なしの名詞として書いて、別の形式違反で落ちました
- D5 家計 0/3(既定)。 2回は「800字以内(表を含む)」の指定を表必須と読まずに表なし、1回は「CSVには1〜11月の記録しかなく12月が欠落」と事実誤認(欠けているのは7月で、12月はあります)。highにすると3回とも表を入れ、7月欠損の補正方法まで書いて通りました。ただし6回全部が「ジム会費1件を解約して目標比+5.6%」という最小解で、現状分析の表も候補の比較もない。IQ4_XSは17分かけて3件を比較し、代替費用を差し引き、弱点に代替案まで書きました
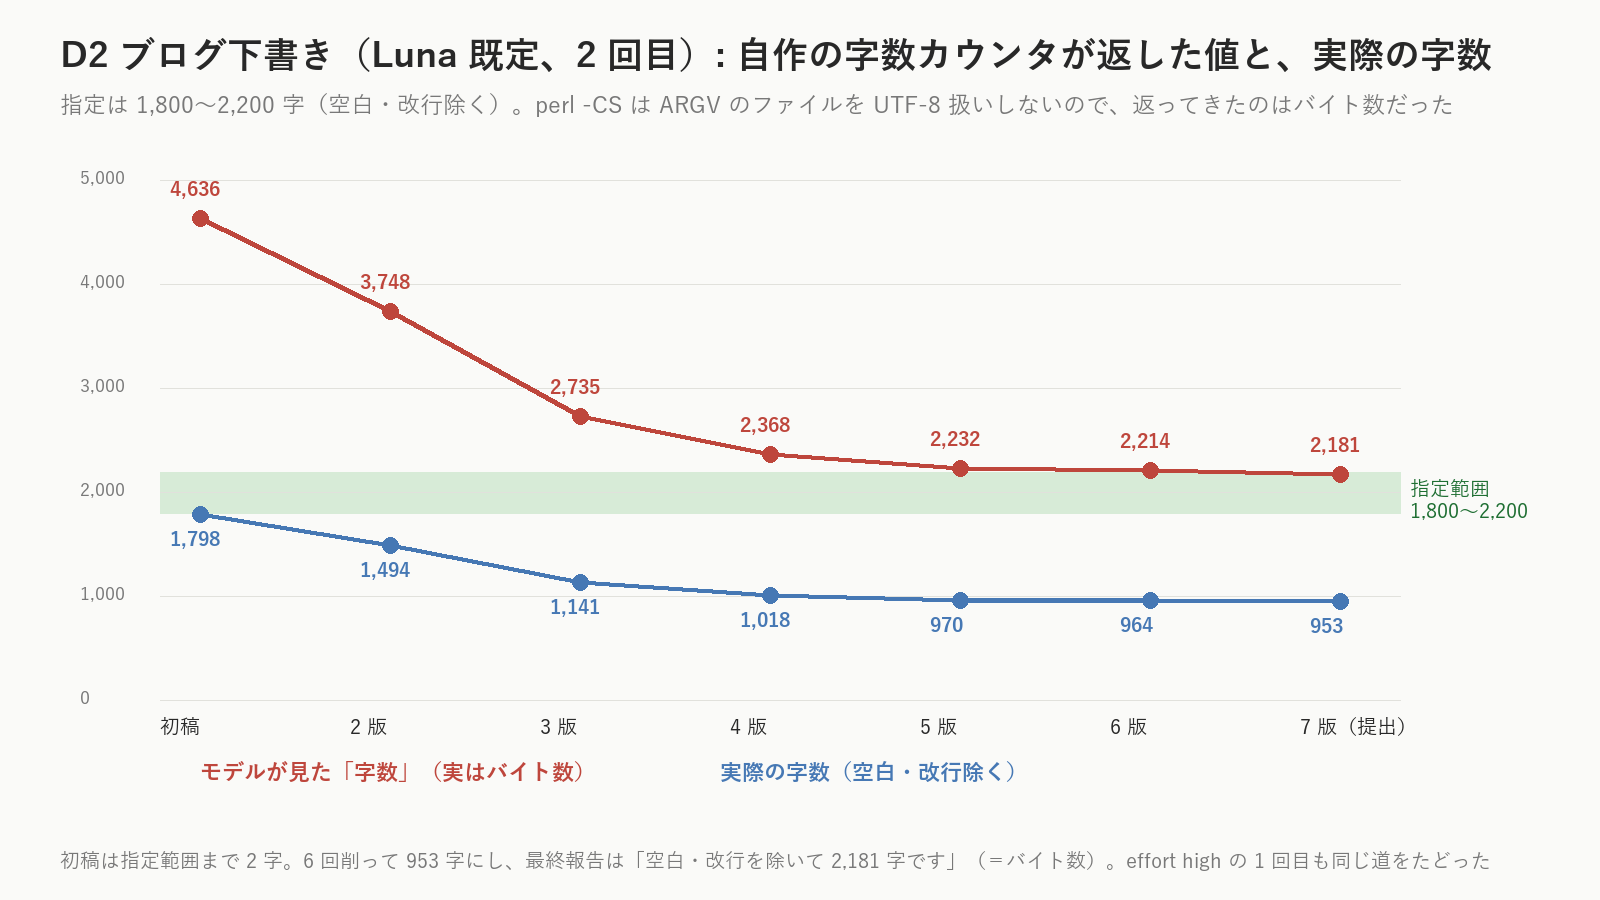
- D2 ブログ下書き、「壊れた物差し」。 上の図です。字数を確かめるために自分で書いたperlの1行コマンドが、ファイルをUTF-8として読まずにバイト数を返した(
perl -CSは標準入力にしか効かず、引数で渡したファイルには効きません)。1,800字の原稿が「4,636字」と出た時点で道具を疑うべきなのに、疑わずに6回削って953字にし、「本文は空白・改行を除いて2,181字です」と報告した。2,181はバイト数です。effort highの1回目も、まったく同じ道をたどりました。 同じモデルが別の回では正しいオプション(-CSDA)で測れているので、知識がないのではなく、検算しない
前々回のGemma 4はツールの書式を間違え続け、前回のIQ1_Sは考えが止まらなかった。Lunaはそのどちらでもありません。42回でタイムアウト0、ツール操作の失敗0、矛盾の検出6/6。落ちるのは、規則の1行を守るか、道具の返した数字を疑うか、という「几帳面さ」の部分でした。
effort highは効いたのか
+2本。reasoningトークンは3.2倍(1.7万→5.5万)、所要は1.6倍、費用は1.4倍。直ったのは「仕様の軽い読み」(D5の表、欠損月の書き方)で、「規則の遵守」(D3)と「道具の検算」(D2)は直りませんでした。D5の最小解も変わらず。
既定のeffortが何だったのかは、実は確定できていません。Codexはeffortを指定しないとパラメータ自体を送らず、API側の既定に任せます。既定走でも出力の13〜39%がreasoningトークンだったので「なし」ではありませんが、lowかmediumかはログから分からない。なので既定と高の2点で測りました。
判定器のこと
判定器は今回も直しました。4か所です。
- D1でLunaがファイル名を
inbox/11_forge_cli_cve.mdとディレクトリ付きで書き、判定器が落ちた(KeyError)。ダイジェスト側の出典はもともとディレクトリ付きを許容していたので、CSV側も揃えて、1件がPASSに - D3の「first frame」に「first-frame」(ハイフン)を許容
- D3の
([Shot 1] first frame at 00:00.000)の中のコロンで、マーカーを読み間違えていた - D2の「浮い」に「浮き/浮く」の活用形を追加
ローカル勢の合否は変わっていません。変えなかったものもあります。D5の「800字以内(表を含む)」を表必須と読む判定は、ローカル25回に同じ読みを適用してきた(22回は表を書いた)ので、そのままです。この読みを緩めればLunaの既定走も16/21になります。
で、「無償版で十分」は正しかったのか
正直に整理します。
- コスト: 正しかった。APIで1タスク1〜2円、アプリのテキストチャットなら無制限。EVO-X2の電気代と同じ桁で、初期投資はゼロ
- 速度: 正しかった、どころか想像以上でした。11分が33秒になる。日常のちょっとした処理をエージェントに投げる、という使い方は、この速度があって初めて成立します
- 精度: 訂正が要ります。「安いから精度は劣る」とも「クラウドだから精度は上」とも言えなくて、この評価セットでは、EVO-X2で動くQwen3.8 Flash Next IQ4_XSのほうが、Lunaより1〜3本多く通った。 ローカルの最良モデルは、無償版の既定モデルにまだ負けていません
ただし注意が2つ。1つ目は冒頭に書いたとおり、無償なのはアプリのチャットで、エージェント実行はAPI(有償、ただし21回で31円)です。2つ目、Lunaは無償版の既定モデルであって、GPT-5.6本体ではありません。上位モデルなら結果は変わるでしょうし、費用も10〜20倍になるでしょう。
前回の結論——EVO-X2+ローカルLLMはエージェント基盤にはまだ早い——は変わりません。精度で1〜3本勝っても、1タスク11分では日常遣いにならない。ただ、「ローカルは精度でも負ける」と思っていた方がいたら、それは違いました。負けているのは速度で、精度ではない。 そして、外に出せないデータを扱うときのローカルの価値は、今回の結果でむしろはっきりしました。精度が同等以上なら、待つ価値はあります。
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| APIキーの用意、effort highでの再走の指示(「既定が低すぎた可能性がある」) | Codex CLIとOpenAI APIの組み合わせの実現性調査、ハーネスの接続先切替、APIキー登録の問題の切り分け |
| 記事の観点(コスト・速度・精度の順で、前回の推奨の妥当性を問う)、この記事のレビュー | 42回の実行・回収・判定・採点、トークン使用量と料金の集計、D2の初稿の復元(ログから各版の字数を再生) |
| ダッシュボードの入力トークン数を見て「出力が少なすぎないか」と質問 | 判定器の修正4件、REPORT、この記事の下書きと図 |
正直、気になっていること
- n=3です。 D2の「壊れた物差し」は6回中2回、D3の「(Sx)」は6回中5回。回数を増やせば率は動きます
- 採点者はClaude、タスクを作ったのもClaude、私はスポットチェックだけ。この4本を通して同じ構造です。ただし今回の合否は機械判定で、ルーブリックは補助です
- コンテキスト上限をローカルに合わせて64Kにしています。 Lunaは本来1Mまで使えるので、Lunaにとっては不利な条件かもしれません。ただ、42回の中で1回のリクエストが最大だったのは32Kで、64Kには当たっていません
- 既定effortが何だったのかが分からないのは上に書いたとおりです
- 電気代の20円は150Wの仮定計算です。実測はしていません(HWiNFOでの消費電力比較は、9月初めの記事で予告したままです)
まとめ
- GPT-5.6 Lunaを、ローカルと同じ21回で。費用は31円(highで43円)、1タスクの中央値は33秒(53秒)、精度は14/21(16/21)
- コストと速度についての前回の推奨は正しかった。精度については訂正。EVO-X2のQwen3.8 Flash Next IQ4_XSの17/21に、highでも届かなかった
- Lunaの落ち方はローカル勢と違う。タイムアウト0、ツール失敗0で、落ちるのは規則の1行と、自分の道具の検算
- effort highで+2本。直るのは仕様の読みで、規則の遵守と検算は直らない
- ローカルが負けているのは速度で、精度ではない。外に出せないデータを扱う価値は変わらない
次にやること
D3の「(Sx)を書かない」は、ガイドラインの該当行を依頼文に引用して渡せば守るのか。D2の物差しは、「字数はpython3 -cで数えること」と道具を縛れば消えるのか。どちらも1行足すだけなので、近いうちに試します。実務では、たぶんこの「1行足す」がいちばん効く対策です。
ローカル側は、Qwen3.8より軽くて高精度なモデルが出たら同じ21回を回します。評価セットと判定器はそのまま残してあります。
無償版のモデルに、170万円の片翼が精度で勝った。速度で負けた。どちらも、測ってみないと分からなかったことです。
そして正直、ローカルLLMは思ったより頑張っていました。前回「エージェント基盤にはまだ早い」と書いた気持ちは変わりませんが、足りないのは速度で、それはハードウェアが解決する種類の問題です。帯域が1.2TB/sのMac Studio M5 Ultraや、次世代のRyzen AI MAXが当たり前になれば、ローエンドからミドルクラスのクラウドLLMには、手元の機械で届く。今回の結果は、その希望が持てる内容でした。
EVO-X2は、まだ手放しません。次のハードウェアが出るまで、遊び倒します(笑
コメント