「12GBのゲーム用GPUで、125BのQwen3.8 Flash Nextが毎秒90トークン以上で動く」。そんな触れ込みのOSS、Strataが話題になっています。GitHubで公開されたのは9月24日。10月6日の時点でスターは約1万5千に達し、8月に出たFreeTokenをもう追い越しました。
以前の記事でFreeTokenを紹介した私は、ニュースを見て「これ、FreeTokenと同じ仕組みでは?」と思いました。そこでClaude Codeに、両方のソースコードと説明書き、Strataの論文を読み比べてもらいました。
正直に書くと、私の見立ては半分当たりで、半分外れでした。
- 発想は同じでした。 VRAMを「よく使うエキスパートの置き場(キャッシュ)」にして、全部のエキスパートはメインメモリに置く。VRAMにないエキスパートは、GPUへ運ぶ分とCPUで計算する分に分けて、同時に進める。両者とも、この設計です
- 作りは別物でした。 FreeTokenは多くのモデルに対応したPython中心の汎用エンジン、StrataはQwen3.8 Flash Nextだけのために C++で一から書いたエンジンです。Claude Codeが両方の全ファイルの中身を照合したところ、同じファイルは一つもありませんでした
- 12GBで動く理由は、Strataの割り切りにありました。 2〜3bitまで縮めた重み、SSDに置く表、モデル自身を使った「先読み」。どれもFreeTokenにはないものです
共通の仕組み:VRAMはキャッシュ、本体はメインメモリ
最近の大きなLLMの多くはMoE(Mixture of Experts)という作りで、全体は巨大でも、1トークンの計算で使うのはごく一部の「エキスパート」だけです。Strataの論文によると、Qwen3.8 Flash Nextは48層それぞれに512個のエキスパートを持ち、1トークンごとに各層で10個を選びます。全24,576個のうち、使うのは2%ほどです。
そこで両者とも、次のように仕事を分けます。
- GPU(VRAM): 毎トークン必ず使う部分(アテンションなど)と、よく使うエキスパートのキャッシュ
- メインメモリ: 全部のエキスパート。VRAMになかったエキスパートは、CPUがメインメモリの上でそのまま計算する
- PCIe: VRAMになかったエキスパートの一部をGPUへ運ぶ。CPUの計算と同時に進める
1層ごとにGPUとCPUが合図を受け渡し、遅いほうを待って次の層へ進む、という流れまで同じです。
違い:汎用のFreeToken、専用のStrata
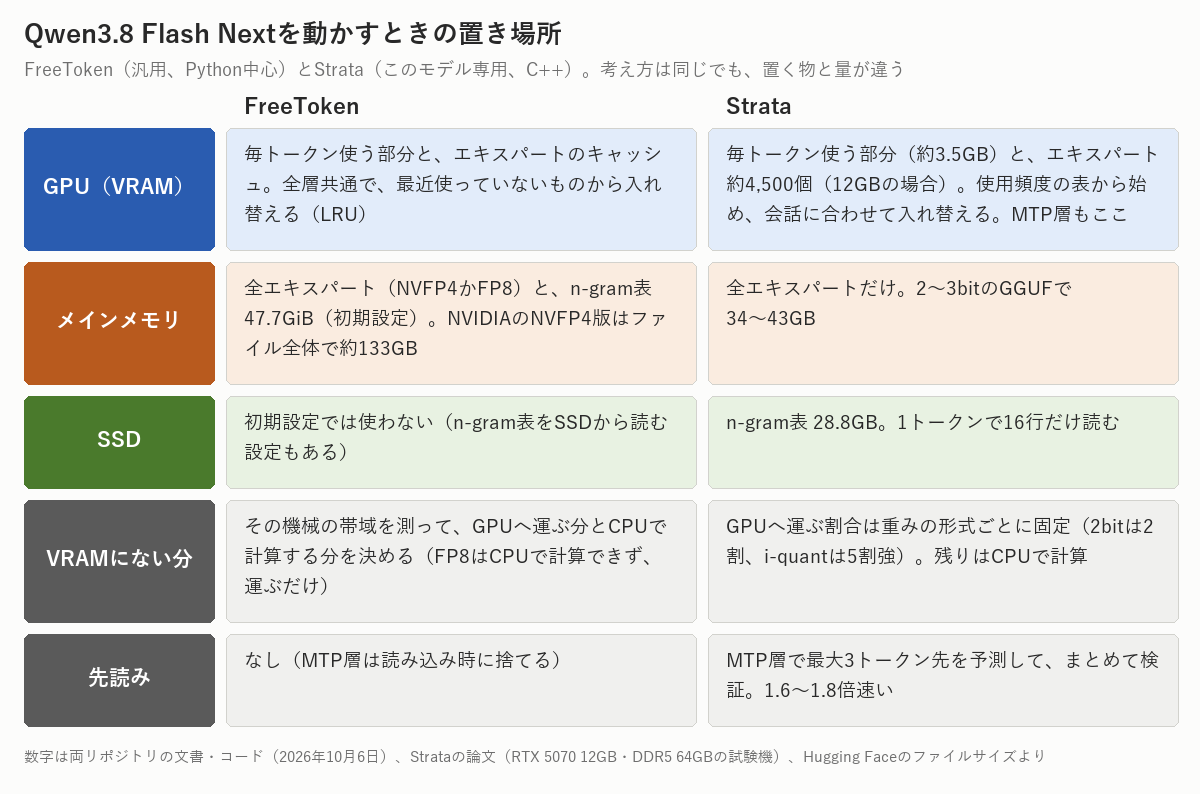
| FreeToken | Strata | |
|---|---|---|
| 公開 | 2026年8月。UC Berkeleyなどの研究者、論文あり | 2026年9月24日。個人の開発者、論文(PDF)あり |
| 対応モデル | DeepSeek-V4、GLM、MiniMax、Gemma 4、Qwen系など多数 | Qwen3.8 Flash Nextだけ(コード向けのCoder、派生のSwift 1.5を含む) |
| 作り | Python(PyTorch)が中心。SGLang系の設計が下敷き。AMDは試験的 | C++とCUDAで一から。AMD(HIP)版とIntel(SYCL)版もある |
| Qwen3.8 Flash Nextの重み | NVFP4かFP8(NVIDIAのNVFP4版はファイル全体で約133GB、QwenのFP8版は約186GB) | 2〜3bitのGGUF(エキスパートは34〜43GB) |
| n-gram表 | 初期設定ではメインメモリに置く(47.7GiB)。SSDから読む設定もある | SSDに置き、1トークンで16行だけ読む(28.8GB) |
| VRAMのエキスパートの入れ替え | 全層共通で、最近使っていないものから入れ替える(LRU) | 事前に測った使用頻度の表から始め、会話に合わせて入れ替える |
| VRAMにない分 | その機械の帯域を測って、GPUへ運ぶ分とCPUで計算する分を決める | GPUへ運ぶ割合は重みの形式ごとに固定。残りはCPU |
| 先読み(投機的デコード) | なし。Qwen3.8 Flash NextのMTP層は読み込み時に捨てている | MTP層で最大3トークン先を予測し、まとめて検証する |
| ライセンス | Apache-2.0 | MIT |
n-gram表は、Qwen3.8 Flash Nextが持つ大きな表で、直前のトークンの並びから引きます。MTP(Multi-Token Prediction)層は、モデルに付いている「次の何トークンかを当てる」ための小さな層です。
Strataが12GBで動く理由
Strataの論文の試験機は、RTX 5070(12GB)、Ryzen 5 7600、DDR5 64GBです。文脈4Kのとき、2bitのQ2_0で毎秒94.6トークン、IQ2_XSで78.0トークン、IQ3_XXSで65.6トークンを出しています。小さいGPUでここまで出る理由は、論文とコードを読む限り、次の4つです。
- 重みが小さい。 StrataはISTA-DASLabが作った2〜3bit版を使い、エキスパートは全部で34〜43GBです。FreeTokenが読むNVIDIAのNVFP4版は、ファイル全体で約133GBあります
- n-gram表をSSDに追い出した。 28.8GBの表を、1トークンにつき16行だけSSDから読みます。そのぶんメインメモリが空きます
- MTPで先読みする。 MTP層が最大3トークン先を予測し、本体のモデルがまとめて検証します。Strataの論文では1.6〜1.8倍速くなり、出力は先読みなしと1トークンも違わないとしています
- 一つのモデル専用に作り込んだ。 StrataはCPUの計算部分を2bitの形式に合わせてAVX-512で書き直し、メインメモリの帯域近く(毎秒約42GB)まで使い切っています
ただし、「12GBのGPUとメモリ32GBで動く」という触れ込みには注意が要ります。StrataのREADMEでは、メモリ32GBで勧めているのはエキスパートを半分に絞ったCoder版で、全サイズを動かすには64GBとしています。それに、2bitまで縮めたときに賢さがどれだけ残るかは、速さとは別の話です。私のEVO-X2での量子化比較では、同じQwen3.8 Flash Nextが、日常タスクの評価セットでIQ4_XSの17/21からIQ3_XXSの14/21、IQ1_Sの11/21へと落ちました。
コードの出どころ
- 同じ中身のファイルは0。 共通点は、llama.cppの部品(ggml-common.h)をそれぞれ取り込んでいることだけで、その版も違います
- Strataのクレジットは、llama.cpp、Splash、NInfer、HyperQwenです。論文の関連研究にはKTransformers、Fiddler、MoE-Infinity、PowerInferなどが並び、FreeTokenの名前はありません
- FreeTokenの謝辞は、mini-sglang、SGLang、vLLM、FlashInfer、flash-linear-attention、LightLLM、llama.cppです
Claude Codeの見立てでは、発想が同じなのは、どちらかがまねたからというより、この考え方そのものに数年分の研究の積み重ねがあるからです。次の節で、その系譜を軽く紹介します。
似た研究と技術
背景にあるのは、メモリ不足によるGPUの値上がりです。RTX 5090の日本での希望小売価格は、発売時(2025年1月)に税込39万3,800円でした(GAME Watch)。8月には秋葉原の店員から「一般的な価格なら100万円を超えるだろう」という声が出ていて(ITmedia PC USER、古田雄介の週末アキバ速報)、その言葉どおり、9月11日には国内で在庫のある製品がなくなり、取り寄せの最安でも101万7,800円になりました(GAZLOG)。GAZLOGの価格の集計では、10月4日の最安が109万7,800円。発売時の希望小売価格の約2.8倍です。理由は、RTX 5090が16枚積むGDDR7メモリの値上がりです。
私のGALLERIAに載っているRTX 5090も、いま買い直すとグラボだけで100万円コースです(震え声
海外でも同じで、米国の販売価格の中央値は、希望小売価格1,999ドルに対して2026年8月に4,699.99ドル(Tom’s Hardware調べ、Tech Insiderのまとめより)。前回の記事で触れたDGX Sparkも、3,999ドルから4,999.99ドルに上がりました。VRAMをたくさん積むほど高くつく今、「少ないVRAMをキャッシュとして賢く使い、本体はメインメモリやSSDに置く」流れは、これからも続きそうです。
| 名前(発表) | やっていること |
|---|---|
| llama.cppの–cpu-moe / –n-cpu-moe(LM Studioでは「Force Model Expert Weights onto CPU」) | エキスパートを丸ごと(または指定した層の分だけ)メインメモリに置き、CPUで計算する。入れ替えはしない。いちばん手軽 |
| KTransformers(2024年公開、論文は2025年) | CPUとGPUでMoEを分担する代表格。巨大なDeepSeekを1枚のGPUと大容量メモリで動かす用途で知られる |
| Fiddler(2024年) | VRAMにないエキスパートは、GPUへ運ぶよりCPUで計算したほうが速いことがある、という考え方 |
| MoE-Infinity、Pre-gated MoE(2023〜2024年) | 個人の機械向けのエキスパートのキャッシュ。次の層で使うエキスパートを予測して、先に運んでおく |
| PowerInfer(2023年) | よく働く部分をGPUに、たまにしか働かない部分をCPUに置く |
| LLM in a flash(Apple、2023年) | メモリに載らないモデルを、フラッシュメモリ(SSD)から必要な分だけ読んで動かす |
| Splash(Inco AI、2026年9月)、NInfer、HyperQwen | 一つのモデル専用にエンジンを作り込む流れ(SplashはApple Silicon、NInferはRTX 5090、HyperQwenは24GBのGPU向け)。Strataは「一つのモデルに一つのエンジン」という発想をここから得たと書いている |
Claude Codeは、FreeTokenとStrataを、上の「CPUとGPUの分担」「エキスパートのキャッシュ」「SSDの活用」をまとめて実装したもの、と整理しています。Strataはさらに、最後の「専用エンジン」の流れを足しています。
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 「FreeTokenと同じ仕組みでは?」という疑問、記事の方針(違っていたことを正直に書く、似た技術にも触れる、実機検証を予告する)、この記事のレビュー | 両方のソースコード・説明書き・論文の読み比べ(全ファイルの中身の照合を含む)、似た研究とGPU価格の調べもの、原稿と図 |
次は実機で確かめます
ここまでの数字は、すべて作者たちの発表とコードから読んだものです。私の手元には、RTX 5090(32GB)とメインメモリ128GBのGALLERIAと、統合メモリ128GBのEVO-X2があります。しかもStrataには、EVO-X2と同じRyzen AI Max+ 395向けの手順書まで用意されています。近いうちに、実機で次のことを確かめるつもりです。
- 同じQwen3.8 Flash Nextで、StrataとFreeTokenの速さを比べる。 FreeTokenのNVFP4版は約133GBあるので、128GBの機械でどこまで動くかも含めて
- 2bitに縮めたQwen3.8 Flash Nextが、日常タスクの評価セットで何問解けるか。 EVO-X2のIQ4_XSは17/21でした
- EVO-X2で、LM Studio(毎秒17トークン)よりどこまで速くなるか
まとめ
- StrataとFreeTokenは、「VRAMはキャッシュ、本体はメインメモリ、足りない分はCPUとGPUで同時に」という同じ発想のエンジン
- ただし作りは別物。FreeTokenは多くのモデルに対応した汎用エンジン、StrataはQwen3.8 Flash Next専用のエンジンで、コードの流用もない
- Strataが12GBのGPUで速いのは、2〜3bitの重み、SSDに置くn-gram表、MTPの先読み、専用の作り込みという割り切りのおかげ。ただし、2bitで賢さがどれだけ残るかは別の話
- メモリ不足でGPUが高い今、「少ないVRAMを賢く使う」技術は、まだまだ増えそう
「同じ仕組みでしょ」と書く前に、読み比べておいてよかった。続報をお楽しみに。
五十路の早とちり、今回は未遂で済みました(震え声
コメント