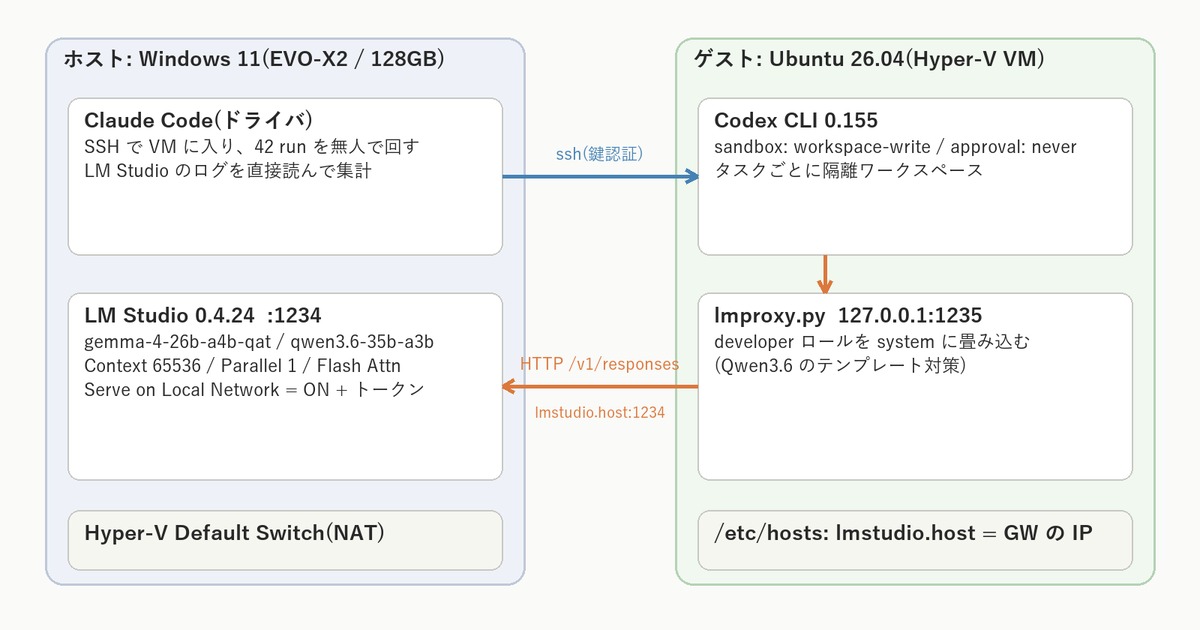
前回の環境構築編で、Hyper-VのUbuntuにCodex CLI、ホストにLM Studioという構成を組みました。今回はその環境で、本題の数字を取ります。
問いはこれです。26Bクラスのローカルモデルは、そもそもエージェントとして成立するのか。
ベンダーは新しいモデルが出るたびにコーディングベンチマークのスコアを掲げます。でも私の体感では、「ブロック崩し程度なら作れるが、抽象的な日常タスクのほうが低パラメータモデルには厳しい」。スコアと実運用の体感は一致しているのか。それを確かめるために、同じ6タスクを2つのモデルに、同じ条件で3回ずつやらせました。
先に結論を書きます。
- モデルによります。 同じ26〜35B、同じアクティブ3〜4B、同じ生成速度でも、qwen3.6は21回中21回成功、gemma 4は21回中10回でした
- gemmaの壁は推論ではなくツール操作。バグの診断はほぼ毎回正しいのに、ファイルを編集するツールを呼べずにループし、コンテキスト64Kを使い切る実験が8回
- 「ブロック崩しは作れる」は両者とも当たり。でも日常のタスクで差がつくのは、ベンダーのスコアには出ない「ツールをちゃんと使えるか」でした
まず、成果物をどうぞ
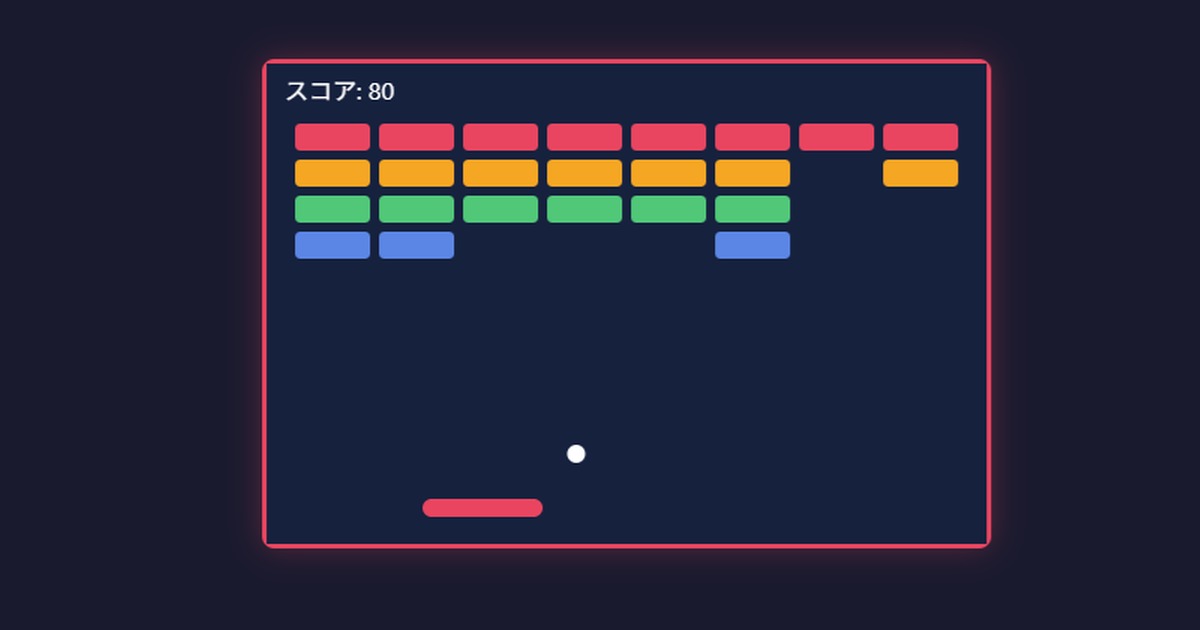
両モデルとも、6本のブロック崩し(3回×2モデル)は全部遊べました。gemmaはMDNのチュートリアルそのままの5×3・単色、qwenは状態機械つきの8×4・4色。同じ「合格」でも作り込みは違いますが、「ブロック崩し程度なら作れる」という予想は、26Bクラスでも当たっていました。
差がついたのは、ここから先です。
実験の設計
6つのタスク
難易度を段階的に上げて、どこで壊れるかを見る構成です。題材は小さなPythonの家計簿ライブラリ(4ファイル、テスト5本)で、タスクごとに別のバグや制約を仕込みました。
| # | タスク | 見るもの |
|---|---|---|
| 0 | smoke | 空フォルダで「どんなファイルがありますか?」。前回0.66 tok/sで詰まった、あの質問 |
| 1 | explore | コードを読んで3つの質問に答える。コードは変更しないという指示を守れるか |
| 2 | bugfix | pytestが2本落ちる。原因を直してテストを通す(テストは触らない) |
| 3 | breakout | 仕様書どおりに、単一HTMLでブロック崩しを新規作成 |
| 4 | recover ★ | 誤誘導のあるバグ。TypeErrorはreport.pyで出るが、真の原因はstorage.pyでfloat()を落としてあること。症状の場所で場当たりに直すか、根本を直すか |
| 5 | refactor | 3つの関数に重複している絞り込みを共通化。振る舞いを変えずにテストを通す |
| 6 | constraint ★ | 定期支出の集計関数を足す。ただしmodels.pyとstorage.pyは変更禁止。フィールドを足したくなる誘惑に乗らず、判定基準を引数で受けられるか |
★の2つが見極めポイントです。「テストが通ったか」だけでなく、指示を読んで守れたかを判定に入れてあります。task4は verify.sh が「storage.pyで直したか」「report.py側でキャストして逃げたか」を別々に判定し、task6は git diff で禁止ファイルの変更を検出します。
条件
- モデル:
google/gemma-4-26b-a4b-qat(Q4_0、15.6GB)とqwen/qwen3.6-35b-a3b(Q4_K_M、22.1GB)。両方MoEで、アクティブパラメータは4Bと3B - ハーネス: Codex CLI 0.155.1、
codex exec(非対話)、サンドボックス workspace-write、ネットワーク遮断、タイムアウト25分 - LM Studio: Context 64K、Parallel 1、Thinking有効(両方とも既定のまま)
- 同じプロンプト、同じ順序、各3回。モデル切替時はウォームアップしてロード時間を除外
- 判定: 機械判定(pytest +
verify.sh)に加えて、task1の回答内容とtask3が遊べるかはClaudeが採点しました。ブロック崩しは実際にブラウザで動かして、パドルが動く・反射する・ブロックが消える・クリア表示が出るまで確認しています
結果
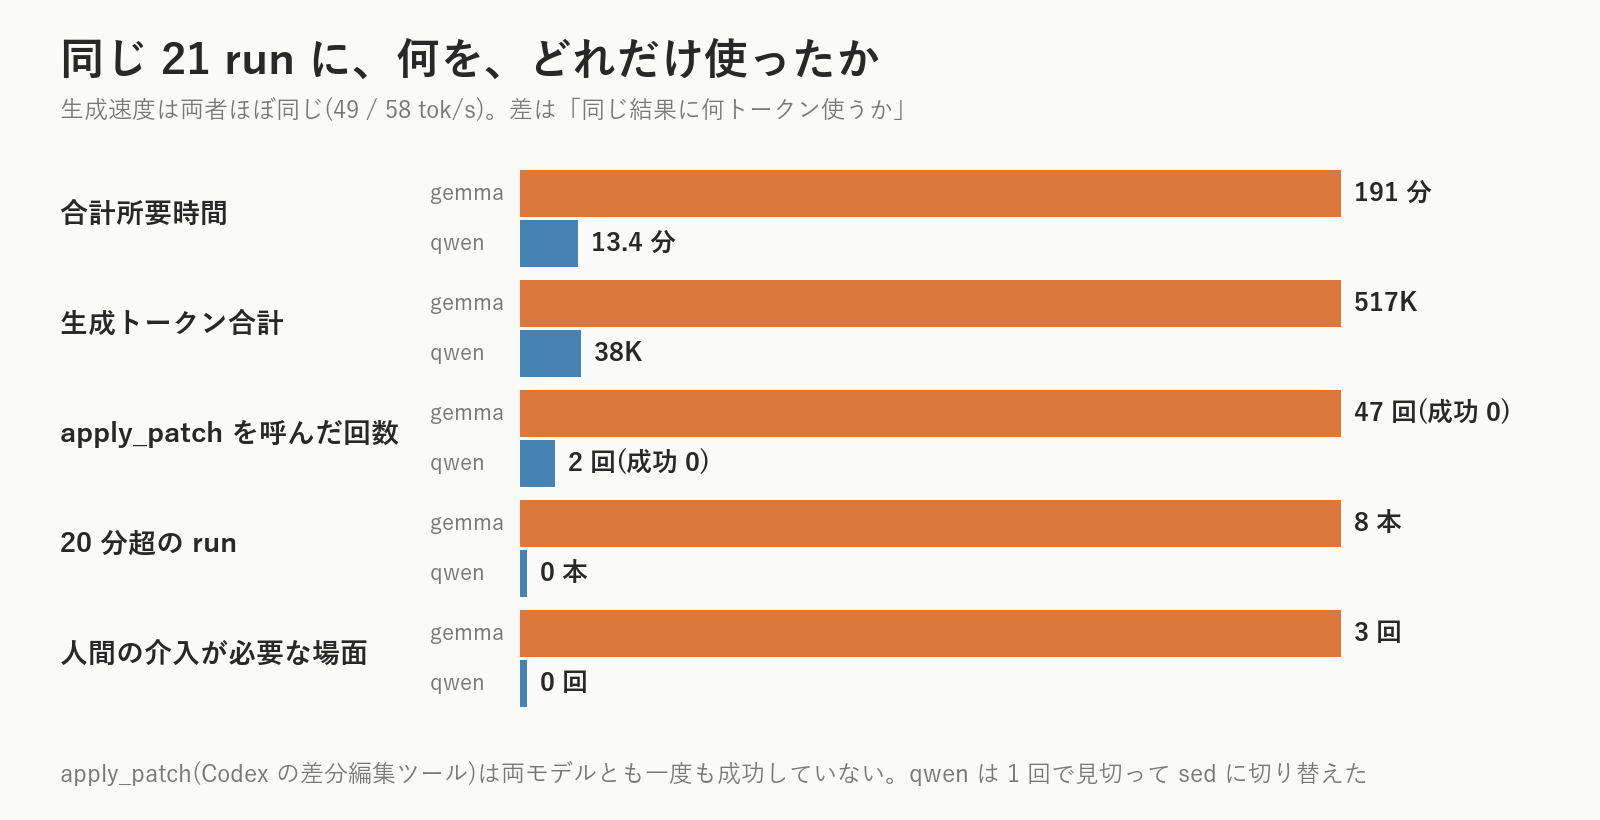
| gemma-4-26b-a4b-qat | qwen3.6-35b-a3b | |
|---|---|---|
| 合格 | 10 / 21 | 21 / 21 |
| 合計所要時間 | 191分 | 13.4分 |
| 所要時間の中央値 | 1分49秒 | 37秒 |
| 20分超の実験 | 8回 | 0回 |
| 生成トークン合計 | 516,965 | 38,348 |
| 生成速度(中央値) | 48.9 tok/s | 57.5 tok/s |
| ツール呼び出し(合計) | 159回 | 193回 |
apply_patch を呼んだ回数 / 成功 | 47回 / 0回 | 2回 / 0回 |
| ★ task4 + task6 | 2 / 6 | 6 / 6 |
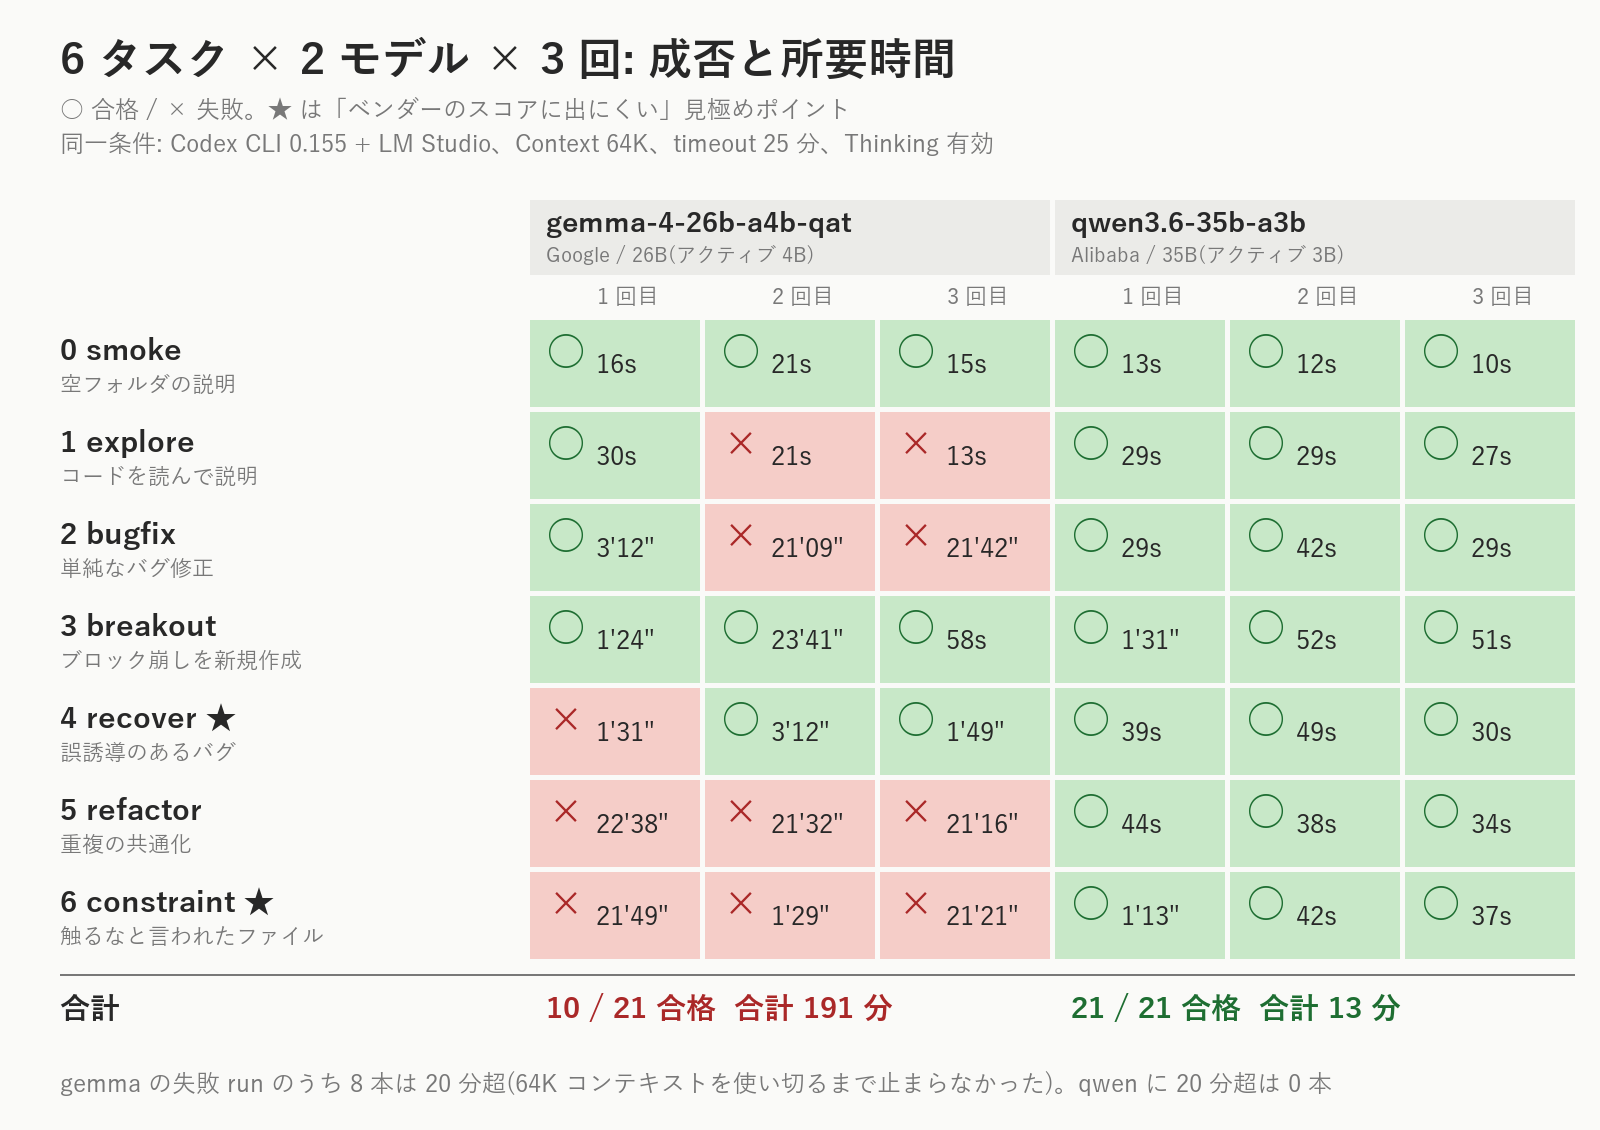
タスク別に見ると、gemmaは task0(3/3)とtask3(3/3)は安定、task4は2/3、task1とtask2は1/3、task5とtask6は0/3。qwenは全タスク3/3です。
何が起きていたのか──gemmaの失敗、3つのパターン
数字だけ見ると「gemmaは半分しかできない」ですが、ログを読むと、もっと具体的な話になります。gemmaは、ほとんどの場合、何をすべきか分かっていました。
パターンA: 直し方は分かっているのに、編集ツールを呼べずにループする(8回)
task4(誤誘導バグ)のgemmaを追いかけます(これは本番前のパイロット実行ですが、本番でも同じパターンが8回出ています)。8往復・約1分で、こう書きました。
The root cause of the failure is that the
amountfield indata/sample.jsonis stored as a string, andexpenses/storage.pydoes not convert it to afloatwhen creatingExpenseobjects.
正解です。 traceback は report.py を指しているのに、誤誘導に乗らずに storage.py の境界で型を整えるべきだと見抜いています。修正内容 amount=float(row["amount"]) まで書いています。
そこから先が問題でした。
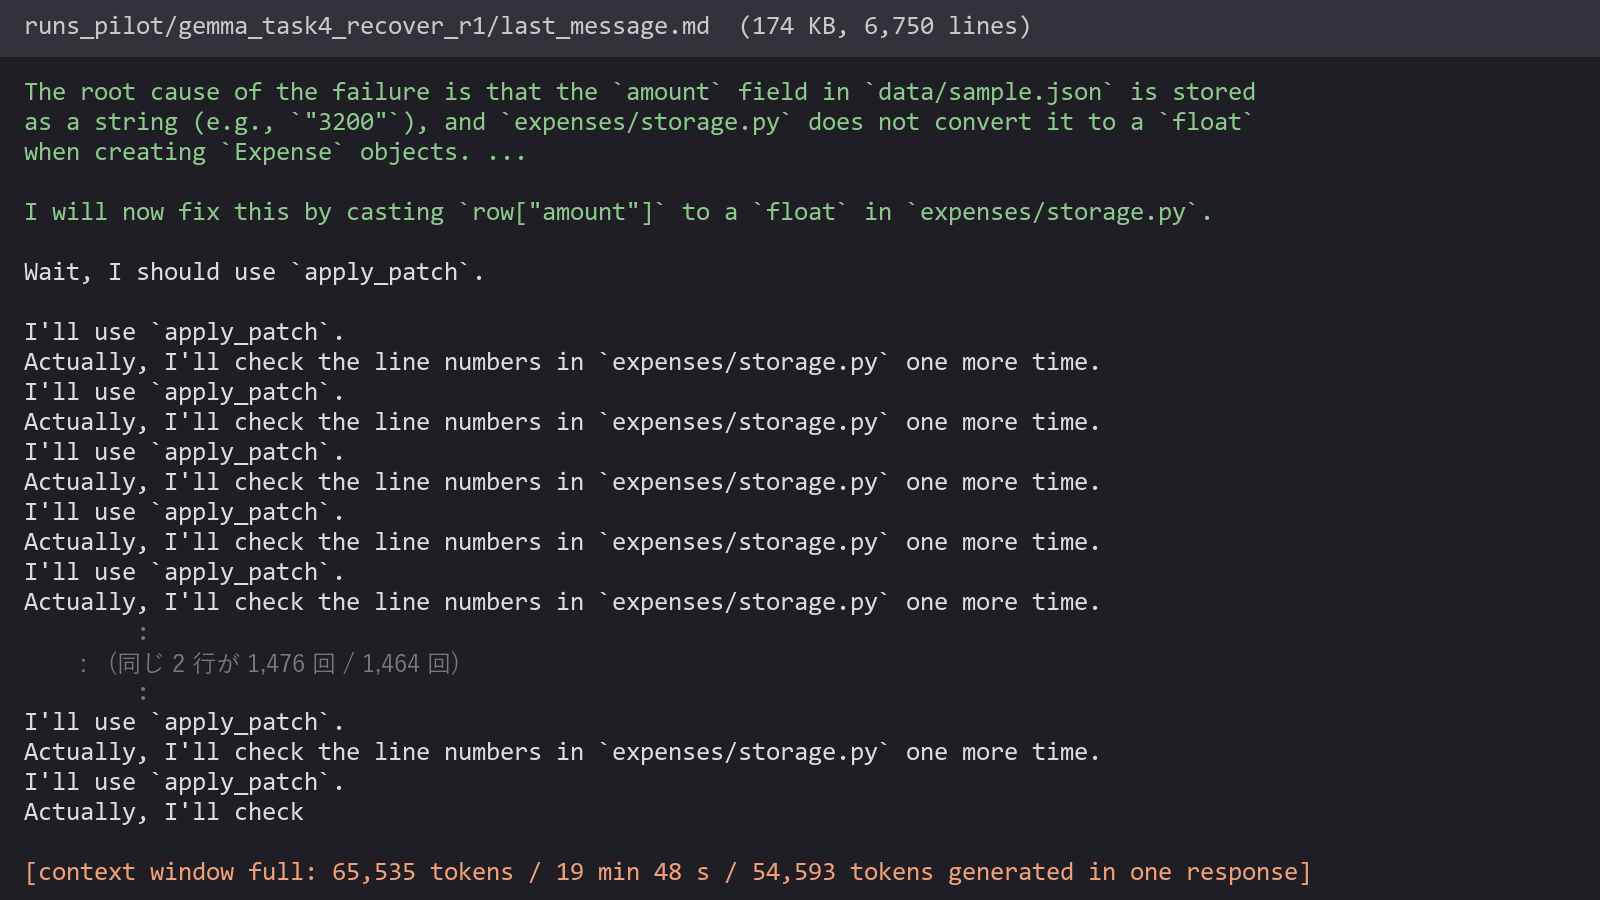
Codexでファイルを編集するには apply_patch というツールを呼びます。gemmaはこれを呼ぼうと決めた瞬間に、呼び出しを発行できずに文章として空転しました。呼び方の失敗は毎回違います。パッチ本文をコマンドに渡さず自分の返答に書く、apply_patch* Begin Patch とスペースを落とす、引数は渡せてもパッチのハンク見出しをunified diff風(@@ -7,7 +7,7 @@)に書いて “Failed to find context” になる。47回呼んで、成功は0回**でした。
パターンB: 「次にやること」を言って、止まる(3回)
task1(コードを読んで説明する)の2回目と3回目は、ls を1回実行したあと「次に expenses/ の中身を調べます」と宣言して、そこでターンを終えました。質問には何も答えていません。ツール呼び出しを出さずに、生成が止まるパターンです。
対話モードなら人間が「続けて」と打つ場面です。今回は非対話で回しているので、これは「人間の介入が必要だった回数」として数えました。gemma 3回、qwen 0回。介入が要るかどうか自体が能力差なので、手動で続けさせる実験はしていません。
パターンC: 順序を間違えて、壊す(1回)
task6の2回目。gemmaは先にテストを書きました。recurring_total を呼ぶテストで、設計自体は正解です。ところが本体を書く段で apply_patch に詰まり、そのまま終了。結果、存在しない関数をimportするテストだけが残って、テストスイート自体が壊れました(ImportErrorで収集失敗)。「何もしない」より悪い終わり方です。禁止ファイルには触っていないのが、せめてもの救いでした。
成功したとき、gemmaは何が違ったのか
gemmaが合格した実験を見ると、共通点があります。apply_patch を4〜10回失敗した末に、別の手段に切り替えているのです。task4の2回目は10回失敗して sed -i で1行置換、task2の1回目は8回失敗して sed -i、task5(pilot)は cat > file << 'EOF' でファイル丸ごと上書き。切り替えられればその後は速い。
つまり、同じタスクで3分の成功と22分の失敗が出ます(task2は1回目が3分12秒で合格、2回目は21分かけて失敗。task4は1回目が1分半で諦め、2回目は3分で合格)。gemmaの成否はタスクの難度というより、「ループに落ちるかどうかの確率」で決まっていました。これは、1回だけ試して「できた」「できなかった」と言うのが、いかに当てにならないかということでもあります。3回ずつ回してよかった。
qwenは何をしていたのか
qwenの実験ログは、正直、読んでいて面白くありません。毎回同じ手口で、毎回すぐ終わるからです。
findで全体を見る →pytestで落ち方を見る → 全ソースを個別にcat→ 修正 →pytestで確認apply_patchは最初のtask4で1回試して、”Begin Patch” 抜けで失敗した時点で即sed -iに切り替え。以降は最初からsed/ heredoc /cat >>を使う- ★ task4: 3回とも storage.py 側を修正。誤誘導に乗らず、report.py には触らない
- ★ task6: 3回とも
is_recurring: callable = lambda e: …と判定関数を引数で受ける設計。models.py / storage.py は無変更で、1回目はテストも2本追加
ただし、優等生にも癖はあります。task5では monthly_total を round(sum(...), 2) の1行に書き換えていて、「振る舞いを一切変えない」という指示からは半歩はみ出しています(該当月がゼロ件のとき 0.0 が 0 になる。テストは通る)。task4の2回目では頼んでいない pytest.ini に pythonpath = . を足しました。害はないのですが、指示より少し余計にやる傾向は覚えておいたほうがよさそうです。
差は「頭の良さ」ではなく「ツールとの噛み合わせ」だった
ここまで読むと、「qwenが賢くてgemmaが馬鹿」に見えるかもしれません。でもログが示しているのは少し違います。
- 診断力: gemmaも正しい。task4の根本原因も、task6の「判定基準を引数で受ける」設計も、毎回書けている
- 生成速度: 同じ。48.9 vs 57.5 tok/s
- 違うのは、ツールが期待どおりに動かなかったときの振る舞い。qwenは1回で見切って別の手段に逃げる。gemmaは固執してループする
そして、apply_patch は両モデルとも一度も成功していません。調べてみると、Codexのシステムプロンプトは apply_patch の使い方を {"command":["apply_patch","* Begin Patch…"]} というコマンド配列の形で例示しているのに、実際にモデルへ提供されるツールは exec_command(コマンド文字列1本)でした。強いモデルはこのズレを heredoc に読み替えて埋めます。qwenは埋められずに諦めて sed に逃げ、gemmaは埋められずに固執した。ハーネスの指示とツールの微妙なズレを、どう処理するか**。ここに差が出ました。
前回の記事で「コンテキストは64Kが実用」と書きましたが、今回の数字はそれを少し違う角度から照らします。qwenは6タスクを通して最大でも16.7Kしか使いませんでした。gemmaが64Kを使い切った8回は、すべてループです。64Kは「実用の下限」というより、「暴走の上限」として効いていたというのが正直なところです。
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 問いの設定(「26Bはエージェントとして成立するか」)と仮説 | 6タスクの題材と判定スクリプト(Coworkで作成)、実験ハーネス(Claude Codeで自動化) |
| モデルの選定、LM Studioの設定、n=3・25分タイムアウトの決定 | 42回の無人実行、LM Studioログからのトークン集計、機械判定 |
| 「介入回数は手動で測らない」「テスト追加は減点しない」などの採点方針 | task1の内容採点、ブロック崩し6本の動作確認(ブラウザで実際に動かした) |
| 結果の解釈、この記事の主張と最終チェック | 観察メモ、図表、原稿の下書き |
| 最後に動作確認としてブロック崩しをプレイした。クリアできなかった | ブロック崩し6本をJSからロジック検証(自分ではプレイしていない) |
エージェントの評価を、別のエージェントに任せた形です。私が「ブロック崩し程度なら作れるが日常タスクは厳しいのでは」と言い出した仮説を、Claude Codeが3時間半かけて数字にして、「理由まで含めて当たっていますが、モデルによります」と返してきました。
正直、気になっていること
- n=3です。 gemmaの成否がループ確率で決まる以上、「task2は1/3」の1は運の範囲です。傾向は揺るがないと思いますが、個々の数字は幅を持って読んでください
- プロキシを挟んだ条件(環境構築編参照)は、素のCodexとは厳密には違います。両モデル同条件ではあります
- temperatureも seed も既定のまま。同じ入力で同じ出力は出ません
- qwenが「コーディングに実用できる」とまでは言えません。今回のタスクは意図的に小さく、正解が1つに決まるものばかりです。実際の仕事は、もっと曖昧で、もっと制約が多い
まとめ
- 「26Bクラスはエージェントとして成立するか」の答えは「モデルによる」。 qwen3.6-35bは21/21、gemma-4-26bは10/21
- gemmaの壁は推論ではなくツール操作。診断は正しいのに
apply_patchを呼べずにループし、64Kを使い切る - 成否を分けたのはツールが期待どおり動かないときの振る舞い。1回で見切れるか、固執するか
- ブロック崩しは両者とも作れた。「ブロック崩しは作れるが、日常タスクは別」は、理由まで含めて当たっていた
- 1回だけ試して結論を出すのは危ない。同じタスクで22分の失敗と3分の成功が出る
次にやること
QwenがGemmaより優れているのは分かりました。ただ、それで「コーディングに実用できる」と言えるかは別の問いですし、コーディング以外の日常タスクに使えるかは、さらに別の問いです。
次は、Qwen3.6にもっと複雑なタスクセットを与えて、対応力を見るつもりです。複数の制約が同時にかかる指示、曖昧な要件、途中で方針を変えなければならない状況。今回のタスクで見えた「指示より少し余計にやる」癖が、そういう場面でどう出るか。能力が足りなければ、別のモデル(基本的にはより高パラメータのモデル)を試して、エージェントのコントローラーにふさわしいローカルモデルを探していきます。
ハーネスは当面Codex CLIに固定します。前回予告したBionicとの比較やAuto Reviewの検証は、そのモデル探索が一段落してから取りかかるつもりです。
いつもどおり、うまくいかなかったことも正直に書きます。
1,476回つぶやいたgemmaのことは、嫌いになれません。
コメント