前回、GPT-5.6 Lunaをローカルモデルと同じ21回のテストで測って、「コストと速度は推奨どおり、精度はEVO-X2のQwen3.8に届かず」と書きました。その記事を公開した当日に、OpenAIがGPT-6 SolとGPT-6 Lunaを発表しました。その少し前にはAnthropicのOpus 5.5も出ています。新しいモデルの出るペースに、記事が追いつきません(震え声
新しいLunaで、同じ21回をもう一度回しました。見たいのは2つです。
- やりたいことが出来るようになったか。 旧Lunaが落ちたところ(ブログ下書きの「壊れた物差し」、動画プロンプトの禁止事項、家計簿の表と欠損月)を越えたか
- 旧Lunaより性能が上がったか。 合格数、中身の質、所要時間、費用
お金の話を先に1つ。前回と同じく、アプリで使う分には無償(GPT-6 Lunaは無償プランでもデスクトップアプリから使えます)ですが、シェルやファイルを操作するエージェントとして動かすにはAPIが必要で、こちらは有償です。以下の「円」は、そのAPIの金額です。
先に結論を書きます。
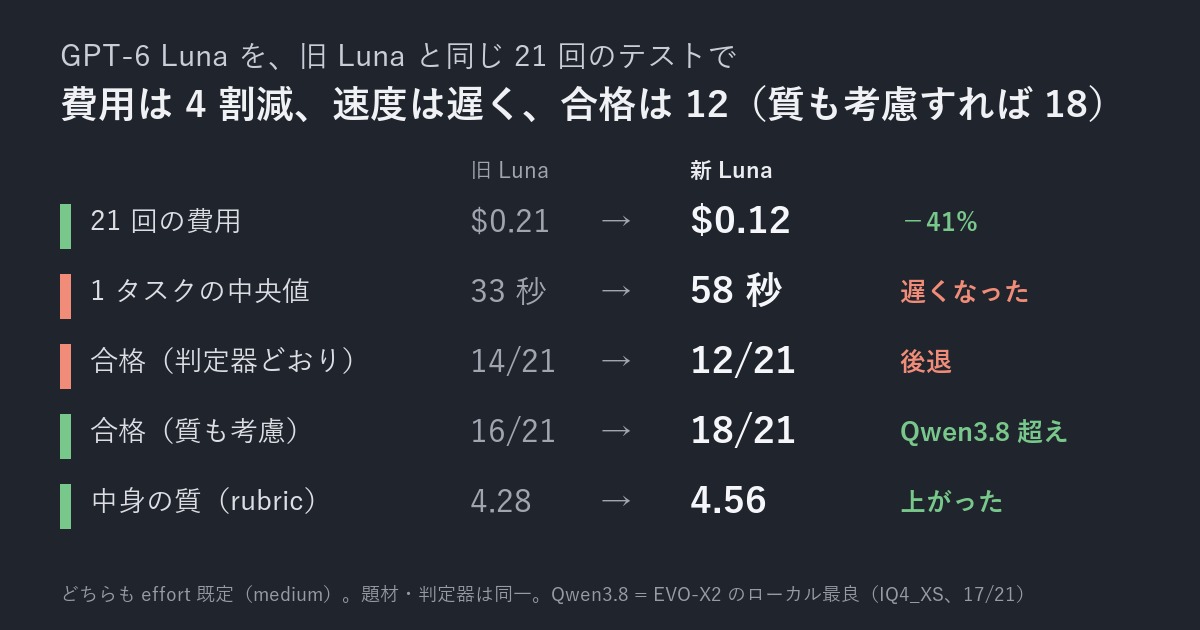
- 費用は下がった。 21回で$0.124(約18円)。旧Lunaの$0.21(約31円)から4割減
- 速度は落ちた。 1タスクの中央値は58秒(旧Lunaは33秒)。新Lunaの「既定」は、旧Lunaの「high」と同じくらい考えて、同じくらい遅い。それでもローカルのQwen3.8(IQ4_XS、11.5分)の12倍速い
- 精度は、数字が2つある。 判定器どおりなら12/21で、旧Lunaの14/21より後退。中身の質も考慮して、判定器の読みが厳しすぎる箇所を緩めると18/21で、ローカル最良のQwen3.8(IQ4_XS)の17/21を超える。中身の質(rubric)は4.28から4.56に上がった
- effortは上げても効かない。 既定・high・xhighで12 → 12 → 11
一言でまとめると、「安くなって、慎重になって、少し遅くなった。性能は横ばい」。OpenAIの発表を読んだときの私の印象(性能は横ばいで、主な改善はコスト)とも一致しました。
まず、結果をどうぞ
| モデル | 合格(判定器どおり) | 合格(質も考慮) | rubric平均 | 1タスク中央値 | 21回の合計 | 21回の費用 |
|---|---|---|---|---|---|---|
| GPT-6 Luna(effort既定) | 12/21 | 18/21 | 4.56 | 58秒 | 18.9分 | $0.124(約18円) |
| GPT-6 Luna(high) | 12/21 | 17/21 | 4.57 | 67秒 | 24.3分 | $0.142(約21円) |
| GPT-6 Luna(xhigh) | 11/21 | 16/21 | 4.54 | 86秒 | 27.7分 | $0.164(約24円) |
| GPT-5.6 Luna(effort既定) | 14/21 | 16/21 | 4.28 | 33秒 | 11.7分 | $0.21(約31円) |
| GPT-5.6 Luna(high) | 16/21 | 16/21 | 4.39 | 53秒 | 18.9分 | $0.29(約43円) |
| Qwen3.8 Flash Next IQ4_XS(ローカル) | 17/21 | 17/21 | 4.83 | 11.5分 | 236分 | 電気代(20円前後) |
条件は前回とまったく同じです。同じVM、同じCodex CLI 0.155.1、同じ題材・プロンプト・判定器。変えたのはモデル名だけで、Codex 0.155.1はgpt-6-lunaをそのまま受け付けました。effortを指定しない「既定」は、OpenAIのモデルページによればmediumです。
ここで前回の記事の訂正を1つ。前回は「既定のeffortがlowかmediumか、ログからは確定できない」と書きましたが、旧Lunaのモデルページにも既定はmediumと書いてありました。前回の既定走もmediumです。
費用:21回で18円。ただし単価ほどは下がらない
| 新Luna 既定 | 新Luna high | 新Luna xhigh | 旧Luna 既定 | 旧Luna high | |
|---|---|---|---|---|---|
| 21回の費用 | $0.124 | $0.142 | $0.164 | $0.210 | $0.291 |
| 出力トークン(1回あたり) | 5,021 | 6,332 | 7,904 | 3,671 | 6,211 |
| うち推論(reasoning) | 47% | 61% | 65% | 22% | 42% |
| 入力のキャッシュ命中 | 83% | 83% | 84% | 84% | 84% |
API単価は入力$0.20 → $0.10、出力$1.20 → $0.50(100万トークンあたり)。入力は半額、出力は58%引きです。ところが実際の費用は41%減にとどまりました。出力が1.4倍に増えたからです。増えた分の大半は推論トークンで、出力に占める割合が22%から47%に上がっています。
同じ「medium」でも、新Lunaは旧Lunaよりずっとよく考えます。出力トークンで見ると、新Lunaの既定は旧Lunaのhighとほぼ同じ量です。それでもxhighまで上げて$0.164で、旧Lunaの既定より安い。費用の面では文句なしです。
速度:遅くなった。新Lunaの「既定」は、旧Lunaの「high」並み
1タスクの中央値は58秒。旧Lunaの33秒から、1.8倍になりました。21回の合計は18.9分で、旧Lunaをhighで回したときの18.9分と、偶然ぴったり同じでした。考える量が旧Lunaのhigh並みなので、時間も同じだけかかる、ということです。
前回、「30秒なら待つ、11分なら投げて別のことをする」と書きました。1分はまだ「待つ」側です。ローカルのQwen3.8 IQ4_XS(11.5分)と比べれば12倍速い。日常遣いの判断は変わりません。ただ、「速さ」を理由に旧Lunaを勧めた前回の推奨からすると、ここは後退です。
精度:12と18。数字が2つある理由
ここが今回いちばん判断の要るところでした。
判定器は、2026年9月19日から全モデルに同じものを当ててきました。判定器を後から変えると、それまでの比較が崩れます。なので公式の合否は変えません。新Lunaは判定器どおりで12/21、旧Lunaの14/21より下です。
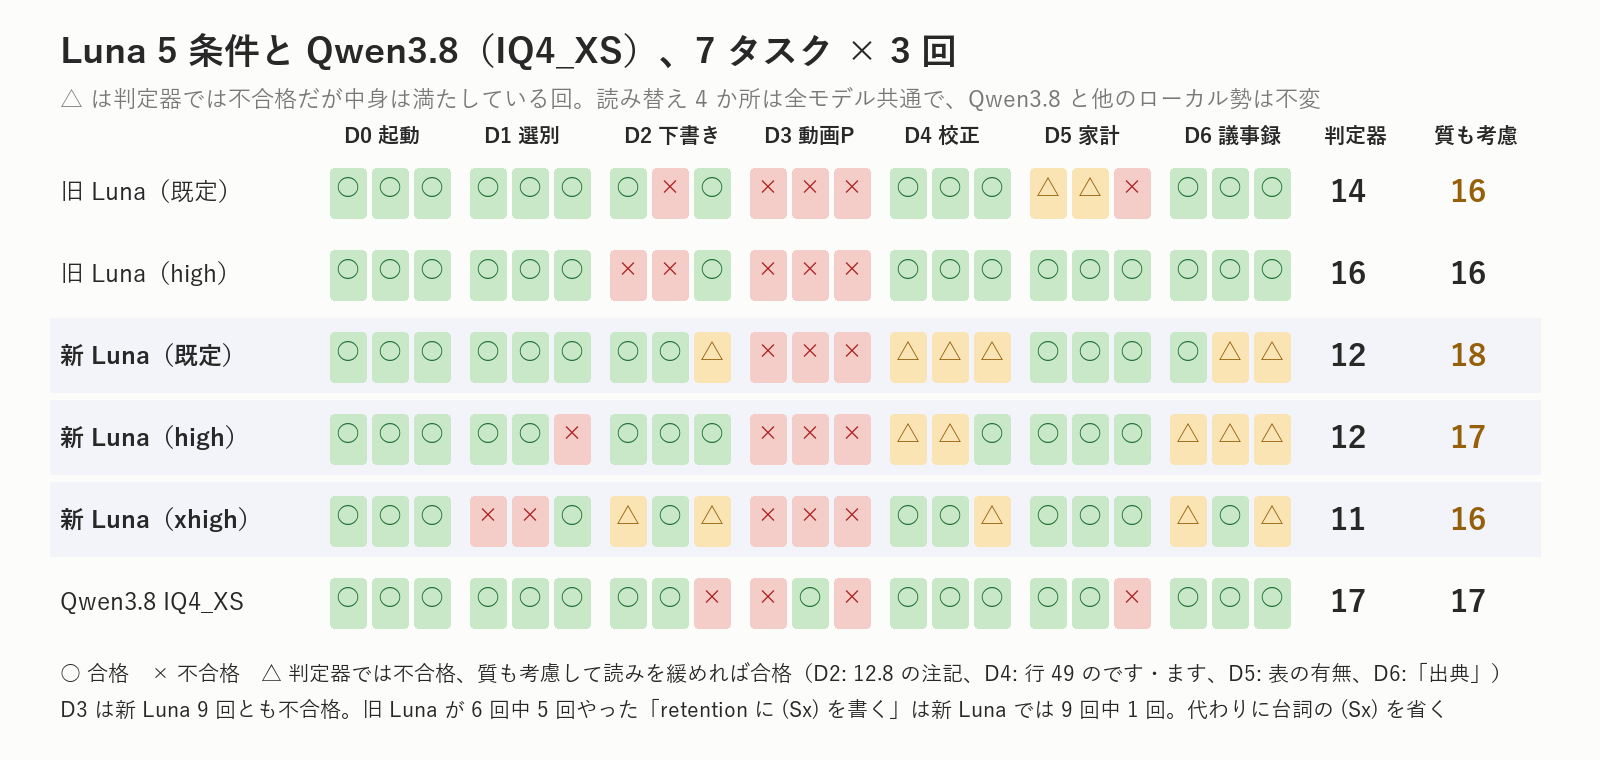
ところが、落ちた中身を見ると、旧Lunaが全勝していたD4(校正)とD6(議事録)で、新Lunaが「中身は合っているのに、判定器の読みが厳しくて落ちる」パターンを繰り返していました。Claude Codeが落ちた回を1つずつ読んで、判定器の読みが厳しすぎると言えそうな箇所を洗い出し、判定器とは別のスクリプトで「緩く読んだら合否がどうなるか」を再計算しました。
| 読み替え | 何が起きたか | なぜ厳しすぎると言えるか |
|---|---|---|
| D4 校正:行49「動かしてみたい!」を、です・ます違反として「動かしてみたいです!」に直す指摘を、減点しない | 新Lunaは9回中8回、同じ箇所を同じ直し方で指摘。判定器はこの行の「!」を「指摘しなくてよい箇所(くだけた表現)」として登録していて、そこへの指摘として減点した | 正解表は、同じ種類の「1台だった。」をです・ます違反の正解にしている。「!」は残しているので、指摘の対象は語尾。正解表の漏れと読める |
| D6 議事録:出典の決定を「回答にはFAQのファイル名と更新日を表示する」と書いたら可 | 9回中7回、「出典」という語が落ちた | 表示する中身(ファイル名と更新日)は同じ |
| D2 下書き:表の「12.8 W/mK*」と、注の「*メーカー公称値で未検証」を認める | 判定器は、12.8と「公称/未検証」が同じ段落にあることを求めている | 未検証の値だと明記する、という意図は満たしている |
| D5 家計:「800字以内(表を含む)」を、表必須と読まない | 新Lunaは9回とも表を書いた。旧Lunaの既定走は2回、表なしで落ちた | 前回の記事で「この読みを許容すれば旧Lunaの既定走も16/21」と書いた読み。新Lunaだけ緩めないよう、これも入れた |
4つの読み替えを、全モデルの全runに同じ規則で当てました(この数字を、図と表では「質も考慮」、本文では「緩い読み」と呼びます)。結果は、新Luna 18 / 17 / 16、旧Luna 16 / 16、IQ4_XS 17。IQ4_XSと、他のローカル8モデルは1本も変わりません。
見出しにどちらの数字を使うかも、判断が要りました。判定器どおりの12だけ書けば「新Lunaは後退した」と読まれるし、緩い読みの18だけ書けば「判定器を都合よく変えた」と読まれる。どちらか一方だけだと誤解を招く、というClaudeの提案を受けて、両方を並べることにしました。
もう1つの物差しが、rubric(Claudeが0〜5点で付ける中身の採点)です。新Lunaは4.56 / 4.57 / 4.54で、旧Lunaの4.28 / 4.39より上、IQ4_XSの4.83より下でした。大きく上がったのはD2(下書き)とD5(家計)、下がったのはD6(議事録の「出典」の脱落)です。合格数が下がって中身の点が上がる、というのは、落ち方が変わったということです。
旧Lunaの弱点は直ったのか
3つのうち、2つは直りました。
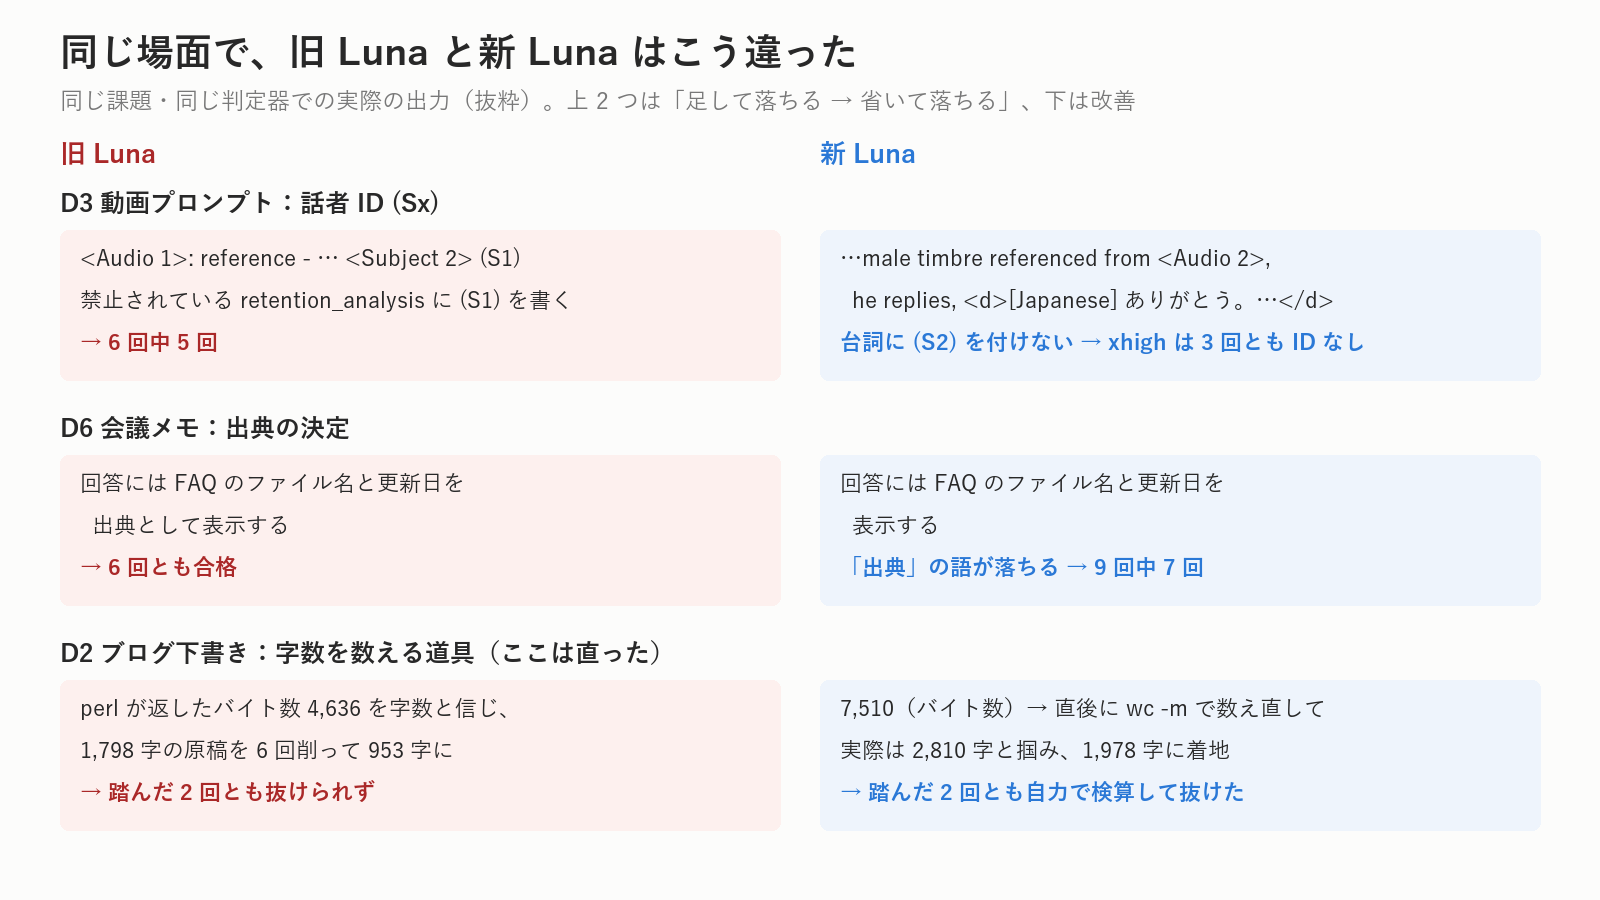
- D2 ブログ下書きの「壊れた物差し」:直った。 旧Lunaは、字数を数えるために自分で書いたperlのコマンドが、UTF-8を扱えずにバイト数を返したのを疑わず、1,798字の原稿を6回削って953字にしました(踏んだ2回とも抜けられず)。新Lunaも9回中2回、同じ罠を踏みました。ところが2回とも、自分で数え直して抜けています。1回は7,510(バイト数)が出た直後に
wc -mで数え直して、実際は2,810字だと掴み、1,978字に着地。もう1回は5,889(バイト数)を見て原稿を縮めすぎたあと、別の方法で数え直して「正確な文字数を数え直すと不足していました」と書き、2,004字まで戻しました。残る7回は、最初から正しい方法で数えています - D5 家計簿:直った。 9回とも合格(旧Lunaは6回中3回)。表を入れ、7月の欠損をどう補ったかを書く。旧Lunaは6回全部が「ジム1件を解約」の最小解でしたが、新Lunaは2回、ジム・動画配信・電子書籍の3件を組み合わせた案を出しました
- D3 動画プロンプト:直らなかった。ただし、落ち方が逆になった。 動画生成AI(MiniMax H3)のガイドラインには「retention_analysisという節に話者ID(S1)を書かない」という禁止事項があって、旧Lunaは6回中5回これを破りました。新Lunaで破ったのは9回中1回だけ。ところが今度は、台詞の話者に(S1)(S2)を付けない側に振れました。ガイドラインは全部の台詞に話者IDを付けるよう求めているので、ここで落ちます。しかも、effortを上げるほど付けなくなる。既定では3つ目の台詞だけ抜ける程度でしたが、xhighでは3回とも、3つの台詞のどれにもIDがありませんでした
D5では、採点していたClaudeが面白い振る舞いを1つ見つけました。新Lunaは9回とも、実行した日(2026年9月23日)を基準日にして、家計簿の10〜12月の記録を「未来の日付のデータ」として不備に数えました。 依頼文は「私の2026年の家計簿です。来年度の固定費を減らす計画を」なので、1年分が揃っている前提で読むのが自然です。月額が一定なので結果は同じでしたが、依頼の前提よりも、実行環境の時計を信じる。9月21日に走らせた旧Lunaは、6回ともこれに触れていません。
新しい落ち方:「足して落ちる」から「省いて落ちる」へ
旧Lunaは、余計なものを足して落ちました。禁止された場所に(S1)を書く。字数を信じて削りすぎる。新Lunaは、必要なものを省いて落ちます。
- D6 議事録:9回中7回、「出典」の語を省く(上の図)
- D1 ニュース選別:highとxhighで1回ずつ、重複した2本の記事を評価表の1行にまとめ、20本を評価すべきところが19行になった
- D3 動画プロンプト:台詞の話者IDを省く。effortを上げるほど省く
D4(校正)だけは向きが違って、「指摘しなくてよい」と書いてある箇所まで指摘します。9回中6回が「(笑」の括弧閉じ忘れを指摘しました(このブログの定番表現なので、指摘しなくてよい、と書いてあります)。旧Lunaも6回中4回指摘していたので、ここは変わっていません。
この「省く」方向は、第三者の評価とも合います。モデル評価サイトのArtificial Analysisは、新Lunaの知識労働の成果物の点が旧Lunaより下がった理由を、「成果物の見せ方と、ルーブリックの必須要素を飛ばしたこと」と説明しています(OrcaRouterのまとめ)。同じ評価で、でっち上げの答え(ハルシネーション)の率は92.6%から76.7%に下がっていて、分からないときは答えずに断る方向に振れた、とも書かれています。慎重になった結果、書くべきものまで省くようになった、というのがClaudeの見立てです。因果は確かめていませんが、今回の落ち方とはよく重なります。
effortは上げても効かない
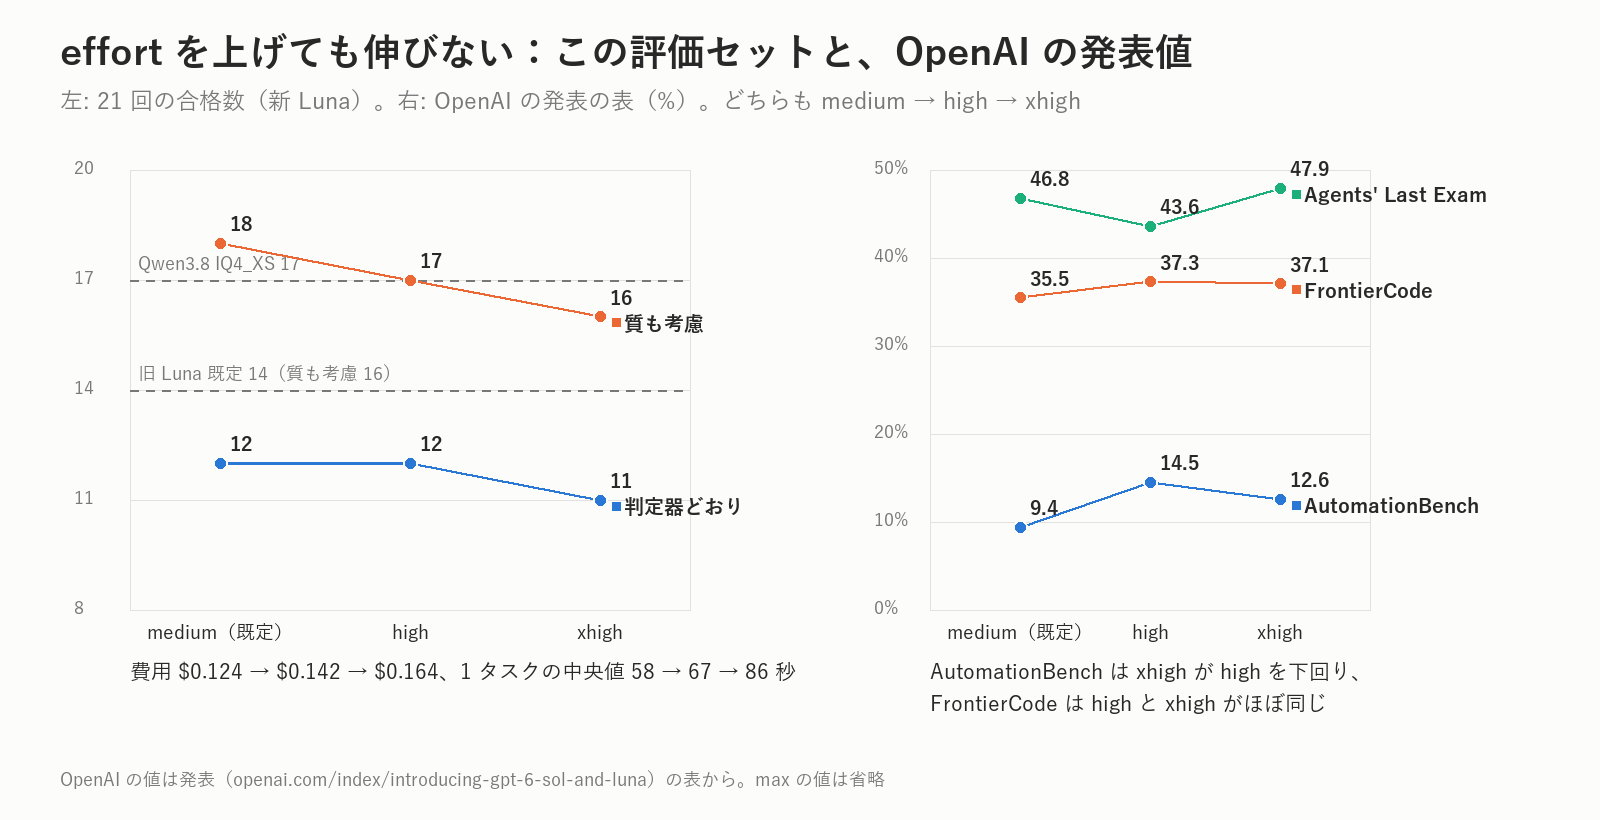
新Lunaは、既定(medium)・high・xhighで12 → 12 → 11。緩い読みでも18 → 17 → 16。費用は1.3倍、時間は1.5倍になるのに、合格数は増えません。highにするとD2(下書き)とD4(校正)で1回ずつ増える一方、D1(選別)とD6(議事録)で1回ずつ減って、差し引きゼロです。
OpenAIの発表を読んだとき、私が気になったのもここでした。effort別の表を見ると、highとxhighでほとんど差のない項目があって、項目によってはhighのほうが上なのです(数値はOpenAIの発表の表から)。
- AutomationBench(業務自動化):high 14.5% → xhigh 12.6%(下がる)
- FrontierCode(コーディング):high 37.3% → xhigh 37.1%(ほぼ同じ)
- Agents’ Last Exam:medium 46.8% → high 43.6%(下がる)
今回の結果は、これを裏付けるものだと思います。この評価セットでは、effortは既定(medium)で十分です。 上げても、待ち時間と費用が増えるだけでした。
OpenAIの発表と照らすと
OpenAIの発表で、GPT-6 Lunaの一番の売りは価格でした。旧Lunaとの比較は最大effort(max)どうしで+0.5〜+4.4ポイント(OSWorldは同値)、1タスクあたりの費用は45〜94%減(Kingy AIの転記、MarkTechPost)。Artificial Analysisの総合指数も、新Luna 37.26、旧Luna 37.32で、差は誤差の範囲です。
性能は横ばい、主な改善はコスト。 発表を読んだときの私の印象は、今回の21回でも崩れませんでした。付け加えるなら、「同じ点数でも、落ち方は変わる」。点数が横ばいでも、どこで落ちるかは入れ替わっています。旧Lunaで回していた作業を新Lunaに切り替えるなら、これまで通っていたところ(今回ならD4とD6)こそ、もう一度確かめたほうがいい。
で、前回の推奨はどうなるのか
前回までの推奨は、「コスパならChatGPTの無償版(Luna)。ローカルが負けているのは速度で、精度ではない」でした。
- コスト:さらに良くなった。21回18円
- 速度:少し悪くなった。33秒が58秒に。それでもローカルの12倍速い
- 精度:物差し次第になった。判定器どおりなら、ローカルの最良(Qwen3.8 IQ4_XS、17/21)がまだ上。質も考慮して読みを緩めれば、新Luna(18/21)が上。前回書いた「ローカルは精度で負けていない」は、もう言い切れません
日常の作業に使うなら、新Lunaを既定のeffortで、という結論です。上げる必要はありません。ただ、「規則を1行も落とさない」ことが大事な作業(今回ならD3の動画プロンプト)は、新旧どちらのLunaにも任せきれない、というのも前回と同じです。
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 新Lunaでの再検証の依頼(観点は「やりたいことが出来るようになったか」「旧Lunaより上がったか」)、VMの起動 | 公式情報の確認(単価、既定effort)、料金集計スクリプトの新単価への対応 |
| 「単価が半分になったので、highで改善が無ければeffortをさらに上げてよい」と、xhighの追加を提案 | 63回(既定・high・xhigh)の実行・回収・判定・採点、トークンと料金の集計 |
| OpenAIの発表を読んで「性能は横ばいで、コスト削減が主」「highとxhighに差が無い項目がある」と指摘、effort別の数値を原文と照合 | 落ちた回を読み、判定器の読みが厳しすぎる箇所を洗い出して、緩い読みを全モデルで再計算するスクリプトを書いた |
| 見出しの数字を「両方並べる」に決定、この記事のレビュー | 発表の二次情報の収集、REPORT、この記事の下書きと図 |
正直、気になっていること
- 緩い読みは後付けです。 Claudeが新Lunaの落ち方を見てから書いた規則なので、判定器の公式の合否は変えず、両方を並べました。4つの読み替えがIQ4_XSや他のローカル勢に影響しないことは確かめましたが、「新Lunaに有利な読み替えを重点的に探した」可能性は残ります(旧Luna側の読み替えは、前回の記事で触れていたD5の1つだけです)
- rubricの採点はClaudeで、私は中身を確かめていません。 タスクと判定器を作ったのもClaudeです。このシリーズを通して同じ構造です
- OpenAIの発表の数値の出どころ。 Claude Codeの環境からは発表ページが開けなかったので、Claudeが転記記事(Kingy AIなど)から数値を集めました。effort別の3項目は、私が発表の原文と照合して一致を確かめています。最大effortどうしの比較と費用の減少率は、転記記事の値のままです
- n=3です。 「(S1)を省く」「出典を省く」の率は、回数を増やせば動きます
- コンテキスト上限は前回と同じ64K(ローカルに揃えたまま)です。新Lunaは本来100万トークン以上を扱えます
まとめ
- GPT-6 Lunaを、旧Lunaと同じ21回で。費用は21回18円(4割減)、1タスクの中央値は58秒(旧Lunaの33秒より遅い)
- 精度は数字が2つ。 判定器どおりなら12/21で後退、質も考慮して判定器の読みを緩めれば18/21でIQ4_XS(17/21)超え。中身の点(rubric)は4.28 → 4.56
- 旧Lunaの弱点のうち、「壊れた物差し」と家計簿は直った。動画プロンプトは、話者IDを「書きすぎ」から「書かなさすぎ」に反転しただけ
- 落ち方が「足す」から「省く」に変わった。慎重になった分、書くべきものまで省く
- effortは上げても効かない(12 → 12 → 11)。OpenAIの発表の表でも、xhighがhighを下回る項目がある。既定のmediumで十分
次にやること
前回から予告している「1行足す」実験は、まだ手を付けていません。新Lunaについて言えば、D3は「全部の台詞に話者IDを付けること」、D6は「決定の文言を変えずに書くこと」と、それぞれ1行足せば通りそうな落ち方です。旧Lunaのときよりも、1行の効き目は大きいかもしれません。
モデルはどんどん入れ替わりますが、評価セットと判定器はそのまま残してあります。次のLunaが出たら、また同じ21回を回します。
安くなって、慎重になって、少し遅くなった。五十路の私のように、LLMも成熟して年取った人間に似てきたなと思いました(笑
コメント