このシリーズで、いちばん誰も通れなかった課題があります。D3、MiniMax H3のRef2VAプロンプトを書く課題です。ガイドライン2本(合わせて4万字)と依頼書を渡して、6セクション・18項目の書式を守ったプロンプトを書かせる。日常タスク編のQwen3.6 35Bが0/3、高パラメータ編の6本も合計1/18(唯一通ったのはqwen3.8-flash-nextの1回、22分かけて)、前回のGPT-5.6 Lunaも既定・highの6回で0。中身は壊滅的ではない。依頼の要素は全部入っていて、英語も自然で、落ちるのは「(Sx)をretention_analysisに書かない」のような規則の1行です。
前々回の量子化編で、EVO-X2の使いどころとしてこう書きました。
特定用途へのファインチューニング、あるいはフロンティアモデルでハーネスを組んで能力不足を補う。たとえば動画生成AIのプロンプト作成は、今回のD3そのものですが、処理をステップに細分化し、書式をテンプレート化して、モデルには選択問題を解かせる形にすれば、安定して正解を出せる可能性があります。「ガイドラインを渡して全部やらせる」から「型に流し込ませる」へ
そして前回の末尾では、もっと安い手を予告しました。
D3の「(Sx)を書かない」は、ガイドラインの該当行を依頼文に引用して渡せば守るのか。(中略)どちらも1行足すだけなので、近いうちに試します。実務では、たぶんこの「1行足す」がいちばん効く対策です。
両方やりました。ローカルモデルは、120B級の遅さ(1タスク11〜22分)が問題になっていたので、57 tok/sで回るQwen3.6 35Bに固定。判定器も題材も元のプロンプトも変えていません。同じ物差しです。
先に結論を書きます。
- 「要点を引用する」は効くが、届かない。 1行のつもりが7行になりました。Qwen3.6は18判定中の通過が10〜15から16〜17に上がったのに、最後の1〜2個が残って0/3(別のバッチで1/3)。Lunaも1/3
- Claudeが手順を設計して「型に流し込んだ」ら、Qwen3.6が3/3。 18判定を54マス全部通過、1回80秒。同じモデル、同じ判定器です
- 効いたのは「規則を守らせる」ことではなく「規則をコードに移す」こと。 ラベル、話者ID、
<d>タグ、タイムスタンプ、接頭辞、マーカーの語彙は、モデルに書かせずハーネスが組み立てる。モデルがやるのは、依頼文からの抽出、選択問題、骨組みに沿った短い英文だけ - ただし、そのハーネスは11回作り直しました。小さなモデルの癖を1つずつ見つける作業で、ガイドラインを読んで設計したのは最初の1回だけ
まず、結果をどうぞ
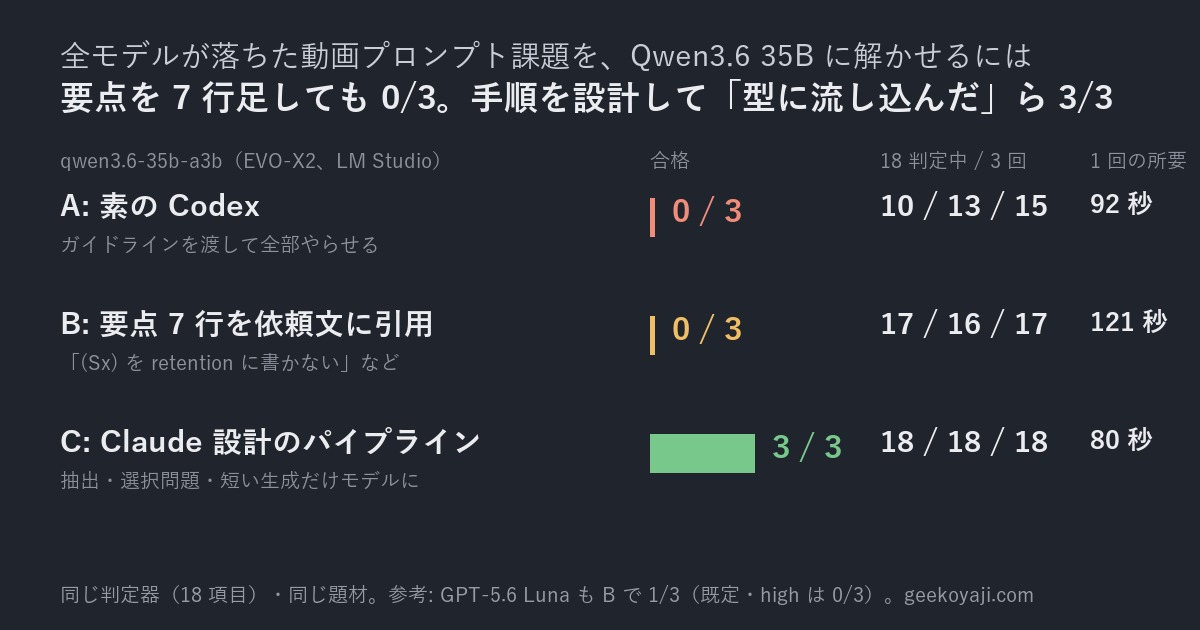
| 条件 | 何を変えたか | 合格 | 18判定中の通過 | rubric平均 | 1回の所要 |
|---|---|---|---|---|---|
| A: Qwen3.6、素のCodex(日常タスク編の走り) | なし | 0/3 | 10 / 13 / 15 | 2.8 | 92秒 |
| B: Qwen3.6、要点7行を依頼文に引用(Codex) | 依頼文だけ | 0/3(別バッチ1/3) | 17 / 16 / 17 | 3.8 | 121秒 |
| C: Qwen3.6、Claude設計のパイプライン(Codex不使用) | 手順・テンプレート・検査 | 3/3 | 18 / 18 / 18 | 4.8 | 80秒 |
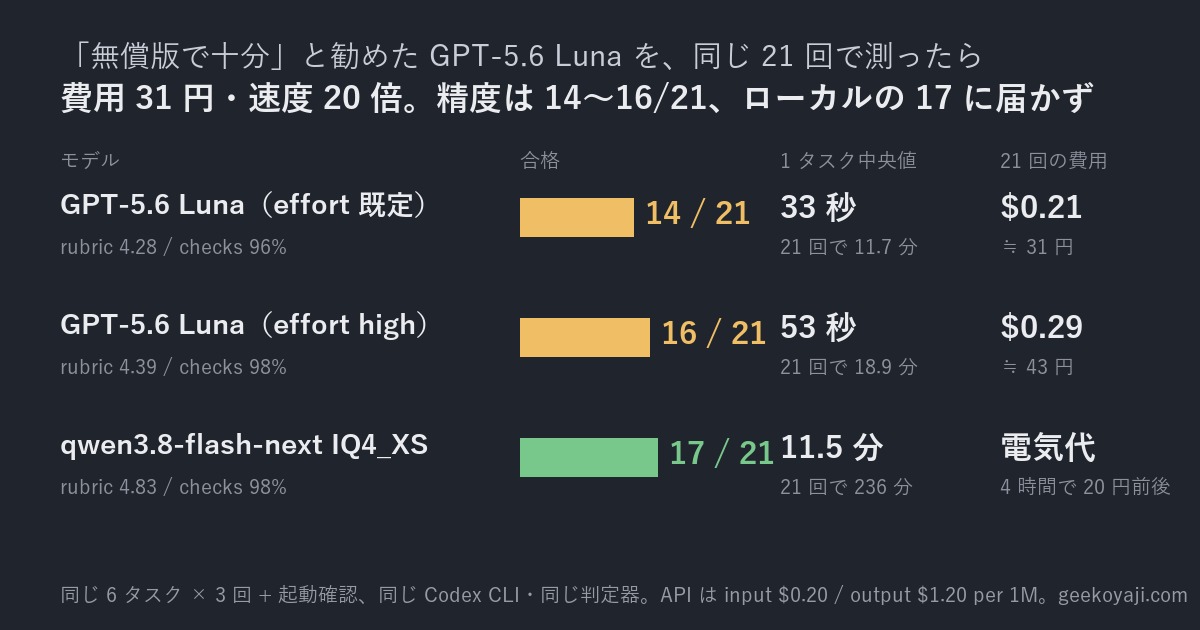
| 参考: Luna既定、素のCodex(前回の走り) | なし | 0/3 | 17 / 15 / 13 | 4.0 | 33秒 |
| 参考: Luna、要点7行を引用 | 依頼文だけ | 1/3 | 18 / 17 / 17 | 4.4 | 47秒 |
| 参考: qwen3.8-flash-next IQ4_XS、素のCodex(高パラメータ編) | なし | 1/3 | 16 / 18 / 16 | 4.4 | 22分 |
そもそもハーネスとは何か、なぜ大事か
ここで言うハーネスは、モデルの周りに置くコード一式のことです。入力を整える、手順を分ける、ツールを呼ぶ、出力を検査する、部品を組み立てる。モデルに仕事を丸投げして上手くいかないとき、モデルが仕事をしやすいようにお膳立てをする周辺環境、と言ってもいい。このシリーズで使ってきたCodex CLIも汎用のエージェント・ハーネスで、今回はその上にD3専用のハーネスをもう一段組みました。
特に効くのは、小さなモデルに難しい仕事を任せるときです。今回の3/3がそれです。ただしフロンティアモデルにも効きます。前回のLunaは、要点を7行足しただけで0/3が1/3になった。コーディング用のハーネス(Codex CLIやClaude Codeそのもの)が、フロンティアモデルの実務での精度を支えているのと同じ話です。
私見を書きます。AI開発の現場では、精度が出ないとすぐにファインチューニングや追加学習を語り始める人がいます。私は、ハーネス設計を同等かそれ以上の優先順位に置くべきだと思っています。理由は、安いからというより、可逆で中が見えるからです。今回11回作り直しましたが、毎回「モデルに何ができないか」が1つずつ分かった。学習はモデルの既定の振る舞いを変える手段で、「規則の1行を守る」「道具の数字を検算する」のような手順の問題には効きにくい。しかも、学習した後も検査と組み立ては結局要ります。順序としては、まずハーネス、それでも残る部分にファインチューニング。私自身、後者もこれから試すつもりでいます。
ここでは動画生成プロンプトの生成をテーマにしましたが、考え方は場面を選びません。字数を数える道具を縛る、計算をコードに渡す、規則をモデルから取り上げる。どれも同じ発想です。ぜひ参考にしてください。
B:ガイドラインの要点を引用する(1行のつもりが7行)
元の依頼文は「ガイドラインに従ってプロンプトを書いてください」だけです。そこに、これまでの落ち方から「特に落としやすい規則」を、ガイドラインの原文を引用する形で足しました。
- 独立した
<Picture N>行を持つのはフレームの起点になる画像だけ(環境や人物の参考写真は<Subject N>の定義内で引用) - summaryの接頭辞は
[keyframe completion + reference generation + audio reference]のように役割の表から組む - retention_analysisのマーカーは固定値(visible 4種、audio 4種)。「Do not write (Sx) in retention_analysis.」
<Audio 1> is the voice-timbre reference for <Subject 1> (S1).の形で話者IDを再利用する- 台詞は
<Subject 2> (S1) says, <d>[Japanese] …</d>。話者IDは発話ごとに毎回、<d>の中は依頼の日本語を一字一句 [Shot 1]は無印、以降は[Shot N] At MM:SS.mmm,- detailed_descriptionは350〜500語、BGMが不要なら
non_diegetic_music: N/A
1行では収まりませんでした。7行です。それでも依頼文に足す文章としては軽い部類だと思います。
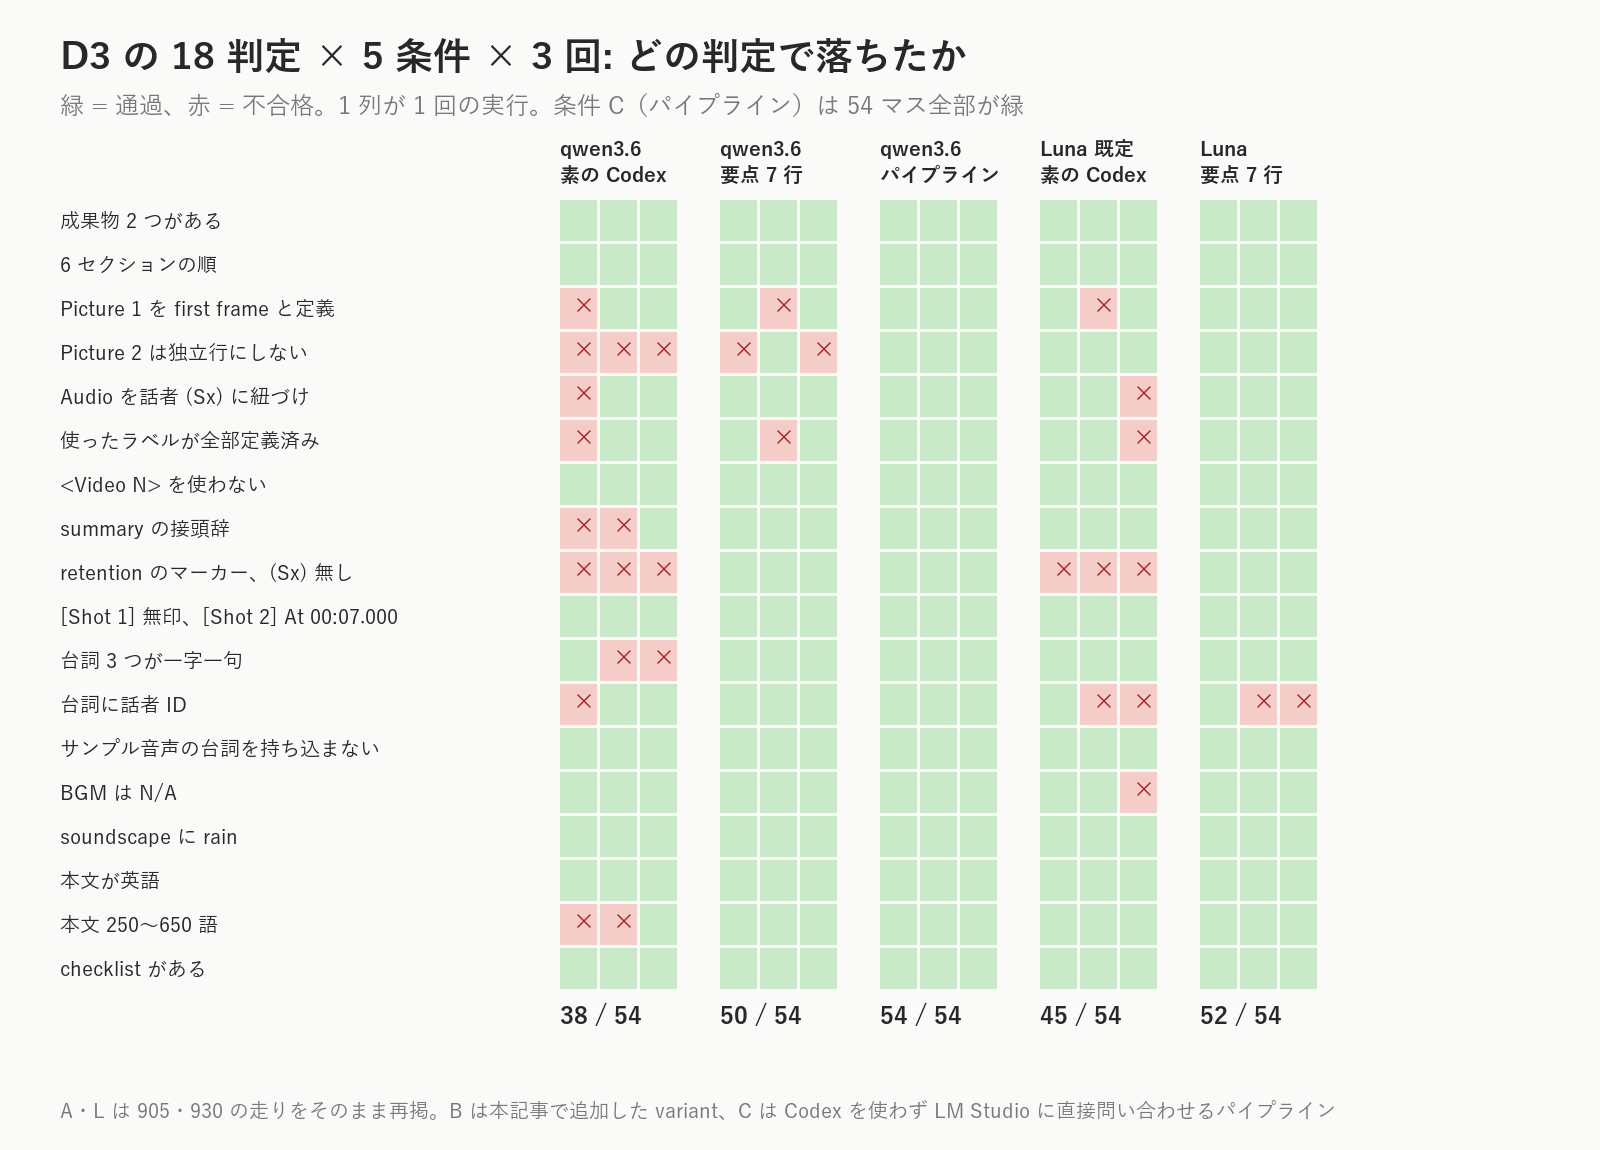
効きました。Qwen3.6は、これまで落ちていた[Japanese]タグ、接頭辞、マーカー、話者IDを全部守るようになった。通過が10〜15個から16〜17個になり、落ちるのは1〜2個。でも、その1〜2個が残る。3回のうち2回は「環境をSubjectとして定義せず、Picture 2をどこにも引用しない」、1回は「Picture 1を独立行で定義せずに本文で使う」。引用した規則の裏側、「独立行を作らない」は守ったのに「じゃあどこで引用するのか」まで届かない。checklist.mdには「Picture 2はSubject定義内で参照」と書いてあって、実際は参照していない。前回書いた「几帳面さ」の問題は、規則を目の前に置いても消えませんでした。
Lunaは1/3。6回中5回で破っていた「(Sx)をretentionに書かない」は、引用したら3回とも守った。予告の問いには「守る」が答えです。代わりに残ったのが、3つ目の台詞「お前も常連か。」に(S2)を付け忘れる、という別の1行でした。
「読ませれば1段上がるが、最後の1つは残る」。 モデルを問わず、そういう効き方でした。実務で使うなら、これで「あと1か所を人が直す」運用にはなる。でも自動化にはならない。
C:Claudeが手順を設計して、Qwen3.6は穴埋めだけ
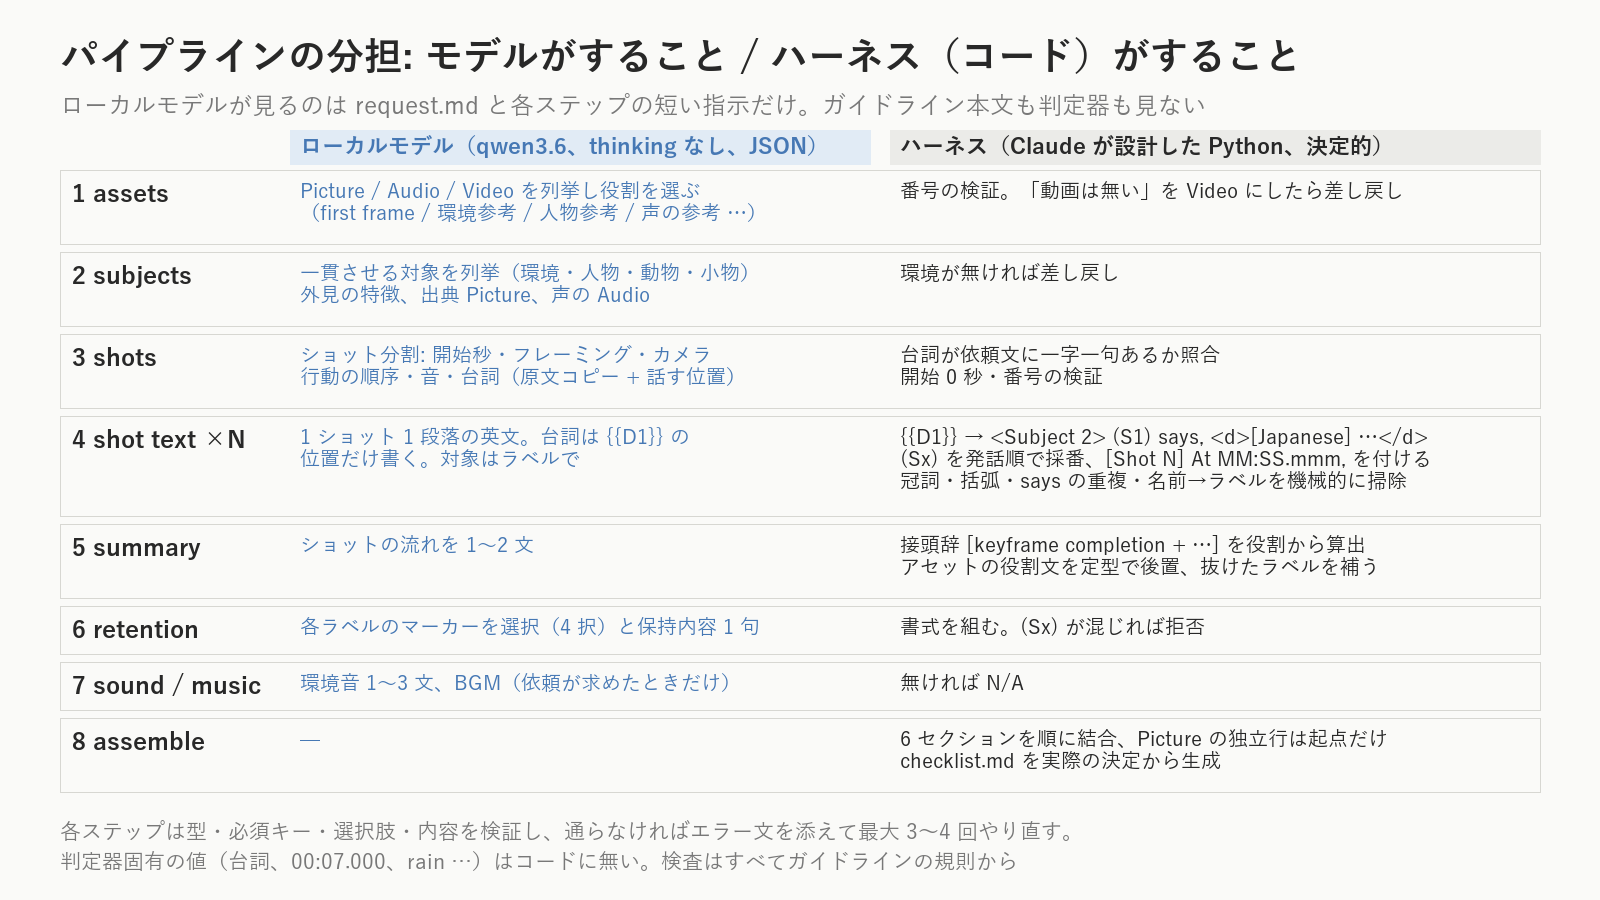
発想は前々回に書いたとおりです。ガイドライン4万字を読んで守るのはフロンティアモデルの仕事、それを守った「型」を作って、小さなモデルには型の穴を埋めさせる。Claude Codeにガイドラインを読ませて、こういう8ステップに分けました。
- assets:依頼文のPicture/Audio/Videoを列挙し、役割を選ぶ(「ショットの最初のフレーム」「環境の参考」「人物の参考」「声質の参考」…)。選択問題
- subjects:一貫させる対象(環境・人物・動物・小物)を列挙し、外見の特徴と出典を書く。抽出
- shots:ショットに分割し、開始秒、カメラ、行動の順序、音、台詞を抜き出す。台詞は原文コピーで、依頼文に一字一句含まれるかをハーネスが照合して、違えば差し戻し
- shot text:1ショット1段落の英文を書く。ただし台詞は書かない。
{{D1}}という差し込み位置だけ書く。<Subject 2> (S1) says, <d>[Japanese] 熱いから気をつけてね。</d>はハーネスが入れる。話者IDの採番も、[Shot 2] At 00:07.000,も、ハーネス - summary:ショットの流れを1〜2文。接頭辞
[keyframe completion + …]はアセットの役割から計算して前に付け、「<Picture 1>はShot 1の最初のフレーム、<Audio 1>は<Subject 2>の声質の参考」という定型文は後ろに付ける - retention:ラベルごとにマーカーを4択で選び、保持内容を1句書く。書式はハーネス。(Sx)が混じったら拒否
- soundscape / music:環境音を1〜3文。BGMは依頼が求めたときだけ、無ければ
N/A - assemble:6セクションを順に結合。
<Picture N>の独立行はフレームの起点になるものだけ。checklist.mdは実際に決めた内容から自動生成(書いていないことを「満たした」と言えない)
各ステップはJSONで答えさせ、型・必須キー・選択肢・内容を検証して、通らなければエラーを添えて最大3〜4回やり直す。判定器の正解(3つの台詞、00:07.000、rain)はコードのどこにも書いていません。検査はすべてガイドラインの規則から書きました。
結果は3/3、1回80秒(LM Studioへの問い合わせ8〜11回、入力9〜11Kトークン、出力3〜4K)。素のCodex実行が92秒だったので、時間は変わらず、精度だけが変わった。
thinkingを止める、という小技
Qwen3.6を素のCodexで走らせたときは「Thinking有効」でした。パイプラインでは止めました。理由は単純で、最初の版(v1)は、アセットの役割を選ぶだけのステップで思考が3,700〜4,000トークンを使い切り、本文が空のまま3回とも失敗したからです。抽出と選択問題に長考は要らない。
ところがLM StudioのAPIからは止められませんでした。enable_thinking=falseもchat_template_kwargsも/no_thinkも効かない(LM Studioのバグトラッカーに同じ報告があります)。効いたのは、assistantメッセージとして空の<think>\n\n</think>\n\nを先に置く(prefill)ことでした。LM Studioは末尾のassistantメッセージの続きを生成するので、思考ブロックが閉じた状態から本文が始まります。reasoning_tokensは0。ただしこの手はJSON Schemaの構造化出力と併用できない(400が返る)ので、JSONの検証は手書きです。
11回作り直した
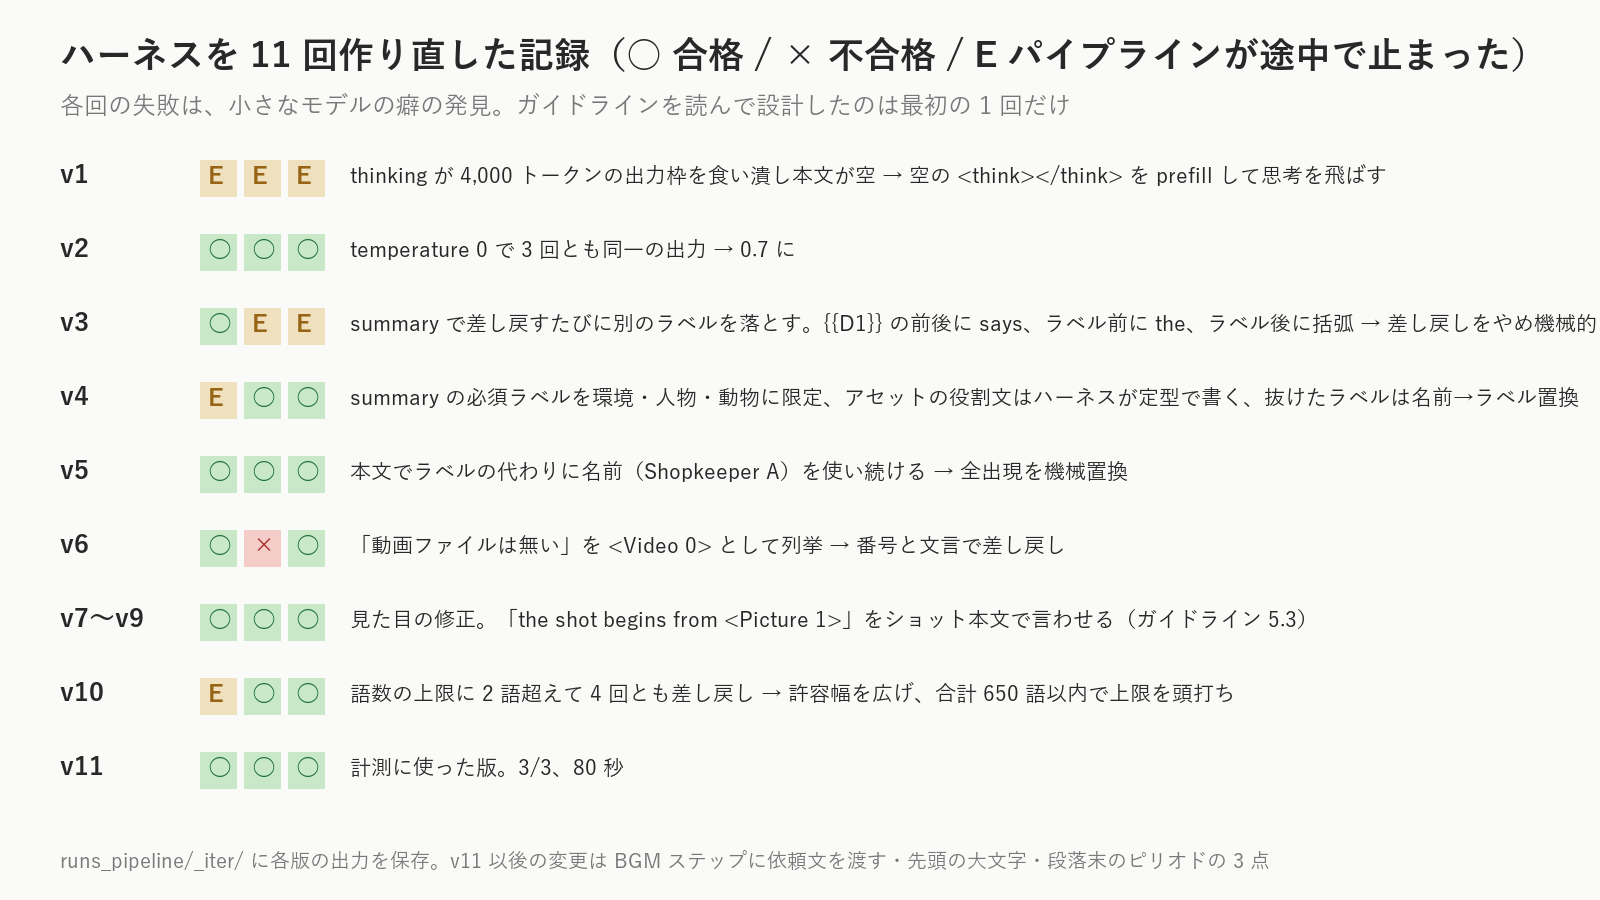
正直に書きます。v2の時点で3/3が出ていました。ただしtemperature 0で3回とも同一の出力で、これでは「3回」の意味がない。0.7に上げたら(v3)、崩れ方が見えてきました。
- summaryで「このラベルが抜けている」と差し戻すと、直すたびに別のラベルを落とす。 8個のラベルを50語に収める作業は、35Bには荷が重かった。対策は差し戻しをやめて、必須ラベルを環境・人物・動物に絞り、アセットの役割文はハーネスが定型で書き、それでも抜けたら本文中の名前をラベルに機械置換する
{{D1}}の前後に「says」を書く、ラベルの前に「the」を付ける、ラベルの後ろに括弧で説明を足す、指示文をそのまま写す。 これも差し戻しより、ハーネス側で機械的に掃除するほうが確実でした- 本文でラベルの代わりに名前(Shopkeeper A)を使い続ける。 全出現を置換
- 「動画ファイルは無い」を
<Video 0>として列挙する。 番号と文言で差し戻し - 語数の上限に2語超えて4回とも差し戻し。 許容幅を広げて、合計が650語を超えない範囲で上限を頭打ちに
計測に使ったのはv11です。学んだのは、小さなモデルには「直させる」より「消す」。差し戻しを重ねると別の所を壊す。冠詞や括弧や重複は、モデルに直させずコードで消すほうが速くて確実でした。
別の依頼でも崩れないか
このハーネスは、この1本の依頼を見ながら作っています。判定器への当て込みは避けたつもりですが、依頼への当て込みは否定できない。なので、まったく別の依頼を1本書いて通しました。早朝のパン屋、3ショット、今度は最後のフレームになる画像、声の参考は店主だけ(客の声のサンプルは無い)、BGMあり。
判定器は無いので目視ですが、At 00:05.000とAt 00:10.000、<Picture 4> is the last frame of [Shot 3]、店主が(S1)で客が(S2)、本文の最後にthe shot ends on <Picture 4>、BGMは「quiet, thin piano」と依頼どおり。構造は崩れませんでした(BGMのステップに依頼文を渡す前の版は「ギターとパーカッション」を創作していたので、そこは直しています)。「別の依頼で1回、構造が崩れないことを確かめた」以上のことは言えません。
評価環境は変えていない
これは書いておかないといけない。今回の作業で、これまでの比較が壊れていないか。
- 判定器(18項目)、題材、元のプロンプトは1文字も変えていません
- Bは新しい変種(
rules)として別の名前で走らせ、Cは別のディレクトリに置きました。これまでの138+42+42回の集計は1件も変わっていません - ハーネスに足したのは「変種名に対応するプロンプトファイルがあればそれを使う」という1行だけで、従来の走りには影響しません
- 唯一やらかしたのは、Bの最初のバッチをホスト側のパイプライン試作と同時に走らせて、LM Studioを取り合った(Parallel 1なので順番待ちになる)こと。合否は影響を受けませんが所要時間が汚れたので、Bは単独で回し直しています。最初のバッチは別に保管して、合格数だけ本文に併記しました
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 記事の企画(「フロンティアモデルが低パラメータモデルでも解けるように手順を考える」「多重制約タスクを単純なタスクの集合体に置き換える」)、ローカルモデルをQwen3.6に固定、評価環境を壊さないという条件 | ガイドライン2本を読んで8ステップの手順・テンプレート・検査を設計、パイプラインの実装と11回の作り直し、thinkingを止める方法の調査 |
| VMとLM Studioの起動、この記事のレビュー | 要点7行の選定、変種の追加、Qwen3.6とLunaの実行・判定・採点、別依頼の作成と目視確認、REPORT、この記事の下書きと図 |
正直、気になっていること
- ハーネスはこの依頼を見ながら作った。 別の依頼で構造が崩れないことは1回確かめましたが、依頼の書き方が大きく違えば抽出ステップから調整が要るはずです
- 11回の作り直しは、私がやったら何日かかったか分かりません。 Claude Codeは午前中で終わらせましたが、「型に流し込む」のコストはここにあります。型を作るのはフロンティアモデルの仕事、という前提です
- thinkingを止めたので、素のCodex実行(Thinking有効)とは条件が違います。 「同じモデル」ですが「同じ設定」ではない。とはいえ、思考が要らない形に問題を分けるのがパイプラインの目的なので、これは設計の一部だと考えています
- rubricの採点者はClaude、ハーネスを設計したのもClaude。 機械判定の3/3は動かしようがありませんが、質の評価は割り引いて読んでください
- n=3です。 3回とも通ったので「安定」と書きたくなりますが、v6のように3回中1回落ちる版もありました。同じv11で10回回せば1回くらい落ちるかもしれない
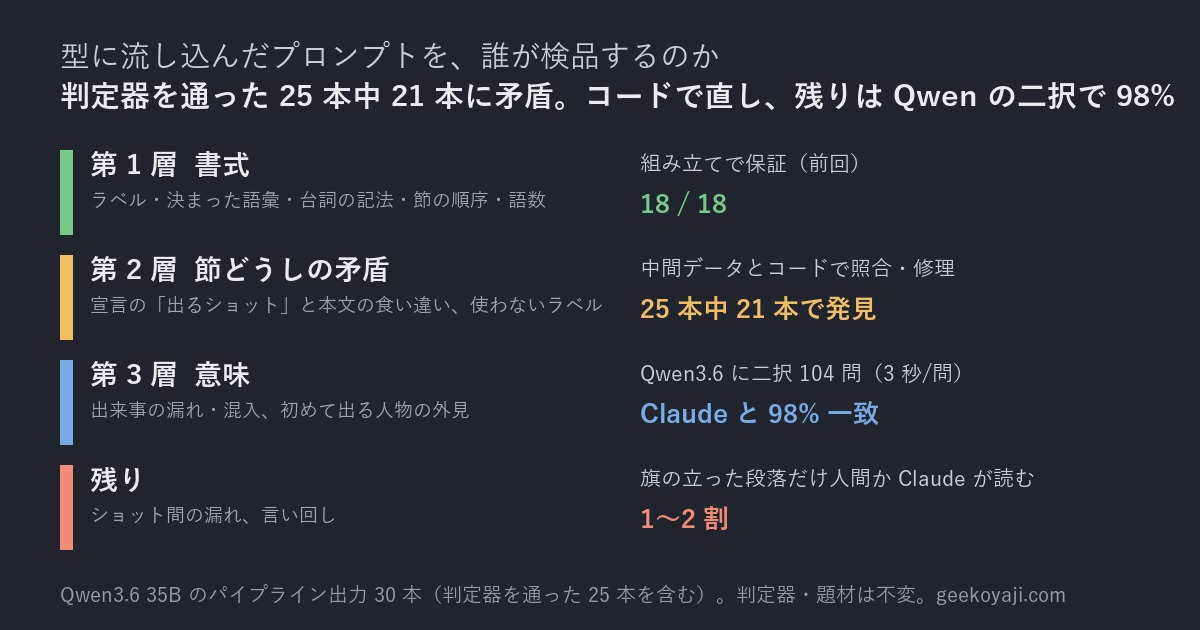
- 完成品を評価して直すループは、ありません。 あるのは「部品ごとの検査と差し戻し」と「決定的な組み立て」の2段で、出来上がったprompt.txtを判定器(や同等の自己検査)に掛けて、落ちた項目を直す段は無い。部品の検査で足りない矛盾(たとえばretention_analysisが「Shot 2にも出る」と言う人物が、本文のShot 2に出てこない)は、この18項目の判定器も見ていません。「じゃあ誰が検品するのか」は、次の記事でやります(→ 公開しました: 検品編)
- 別依頼の「目視」は私ではなくClaudeの目視です
まとめ
- 全モデルが落ちたD3を、Qwen3.6 35Bに解かせる方法を2つ試した
- 要点を引用する(7行): 通過が10〜15個から16〜17個に上がるが、最後の1〜2個が残って0/3(別バッチ1/3)。Lunaも1/3。「読ませれば1段上がるが、最後の1つは残る」
- 手順とテンプレートに流し込む: 3/3、1回80秒。規則はモデルに守らせず、コードが守る
- 小さなモデルには「直させる」より「消す」。thinkingは止める(LM Studioなら空の
<think>をprefill) - 型を作るのはフロンティアモデルの仕事で、11回作り直した。それでも、できてしまえば1回80秒で回り続ける
次にやること
このパイプラインは、動画プロンプトという1つの型に対して作ったものです。私が毎日やっている仕事なので、これは実際に使います。MiniMax H3に投げる前の下書きを、Qwen3.6が80秒で作る。
まず、上に書いた「完成品を誰が検品するのか」。判定器を通っても、セクション同士の矛盾や、ショット間の出来事の漏れは残り得ます。Qwen自身に「評価して直せ」は無理だとして、コードで見つかる範囲と、Qwenに狭い二択で答えさせられる範囲と、人間かフロンティアモデルにしか見えない範囲を切り分けます。
それから、同じ考え方をD5(家計簿の分析と計画)のような「計算を伴う判断」に当てはめられるか。前回の「壊れた物差し」(字数を数える道具を疑わない)を、道具を縛るだけで消せるか。どちらも、規則をモデルから取り上げてコードに渡す話です。
もう1つ。今回はClaudeが型を作り、Qwen3.6が穴を埋め、私は見ていただけでした。フロンティアモデルの「下請け」としてローカルモデルを使う、という前々回の使いどころは、この形で成立しそうです。機密データを含む部分だけローカルに回す、という分業も同じ仕組みで組めるはずなので、それも試します。
EVO-X2は、やっぱり手放しません。仕事の手順さえ教えてやれば、170万円の片翼はまだ働きます(笑
コメント