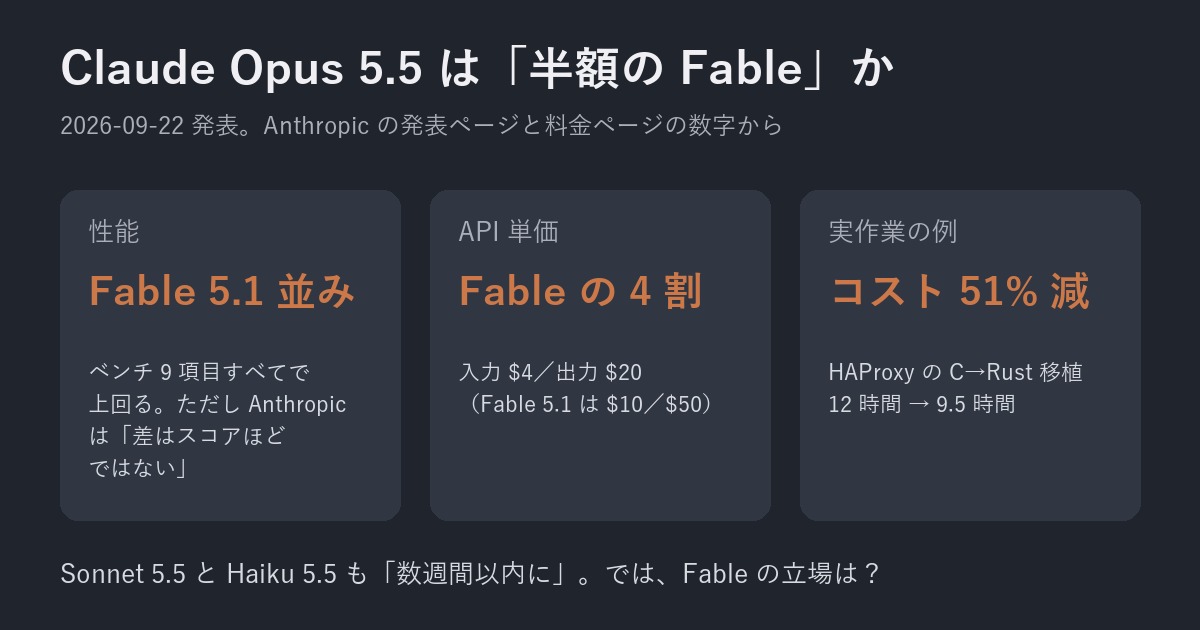
2026年9月22日、AnthropicがClaude Opus 5.5を発表しました。発表文の冒頭には、こうあります。
ほとんどの仕事でClaude Fable 5.1の水準の性能を出し、Opus 5より40%安く動く(発表文冒頭、拙訳)
Fable系は賢い。でも、クレジット(利用枠)の減りが激しく、推論にも時間がかかる。これが私のFable系に対する率直な印象です。そのFable並みが、Opusの値段で手に入るなら、ユーザーとしてはこれ以上うれしい話はありません。
ちなみにこの記事の下書きは、発表翌日のOpus 5.5で動くClaude Codeが書いています。自分の発表記事を自分で要約させるのは少々気が引けますが、数字は発表ページとAnthropicの料金ページから転記させ、私の理解とズレているところは指摘させました。
先に結論です。
- 性能はFable 5.1並み。 発表のベンチマーク9項目すべてで、Opus 5.5がFable 5.1を上回っています。ただしAnthropic自身が「実際の差はスコアほど大きくない」と書いており、「同等」と読むのが素直です
- コストと時間は、Fableより明確に軽い。 API単価はFable 5.1の4割(入力$4/出力$20)。同じ移植作業の実例で、Fableより21%速く、コストは51%少なく終わっています
- Sonnet 5.5とHaiku 5.5も数週間以内に来る。 賢いモデルが指揮を執り、安いモデルに仕事を振る形が、いよいよ現実的になりそうです
- 一方で、Fableを選ぶ理由が見えにくくなりました。 Fableの大型アップデートに期待します
まず、数字をどうぞ
発表ページのベンチマーク表から、Opus 5.5・Fable 5.1・Opus 5の3つを抜き出しました。
| ベンチマーク | 分野 | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | エージェント型コーディング | 66.4% | 55.8% | 52.3% |
| FrontierCode v1.1 | エージェント型コーディング | 54.4% | 50.3% | 48.0% |
| CursorBench 4.0 | エージェント型コーディング | 57.8% | 51.8% | 46.6% |
| GDPval-AA v2.1(Elo) | 知的労働 | 1846 | 1735 | 1708 |
| AutomationBench | 業務ワークフロー | 40.0% | 31.4% | 26.9% |
| Humanity’s Last Exam(ツールあり) | 分野横断の推論 | 67.7% | 65.6% | 63.6% |
| Terminal-Bench-Science 0.1 | エージェント型の科学研究 | 58.7% | 52.6% | 29.0% |
| OSWorld 2.0(部分) | コンピューター操作 | 81.8% | 80.7% | 74.0% |
| Chartography(ツールあり) | グラフの読み取り | 89.0% | 88.4% | 83.4% |
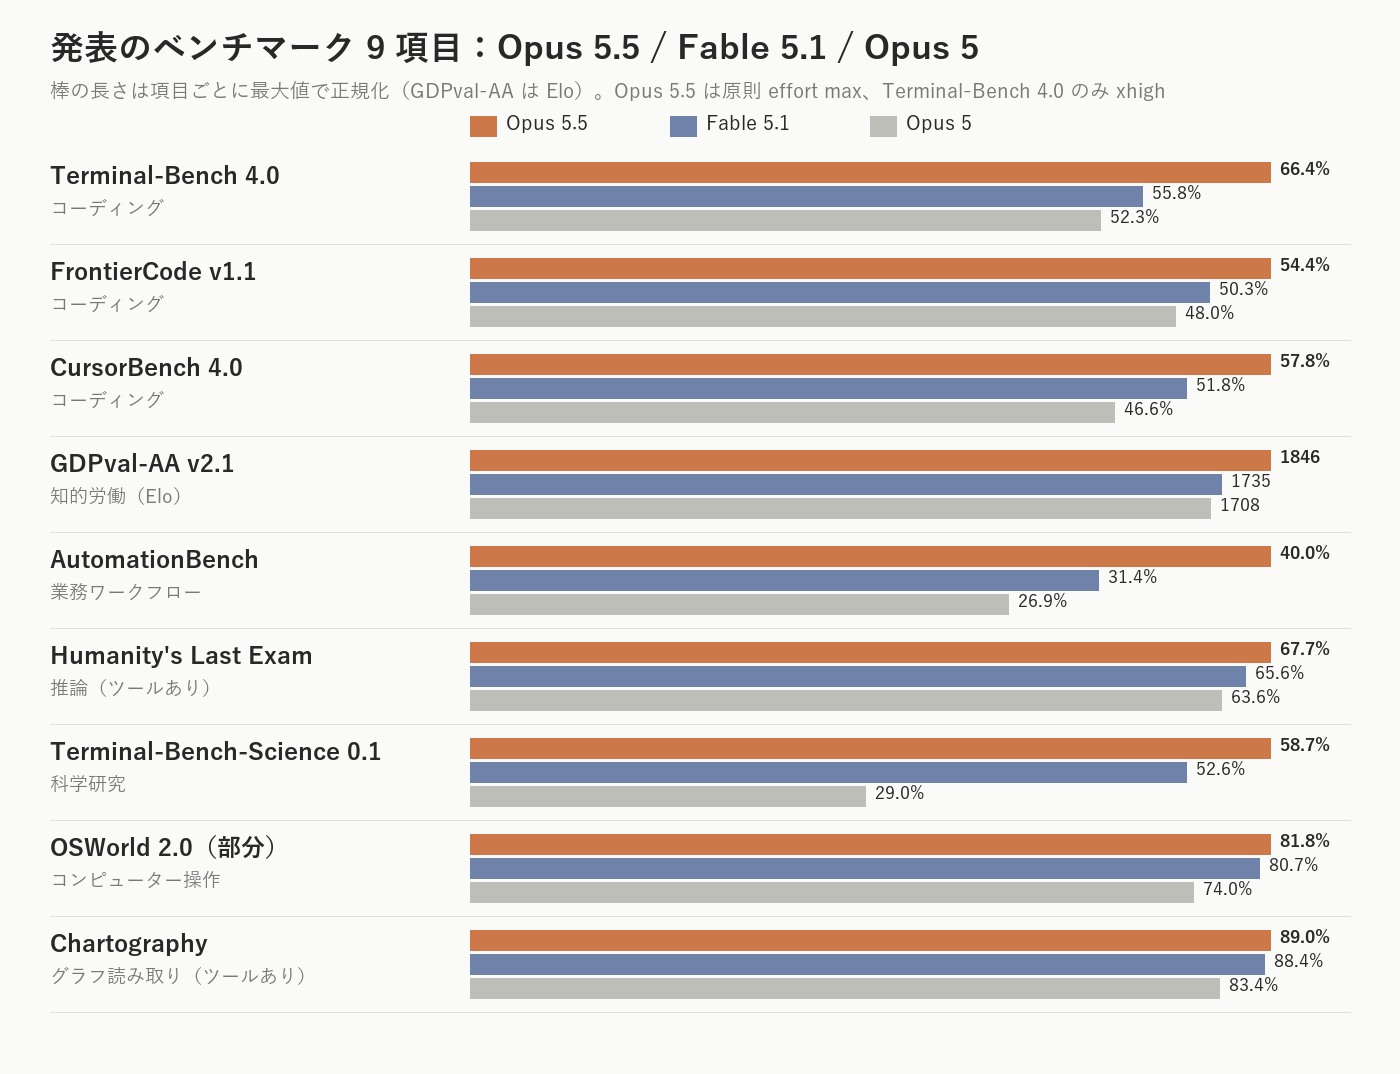
見てのとおり、9項目すべてでOpus 5.5がFable 5.1を上回っています。 差が大きいのはTerminal-Bench 4.0(+10.6ポイント)とAutomationBench(+8.6ポイント)、ほぼ横並びなのはOSWorld 2.0(+1.1)とChartography(+0.6)です。
ただし、読むときの注意が3つあります。
- Anthropic自身が「差はスコアほどではない」と書いている。 発表文には、この性能域ではベンチマークの差が実際の差の指標として当てにならなくなってきた、社内で使った感触ではOpus 5.5とFable 5.1の差はスコアより小さい、とあります。発表文の一行目も「ほとんどの仕事で」Fable 5.1と同じ水準、です。「Fableを超えた」ではなく「Fable並み」と読むのが、Anthropicの説明に沿った読み方です
- 表のOpus 5.5は、原則として最大の思考量(effort max)で測った値。 Terminal-Bench 4.0だけはxhighです。既定のeffortはmedium(中)なので、普段使いの設定でこのスコアがそのまま出るわけではありません
- 他社モデルに負けている項目もある。 表にはOpenAIのGPT-6 Astraも載っていて、AutomationBench(41.4%)とTerminal-Bench-Science(64.6%)ではAstraがOpus 5.5を上回っています
コスト:単価はFableの4割、実作業では約半分
料金はAnthropicの料金ページ(API、100万トークンあたり)から。比較用にSonnet 5とHaiku 4.5も並べました。
| モデル | 入力 | 出力 | キャッシュ読み出し |
|---|---|---|---|
| Fable 5.1 | $10 | $50 | $0.25 |
| Opus 5.5 | $4 | $20 | $0.20 |
| Opus 5 | $5 | $25 | $0.50 |
| Sonnet 5 | $2 | $10 | $0.20 |
| Haiku 4.5 | $1 | $5 | $0.10 |
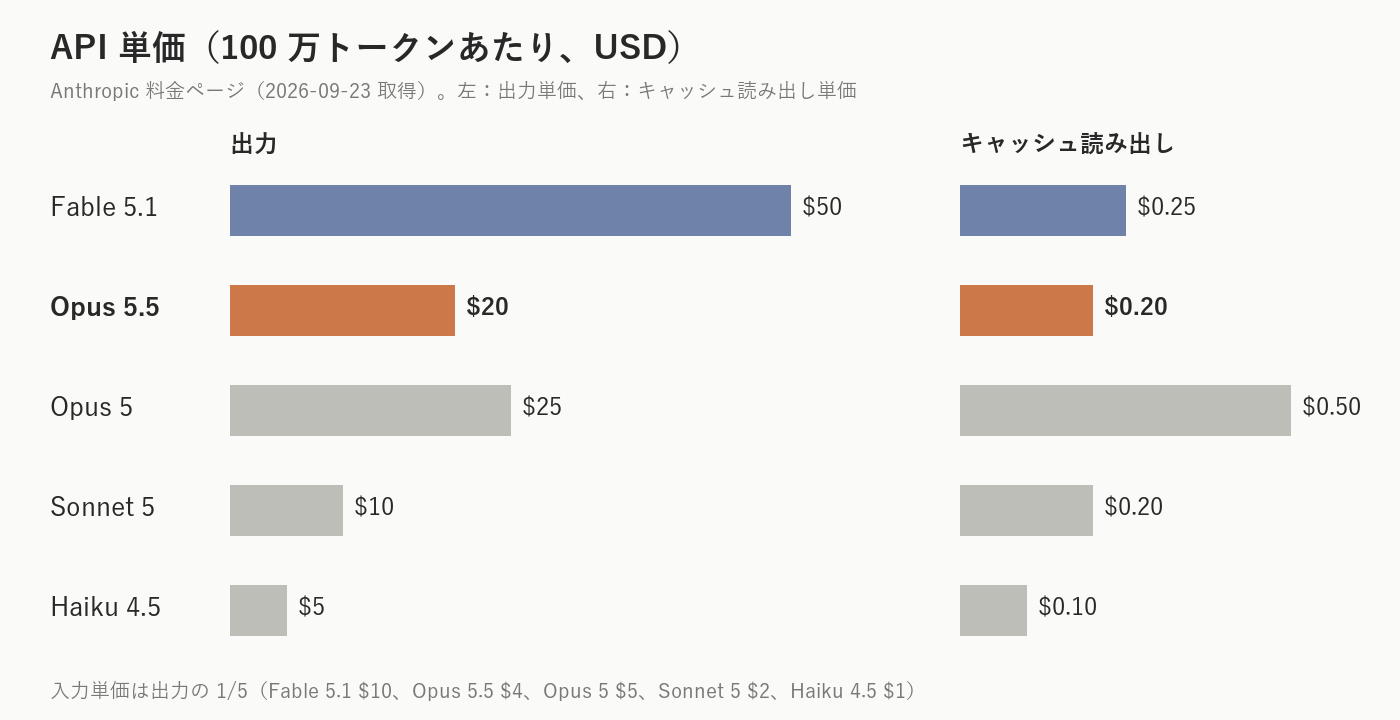
入力・出力の単価は、Opus 5.5がFable 5.1のちょうど4割です。Opus 5と比べても2割安く、キャッシュ読み出しは6割安くなりました。発表文によると、キャッシュ読み出しはエージェント型の作業やコーディングの費用の大半を占め、既定設定の一般的な作業ではOpus 5より4割安くなるとのこと。
実作業の例も1つ載っています。HAProxy(Webの負荷分散で広く使われるソフト)をC言語からRustに書き直させる社内テストで、Opus 5.5とFable 5.1の両方に同じ仕事をさせた結果です。
- 仕上がり: どちらもHAProxy自身の回帰テストをほぼすべて通過
- 時間: Opus 5.5は9.5時間、Fable 5.1は12時間
- コスト: Opus 5.5はFable 5.1より51%少ない
単価は4割なのに、実作業のコスト差が「約半分」に留まるのは、キャッシュ読み出しの単価が$0.20と$0.25でほとんど変わらないからだろう、とClaudeは見ています。エージェント作業の費用の大半がキャッシュ読み出しなら、そこの差が小さい分だけ、全体の差も縮みます。それでも、同じ仕事が半額で、2時間半早く終わる。私にとっては十分すぎる差です。
速度:Opus 5より3割速い
速度の数字は、発表文に次の3つがあります。
- 出力速度はOpus 5より30%以上速い
- コマンドライン系の公開ベンチマークで、Opus 5より多く解きながら、ツール呼び出しは約4割少なく、トークンは半分
- Fastモードは最大2.5倍速(Claude CodeとAPIで利用可。単価は入力$8/出力$40と倍になります)
「推論時間が長い」というFable系への不満にも、HAProxyの例(12時間 → 9.5時間)が答えています。待ち時間が2割縮むのは、毎日使う道具としては地味に大きい。
そしてサブスクリプション(Pro、Max、Team)の利用者には、もう1つうれしい話があります。5時間ごとの利用上限が引き上げられました。 単価が下がって上限が上がる。クレジットの減りに一喜一憂してきた身には、ありがたい話です。
Sonnet 5.5とHaiku 5.5も来る:賢いモデルが指揮を執る時代へ
発表文の最後に、Claude Sonnet 5.5とClaude Haiku 5.5が「数週間以内に」続くとあります。性能・効率・安全性の改善の多くを引き継ぐそうです。
私が期待しているのは、賢いモデルがエージェントの指揮役(コントローラー)になり、タスクの難しさに合わせて、クレジットの消費が小さいモデルに仕事を振る形です。簡単な下調べや定型作業はHaikuに、そこそこの判断が要る仕事はSonnetに、全体の設計と最後の確認はOpusに。これが自動でうまく回るなら、ユーザーが何もしなくてもコスパが最適化されます。
発表文にも、その方向を後押しする一文があります。Opus 5.5は「サブエージェントへの仕事の振り分けが格段にうまくなり、自分の仕事を工夫して確かめる」。どのモデルに振るかまでは書かれていませんが、指揮役としての腕は上がっているようです。
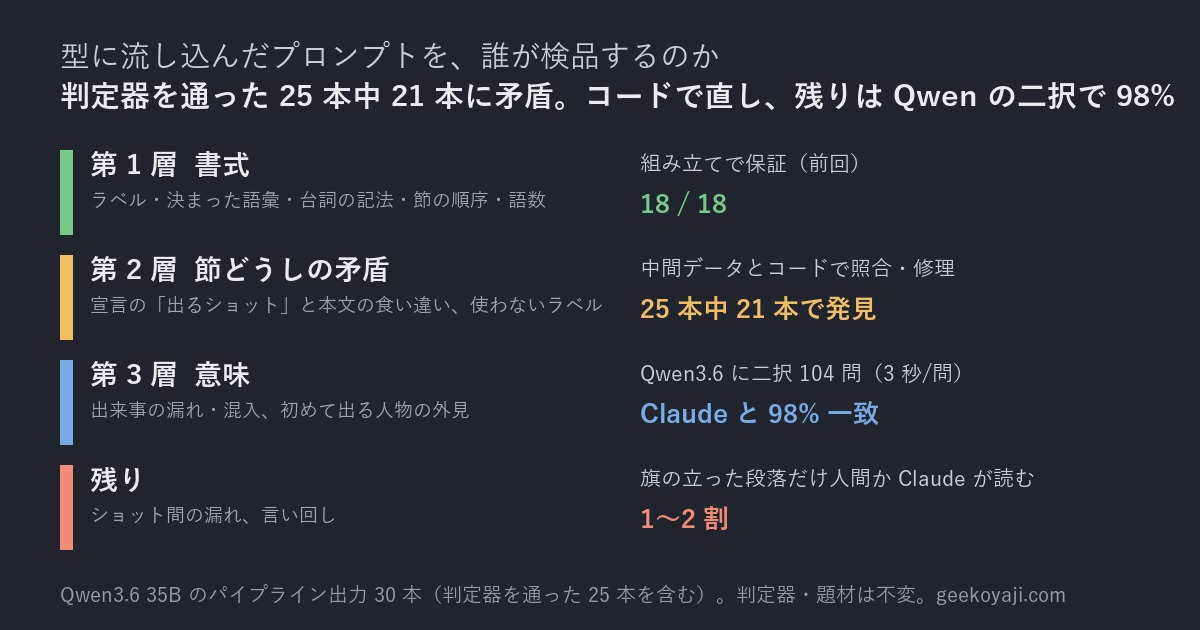
この形がうまくいくことは、私のブログの実験でも片鱗が見えています。ハーネス編では、ガイドラインの要点を依頼文に足しても0/3だったローカルのQwen3.6が、Claudeが設計した段取りに沿わせると3/3まで上がりました。検品編では、Qwen3.6に二択の検査を104問させたところ、Claudeの判定と98%一致しました。賢いモデルが段取りを組めば、安いモデルでも仕事になる。クラウドの中でOpus・Sonnet・Haikuが同じことをやってくれるなら、話はもっと簡単です。
ただし、下書きの段階でClaudeから1つ指摘がありました。
- キャッシュ読み出しの単価は、Opus 5.5とSonnet 5で同じ$0.20。 安いモデルに振って下がるのは主に出力と、キャッシュに乗らない入力の分です
- キャッシュはモデルごとに別。 別のモデルに仕事を振ると、そのモデルは文脈を一から読み直し、キャッシュも一から作ります
エージェント作業の費用の大半がキャッシュ読み出しだとすると、モデルを混ぜて得する分は、定価の比率から想像するより小さくなりうる、というのがClaudeの指摘です。「Opus 5.5のeffortを下げて使う」のと「Sonnetに振る」のと、どちらが安いかは作業次第で、1タスクあたりの費用を測って決めるしかない、ともClaudeは言います。Sonnet 5.5とHaiku 5.5の値段は、まだ発表されていません。
一方で、Fableの立場は
うれしい話ばかりではありません。気になるのはFableの位置づけです。
これまでの整理は分かりやすかった。最高性能ならFable、日常の本命はOpus、軽い仕事はSonnetとHaiku。ところがOpus 5.5がFable 5.1並みの性能を、4割の単価・8割の時間で出してしまうと、Fableを選ぶ理由を、今回の発表から見つけるのは難しくなります。 発表文の「ほとんどの仕事で」の「ほとんど」に入らない仕事が何なのかは、書かれていません。
安全面でも、Opus 5.5はFableと同じ扱いになりました。生物学とサイバーセキュリティの能力がClaude Mythos 5.1に並ぶため、Fable 5.1と同等の安全策を付けて提供するそうです。その結果、日常の開発の中でバグを見つけて直すのは問題ないものの、サイバーセキュリティ系のタスクの多くはOpus 4.8に回されるとのこと。LM Studioの安全性調査のような記事を書く身としては、ここは覚えておきたい点です。
OpusがFableに追いついた今、Fableには「さすがFable」と言わせる大型アップデートを期待したいところです。上がいてこそ、Opusの「半額でFable並み」がありがたく感じられるのですから。
人間がやったこと、Claudeに任せたこと
| 人間(私) | Claude(Claude Code、Opus 5.5) |
|---|---|
| 記事で言いたいこと(4点)を決めた | 発表ページと料金ページを読み、数字を転記した(表は2回取得して一致を確認) |
| 「Fable並みならうれしい」「指揮役に期待」「Fableの立場」という評価を決めた | 私の理解と発表内容のズレを指摘した |
| 公開するかどうかを決める | 下書きと図(3枚)を作った |
| キャッシュ単価と、モデルを混ぜたときの費用について指摘した |
まとめ
- Opus 5.5は、発表のベンチマーク9項目すべてでFable 5.1を上回った。 ただしAnthropic自身が「実際の差はスコアほどではない」としており、「Fable並み」と読むのが妥当
- 単価はFable 5.1の4割(入力$4/出力$20)。 移植作業の実例では、Fableより2.5時間早く、コストは51%少なく終わった
- Sonnet 5.5とHaiku 5.5も数週間以内に来る。 賢いモデルが指揮を執り、安いモデルに振る形に期待。ただしキャッシュ単価の差は小さく、得をするかは測って決める
- Fableの立ち位置は、今回の発表からは見えにくくなった。 大型アップデートに期待
「高いけど賢い」から「安くて賢い」へ。ユーザーとしては、この流れを歓迎しない理由がありません。Sonnet 5.5とHaiku 5.5の登場を楽しみに待ちましょう。
Fableよ、Opusの背中が近いぞ。
コメント