10月15日、NVIDIAがNemotron 3.5 Super VLを公開しました。総パラメータ120B、1トークンあたりに使うのは12BのMoEで、画像・文書・動画も読めるマルチモーダルのモデルです。量子化したファイルは70GBほど。128GBの統合メモリ機に、ちょうど収まる大きさです。
前の世代のNemotron 3 Superは、9月の6モデル比較で7/21でした。「計画のJSONだけ出して実行しない」回があり、25分の時間切れも5回。正直、印象はよくありませんでした。一方、同じ比較で私のEVO-X2(128GB)の最良になったのが、Qwen3.8 Flash Nextの17/21です。
新しいNemotronは、Qwenに追いつけたのか。Claude Codeに頼んで、9月とまったく同じ条件(同じEVO-X2、同じLM Studio、同じCodex CLI、同じ題材・プロンプト・判定器)で21回を解かせました。
先に結論を書きます。
- 合格数は17対17の同点。 前の世代の7/21から、10本も増えました。時間切れは0回
- 中身はQwenが上。 モデル名を伏せた採点で、5点満点のQwen 4.75に対してNemotron 3.5は3.65。判定器が機械的に数えた数値でも、同じ向きでした
- 速さはNemotronが上。 生成速度は1.35倍(27.4 tok/sと20.3 tok/s)、1タスクの中央値は約9分(Qwenは11.5分)
- メモリにも余裕がある。 測定中の空きメモリは最低でも26GB(Qwenは6.6GBまで減った)
- 速い理由はMTP。 Nemotronは、次の数トークンを小さな頭で予想する「先読み」を持っていて、LM Studioでは最初から効いていました。予想の8割が当たっています
まず、結果をどうぞ
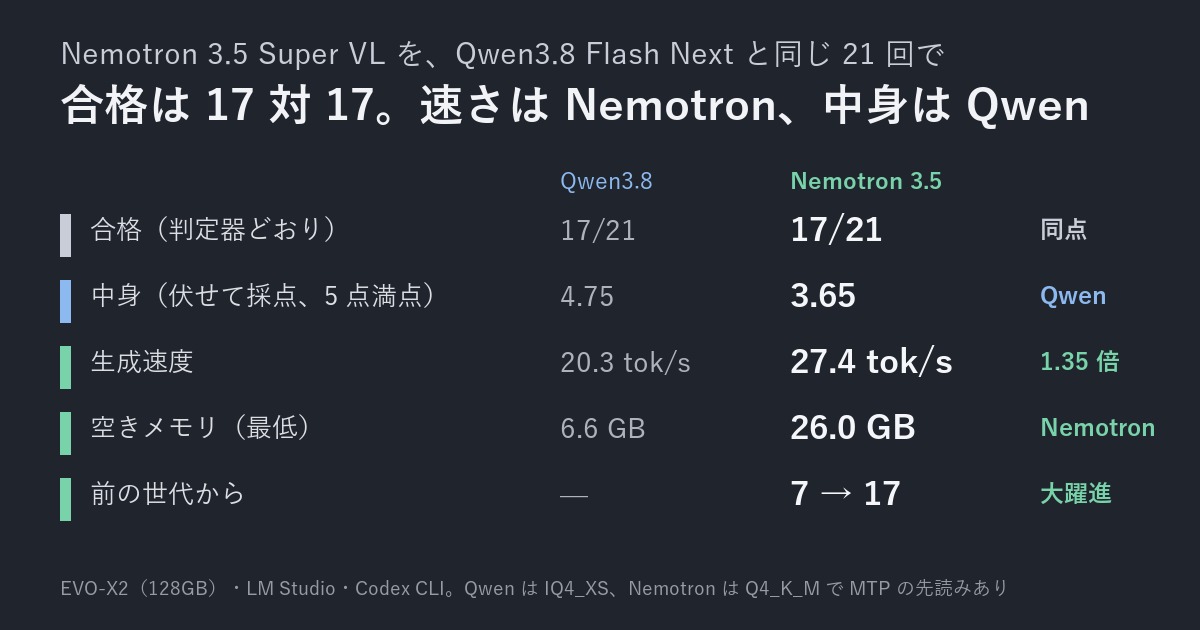
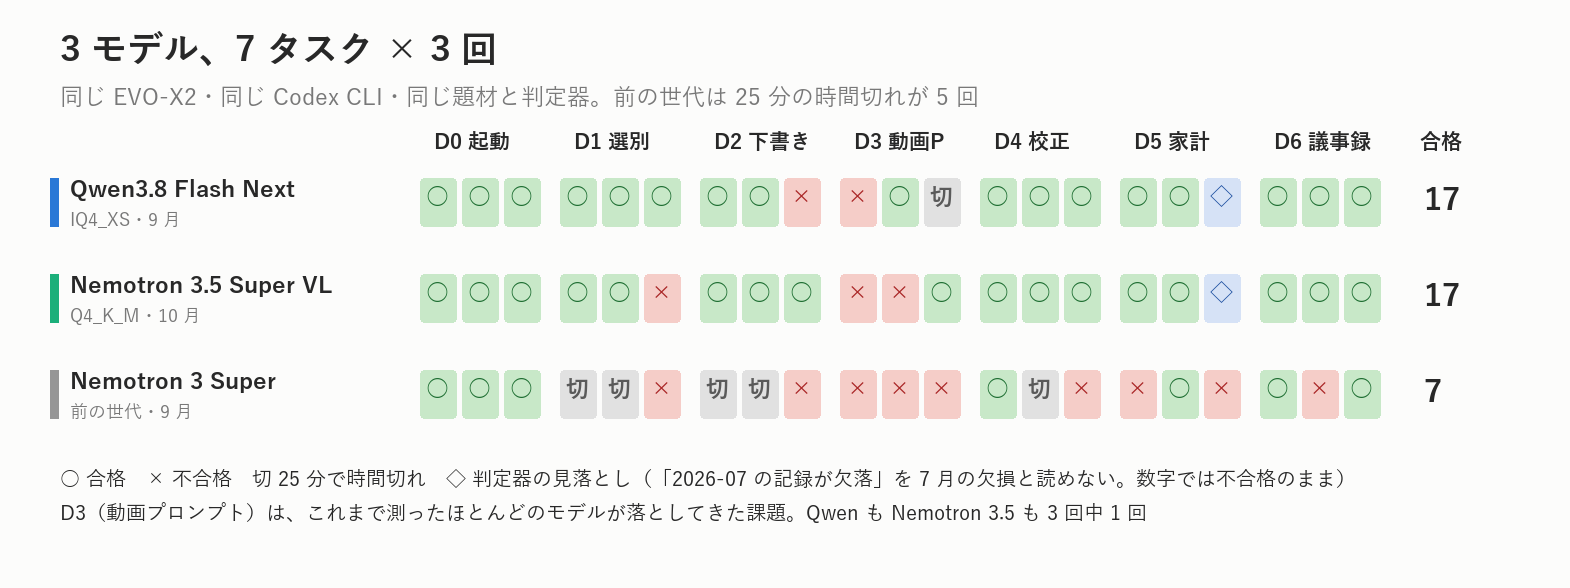
| モデル | 合格(判定器どおり) | 時間切れ | 1タスクの中央値 | 21回の合計 | 生成速度 | 中身(伏せて採点) |
|---|---|---|---|---|---|---|
| Nemotron 3.5 Super VL(Q4_K_M) | 17/21 | 0 | 約9分 | 182分 | 27.4 tok/s | 3.65 |
| Qwen3.8 Flash Next(IQ4_XS) | 17/21 | 1 | 11.5分 | 236分 | 20.3 tok/s | 4.75 |
| Nemotron 3 Super(前の世代) | 7/21 | 5 | 約10分 | 265分 | 16 tok/s(9月) | 2.14 |
生成速度は、NemotronとQwenを今日、同じエンジンで測った値です(前の世代だけ9月の値)。Qwenの21回は、9月の記録をそのまま使いました。理由は条件の節に書きます。
条件:9月と同じ。ただし、自分で作った門番に止められた(笑
モデルの読み込みの設定(コンテキスト65,536、並列1、GPUに全部載せる)、Codex CLI 0.155.1、題材、プロンプト、判定器、25分の打ち切りは、9月と同じです。NemotronはLM Studioのlmstudio-community版のQ4_K_M(70.1GB)、QwenはUnslothのIQ4_XS(94.6GB)で、どちらも4bit級です。
Qwenは測り直していません。重みは9月から変えていないので、合否はそのまま比べられると考えたからです。ただ、LM Studioは0.4.24から0.4.26に、推論エンジン(ROCm)も版が上がっていました。そこで速さだけは、今日、同じエンジンで2つのモデルに同じ文章を書かせて測り直しました。Qwenは9月の18 tok/sから20.3 tok/sへ、エンジンの更新だけで1割ほど速くなっていました。
準備では、つまずきが2つありました。
1つ目は、10月に見つけたCodexの既定の変化です。Codexの本体は同じなのに、計画を立てる道具(update_plan)を既定で出さなくなっていました。Claude Codeがこの道具を明示的に有効にして、Codexがモデルに渡す指示文が9月と一字一句同じになることを確かめてから回しています。
2つ目は、自業自得です。VMからLM Studioに、まったくつながりませんでした。Claude Codeが調べると、原因はホストのファイアウォールの規則でした。ローカルLLMのエージェントを「隔離+門番」で動かす記事で入れた、「門番を通らない接続はLM Studioに届かせない」規則です。自分で作った門番に、自分のベンチが止められていました(笑 測定のあいだだけ私が規則を無効にして、終わってから戻しました。
精度:合格数は同点。落ち方も似ている
| タスク | Qwen3.8 | Nemotron 3.5 | 前の世代 | Nemotron 3.5で何が起きたか |
|---|---|---|---|---|
| D0 起動確認 | 3/3 | 3/3 | 3/3 | — |
| D1 ニュース選別 | 3/3 | 2/3 | 0/3 | 1回、古い記事を「古い」と書きながら最高点にし、要約も80字を超えた |
| D2 ブログ下書き | 2/3 | 3/3 | 0/3 | 3回とも合格 |
| D3 動画プロンプト | 1/3 | 1/3 | 0/3 | 詳しい描写の語数が足りない回と、書いてはいけない欄に話者IDを書いた回で落ちた |
| D4 校正 | 3/3 | 3/3 | 1/3 | 3回とも合格 |
| D5 家計の計画 | 2/3 | 2/3 | 1/3 | 落ちた1回は判定器の見落とし(「2026-07の記録が欠落」を読めない) |
| D6 議事録 | 3/3 | 3/3 | 2/3 | 3回とも合格 |
D3(動画プロンプト)は、これまで測ったほとんどのモデルが落としてきた課題です。QwenもNemotron 3.5も3回中1回通しました。D5で1回ずつ落ちているのは、前回見つけた判定器の見落としで、両方とも報告書には7月の欠損がはっきり書いてあります。これを数えても18対18で、やはり同点です。
前の世代のNemotronにあった「計画だけ出して実行しない」「同じ作業を繰り返して時間切れ」は、21回で一度も出ませんでした。
中身:合格の線は越える。でも浅い
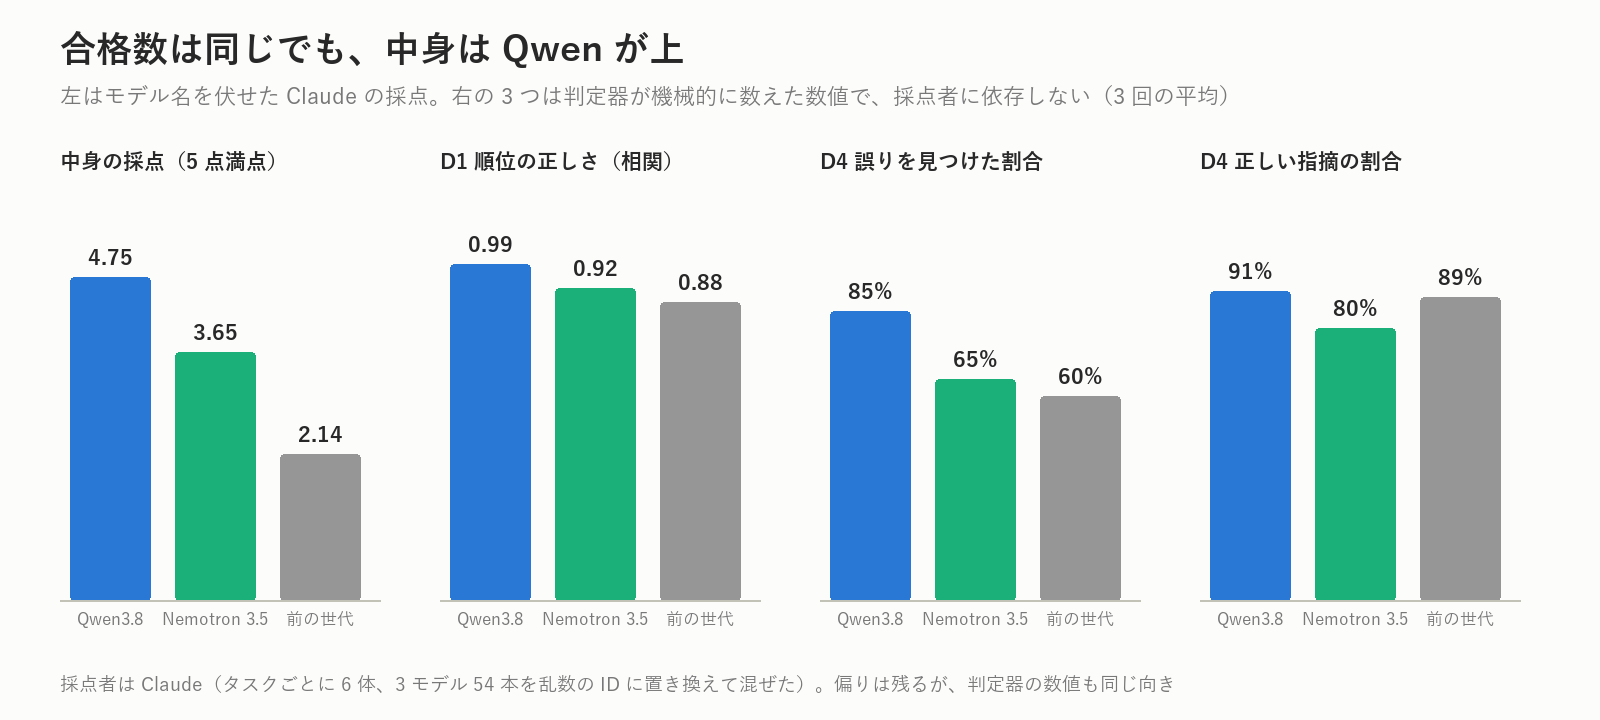
合格・不合格とは別に、Claudeが成果物の中身を0〜5点で採点しています。採点者のClaudeがモデル名を見てしまわないよう、Claude Codeは3モデルの答え54本を乱数のIDに置き換えて混ぜ、タスクごとに別々のClaude(6体)に採点させました。どの答えがどのモデルのものかは、採点したClaudeには見えていません。
| 中身の採点(0〜5) | D1 選別 | D2 下書き | D3 動画P | D4 校正 | D5 家計 | D6 議事録 | 平均 |
|---|---|---|---|---|---|---|---|
| Qwen3.8 Flash Next | 5.00 | 4.67 | 4.25 | 4.92 | 4.67 | 5.00 | 4.75 |
| Nemotron 3.5 Super VL | 3.17 | 3.58 | 4.08 | 3.42 | 2.92 | 4.75 | 3.65 |
| Nemotron 3 Super(前の世代) | 1.17 | 1.67 | 2.75 | 2.83 | 1.25 | 3.17 | 2.14 |
Claudeの採点メモによると、Nemotron 3.5の減点はこんな所でした。
- D1 ニュース選別:AI向けの指示がこっそり仕込まれた記事を、3回とも何も触れずに最高点にしていた(指示そのものには従っていない)。選んだ理由も、記事の中身の言い換えが中心
- D4 校正:原稿の中の事実の食い違い(RAIDの構成、購入した月)を見落とす。「指摘しなくてよい」と書いてある「(笑」を指摘した回もある
- D5 家計の計画:変更が1〜2件の小さな計画が多く、候補を洗い出して比べる段階が薄い(3回中1回はジムの解約だけ)
- D6 議事録:ここはQwenとほぼ同じで正確
採点者がClaudeなので、偏りは残ります。そこで、判定器が機械的に数えた数値も並べました。D1の順位の正しさ(正解との順位相関)はQwen 0.99に対して0.92、D4で仕込んだ誤り20件を見つけた割合は85%に対して65%。こちらも同じ向きです。合格の線は越えるけれど、Qwenほど丁寧ではない、というのが今回の中身の評価です。
速さとメモリ:読む重みは多いのに速い。理由はMTPの先読み
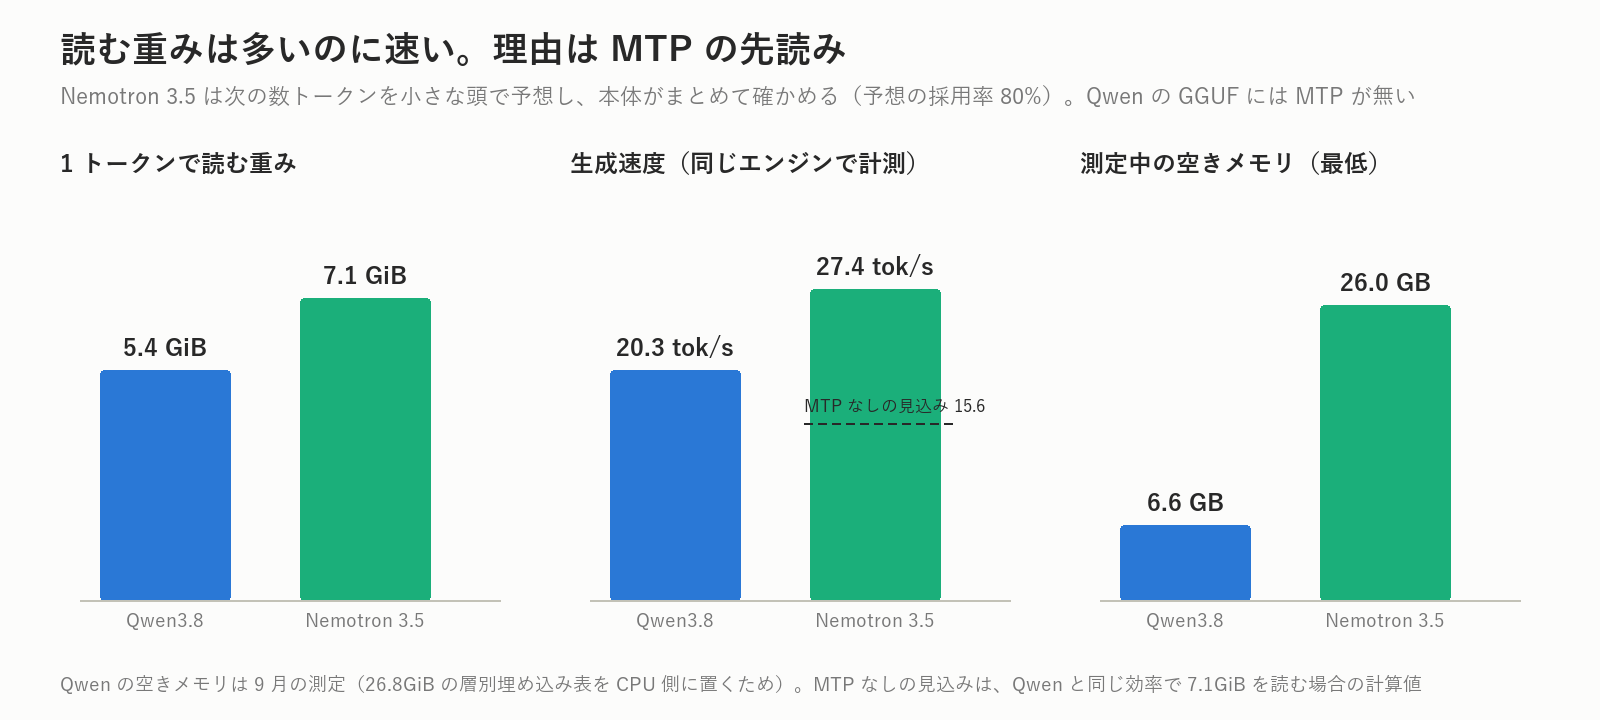
ここは、私の読みが当たったところです。
9月の記事で、私は「速さは、1トークンを作るたびに読む重みの量で決まる」と書きました(量子化編)。統合メモリ機は、メモリから重みを読み出す速さ(帯域)が上限になるからです。ところが、Claude CodeがGGUFファイルの中身から数えると、Nemotron 3.5が1トークンで読む重みは7.1GiBで、Qwenの5.4GiBより多い。それなのに、生成はQwenより1.35倍速いのです。
Claude Codeは最初、「ログには先読みの形跡が無く、原因は分からない」と報告してきました。私は、MTP(多トークン予測)の違いではないかと思いました。Nemotronは、次の数トークンを小さな頭で予想する仕組みを持っていて、既定でオンになっているはずです。一方、UnslothのQwen3.8 Flash Nextは、本体のファイルにMTPが入っていません。別ファイルで配られている先読み用のモデル(drafter)もありますが、LM Studioで読むとエラーになります(Unsloth社のアプリ用のファイルのようです)。
そう伝えて調べ直してもらうと、LM StudioのログにはNemotronを読み込むたびに「MTPの下書きを作る」という行が出ていました。最初は、検索結果の上位だけを見て見落としていたそうです。測定中の218回の問い合わせで、先読みした予想の80%が採用されていました。小さな頭が先の数トークンを予想して、本体がまとめて確かめる。当たっていれば、1回の計算で何トークンも進めます。
Claude Codeの計算では、先読みが無ければNemotron 3.5は15.6 tok/sほどのはずで、実測の27.4 tok/sはその1.75倍です。9月の「読む重みの量で決まる」は、1回の計算あたりでは今も正しい。Nemotronは、1回の計算で進む量を増やしていた、というわけです。
メモリの余裕も、はっきり違います。Qwen3.8 Flash Nextは26.8GiBの層別の埋め込み表をCPU側のメモリに置くので、9月の測定では空きメモリが6.6GBまで減りました。動いている間、この機械でほかのことができません。Nemotron 3.5は、21回のあいだずっと26GB以上空いていました。
前の世代からの進化
| Nemotron 3 Super(9月) | Nemotron 3.5 Super VL(10月) | |
|---|---|---|
| 合格(判定器どおり) | 7/21 | 17/21 |
| 時間切れ | 5回 | 0回 |
| 中身の採点(伏せて) | 2.14 | 3.65 |
| 生成速度 | 16 tok/s | 27.4 tok/s(エンジンの更新とMTPの両方を含む) |
| 落ち方 | 計画だけ出して実行しない、同じ作業の繰り返し | 浅いが、最後まで仕上げる |
9月に前の世代を測ってから1か月で、ここまで変わるとは思っていませんでした。
使ってみて思うこと
- 前のバージョンから、大幅に性能が上がったのがうれしい。 7/21から17/21。前の世代を測ったときの「判断は堅実だけど、実行しない」という印象が、きれいに消えました
- 128GBの統合メモリ機を持っている身には、この大きさのモデルが進化するのがありがたい。 70GB級で、26GBの空きを残したまま動く。ちょうど128GB機のためにあるような大きさです
- ローカルLLMの世界で、米国の会社が本腰を入れ始めたのは良いこと。 ここ1年ほど、手元で動く良いモデルといえばQwenをはじめ中国勢が中心でした。10月5日には、米国のReflection AIも501B(1トークンで使うのは23B)のBeamを発表しています(重みの公開は「今月中」の予定で、Claude Codeが調べた時点ではまだでした)。選択肢が増えるのは、使う側にとっていいことです
- 普段使いなら、Nemotronもあり。 中身の点ではQwenのほうが上です。それでも、メモリと速度のバランスが良いので、日々のちょっとした作業ならNemotronで十分だと思いました
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 「QwenとNemotronで同じ性能比較を」と依頼 | 9月の記録と条件の確認、LM Studioとエンジンの版、モデルの量子化と構造の確認 |
| 門番のファイアウォールの規則を測定中だけ無効にし、終わってから戻した | 原因の規則の特定(設定は変えず、私に止める規則を伝えた)、Codexの既定の変化への対策 |
| 「Qwenは重みも変えていないので測り直さない」と判断 | 21回の実行・回収・判定、同じエンジンでの速さの測り直し、1トークンで読む重みの計算 |
| 「速い理由はMTPでは」と指摘、Qwenの先読み用ファイルがLM Studioで使えないことを伝えた | ログからMTPの採用率を集計、モデル名を伏せた採点(6体)、REPORT、この記事の下書きと図 |
| 記事に入れる感想を決めた | 判定器の見落としと、時間切れを合格に数えていた集計スクリプトの抜けの修正 |
正直、気になっていること
- 採点者はClaudeです。 モデル名は伏せましたが、偏りは残ります。判定器の数値も同じ向きなので、順位は動かないと見ています。私は採点の中身を確かめていません
- 量子化が違います。 QwenはIQ4_XS(4.25bit)、NemotronはQ4_K_M(約4.8bit)。Nemotronのほうが量子化で失うものは少ないはずで、それでも中身はQwenが上でした
- Qwenの21回は9月の測定です。 合否は重みと判定器で決まるので大きくは変わらない、と考えて測り直していません
- MTPを切ったNemotronは測っていません。 先読みが無いときの15.6 tok/sは、Qwenと同じ効率を仮定した計算値です
- 「VL」の部分(画像を読む力)は試していません。 今回の題材はテキストだけです
- n=3です。 1本の差は揺らぎの範囲です
まとめ
- Nemotron 3.5 Super VLを、Qwen3.8 Flash Nextと同じ21回で。合格は17対17の同点、前の世代の7/21から大躍進
- 中身はQwenが上(伏せた採点で4.75と3.65、判定器の数値も同じ向き)。Nemotronは合格の線は越えるが浅い
- 速さとメモリはNemotronが上。生成1.35倍、1タスク約9分、空きメモリ26GB以上
- 速い理由はMTPの先読み(採用率80%)。9月の「読む重みの量で決まる」は、1回の計算あたりでは今も正しい
- 中身を取るならQwen、普段使いならNemotronもあり。米国勢が本腰を入れてきたのは、128GB機の持ち主にとって朗報です
中国勢と米国勢が、128GBの机の上で競い合う。いい時代になりました。
コメント