前回、OpenAIのGPT-6 Lunaを、ローカルモデルと同じ21回のテストで測りました。結論は「安くなって、慎重になって、少し遅くなった。性能は横ばい」。その2週間後の10月7日、今度はAnthropicがClaude Haiku 5.5を出しました。
LunaはOpenAIの、HaikuはAnthropicの、それぞれ廉価版のモデルです。しかもAnthropicは、Haiku 5.5の発表ページでGPT-6 Lunaを名指しで比べています。発表の表では、Lunaと比べた6項目すべてでHaikuが上。メーカーの発表値なので、そのまま信じるわけにはいきません。同じ土俵で測るしかありません。
というわけで、Claude Codeに頼んで、Lunaを測ったときとまったく同じ条件(同じVM、同じCodex CLI、同じ題材・プロンプト・判定器)で、Haiku 5.5に同じ21回を解かせました。途中で「Codex CLIはOpenAIのハーネスなので、Haikuには不利なのでは?」と思って、AnthropicのClaude Codeで回した結果も足しています。
先に結論を書きます。
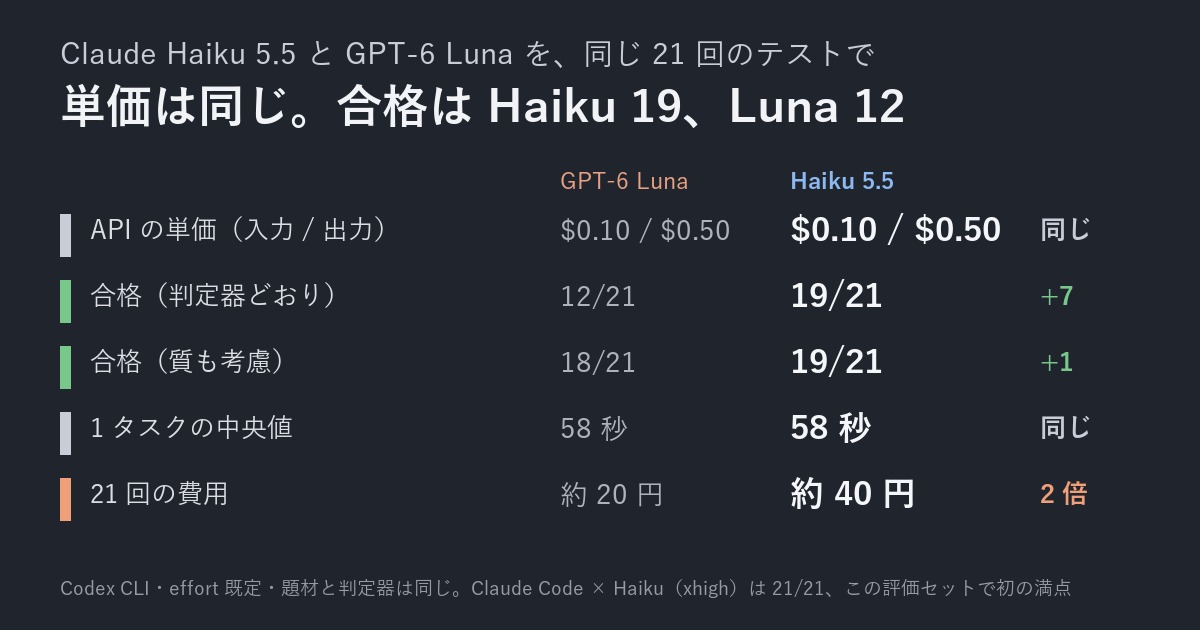
- 単価はまったく同じ。 入力$0.10、出力$0.50(100万トークンあたり)。キャッシュの読み出しも書き込みも同じ値段です
- 合格数はHaikuが圧勝。 同じCodex CLIで、判定器どおりならHaiku 19/21、Luna 12/21。Lunaは中身の質も考慮して読みを緩めても18/21で、Haikuは読み替えなしでそれを上回る
- 速さは同じ、費用はHaikuが2倍。 1タスクの中央値はどちらも58秒。21回の費用はLunaが約20円、Haikuが約40円。Haikuは書く量が多いからです
- Claude Codeで回すと、xhighで21/21。 この評価セットで初めての満点です。Codex CLIのxhighは、会話の上限に何度も届いて17/21に落ちた
- ローカルの最良モデルとほぼ並ぶ。 EVO-X2のQwen3.8 Flash Nextが17/21、RTX 5090のQwen3.8 27Bが19〜20/21。速さはHaikuが4〜12倍
まず、結果をどうぞ
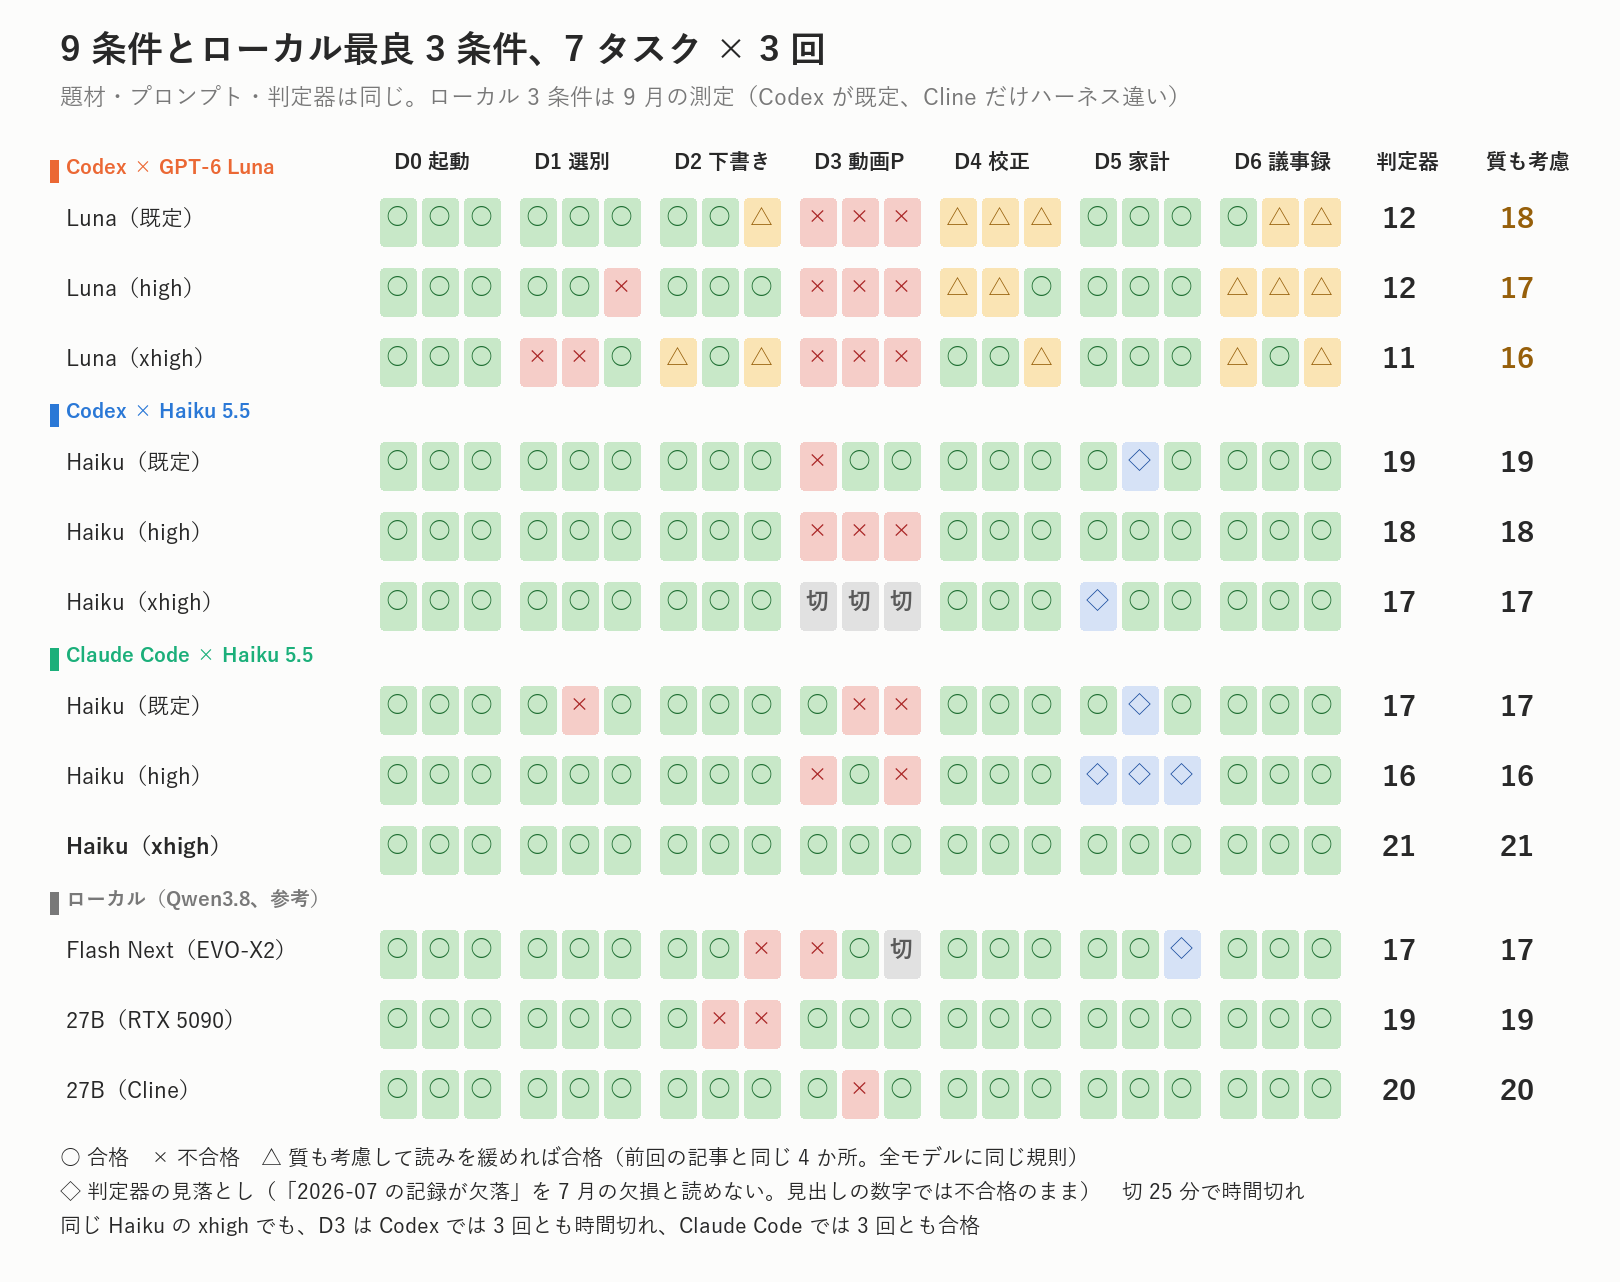
| ハーネス × モデル | 合格(判定器どおり) | 合格(質も考慮) | 1タスクの中央値 | 21回の合計 | 21回の費用 |
|---|---|---|---|---|---|
| Codex × Haiku 5.5(既定) | 19/21 | 19/21 | 58秒 | 19.5分 | $0.270(約40円) |
| Codex × Haiku 5.5(high) | 18/21 | 18/21 | 79秒 | 31.2分 | $0.393(約58円) |
| Codex × Haiku 5.5(xhigh) | 17/21 | 17/21 | 128秒 | 113.9分 | $1.546(約229円) |
| Claude Code × Haiku 5.5(既定) | 17/21 | 17/21 | 56秒 | 20.2分 | $0.232(約34円) |
| Claude Code × Haiku 5.5(high) | 16/21 | 16/21 | 83秒 | 27.5分 | $0.301(約45円) |
| Claude Code × Haiku 5.5(xhigh) | 21/21 | 21/21 | 159秒 | 48.2分 | $0.525(約78円) |
| Codex × GPT-6 Luna(既定) | 12/21 | 18/21 | 58秒 | 18.9分 | $0.136(約20円) |
| Codex × GPT-6 Luna(high) | 12/21 | 17/21 | 67秒 | 24.3分 | $0.155(約23円) |
| Codex × GPT-6 Luna(xhigh) | 11/21 | 16/21 | 86秒 | 27.7分 | $0.178(約26円) |
「質も考慮」は、前回の記事で決めた4つの読み替え(判定器の読みが厳しすぎる箇所)を、全モデルに同じ規則で当てた数字です。Haikuは、この読み替えで変わる回が1本もありませんでした。
ここで前回の記事の訂正を1つ。前回はLunaの費用を$0.124と書きましたが、キャッシュへの書き込みの料金(OpenAIの公式価格で入力の1.25倍。新Lunaなら100万トークンあたり$0.125)を計算に入れていませんでした。Claude CodeがHaikuと同じ規則で計算し直すと、$0.136でした。旧Lunaも同じく$0.21が$0.229になるので、「旧Lunaから4割減」という前回の結論は変わりません。差は1.8円です(震え声 前回の記事にも、訂正を追記しました。
円の換算は、前回までと同じ1ドル148円です。ドル円はこのところ155〜160円あたりで動いているので、「148円は円高すぎない?」と思った方もいるはずです。最初にこのレートを使ったときに、私が見逃していました。いまさら変えると過去の記事と比べにくくなるので、このシリーズでは148円のまま通します。そのうち148円になるかもしれませんし(無責任
単価は本当に同じなのか
まず裏取りから。両社の公式の価格表を並べると、こうなります(2026年10月10日時点)。
| 100万トークンあたり | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|
| 入力 | $0.10 | $0.10 |
| キャッシュの読み出し | $0.01 | $0.01 |
| キャッシュへの書き込み | $0.125 | $0.125(5分保持の場合) |
| 出力 | $0.50 | $0.50 |
| 長いプロンプトの割増 | 27.2万トークン超で入力2倍・出力1.5倍 | 10万トークン超で入力・出力とも5倍 |
出典はOpenAIのモデルページとAnthropicの価格ページです。まるで示し合わせたように、4項目とも同じ。 違うのは長いプロンプトの扱いだけで、Haikuは10万トークンを超えると一気に5倍になります。今回の126回では、Haikuの1回の要求は最大で8.3万トークンだったので、割増には一度もかかっていません。
位置づけも同じです。OpenAIはLunaを「集中した大量処理のための、最も効率の良いモデル」、AnthropicはHaiku 5.5を「これまでで最も安く、最も速く、最も賢い小型モデル」と説明しています。上にはそれぞれGPT-6 SolとClaude Sonnet 5.5・Opus 5.5がいます。廉価版どうしの真っ向勝負、というわけです。
条件:ハーネスはLunaのときと同じ(ただし、通訳を1つ挟んだ)
Lunaを測ったときと同じものは、VM、Codex CLI 0.155.1、題材、プロンプト、判定器、25分の打ち切り、毎回まっさらな作業フォルダ。題材から判定器までは、Lunaのときとファイルの中身が一字一句同じであることを、Claude Codeがハッシュで照合しました。
ただ、Codex CLIはOpenAIの通信形式でしか話せません。そこでClaude Codeが、Codexの要求をAnthropicの形式に訳して、答えを訳し戻す中継(通訳)を書きました。Haiku 5.5は、自分が前に考えた中身(thinking)を一字一句そのまま送り返さないと受け付けない仕組みなので、中継は前の応答を覚えておいて、毎回そのまま送り直します。Codexの63回分、930回のやり取りで、エラーは0回でした。
準備の途中で、Claude Codeがもう1つ見つけました。同じCodex CLI 0.155.1なのに、10月9日のCodexは、Lunaを測った9月23日と違う指示文をモデルに渡していました。 計画を立てる道具(update_plan)が既定で外れていて、その説明の分だけ指示文が3,772字短い。Codexの本体は9月19日から変わっていないのに、です。Claude Codeは、Haikuの回ではこの道具を明示的に有効にして、指示文がLunaのときと一字一句同じになることを確かめてから回しました。同じ版のハーネスでも、日が違えば中身が違うことがある。ベンチマークでは怖い話です。
精度:Lunaがつまずいた所を、Haikuは素直に通す
同じCodex CLIどうしで、タスク別に見るとこうなります。
| タスク | Luna(既定・high・xhigh の9回) | Haiku(同じく9回) | 何が違ったか |
|---|---|---|---|
| D0 起動確認 | 9/9 | 9/9 | 差なし |
| D1 ニュース選別 | 6/9 | 9/9 | Lunaはeffortを上げると、重複した2本の記事を1行にまとめて19行にした |
| D2 ブログ下書き | 6/9(質も考慮9/9) | 9/9 | Lunaは未検証の数値の注記の置き方で落ちた |
| D3 動画プロンプト | 0/9 | 2/9 | Haikuは既定で2回通した(Lunaは0回)。effortを上げると時間切れ(後述) |
| D4 校正 | 3/9(質も考慮9/9) | 9/9 | Lunaは「指摘しなくてよい」箇所まで指摘する |
| D5 家計の計画 | 9/9 | 7/9 | Haikuは、表を付け忘れた1回と、判定器の見落とし(後述)で落ちた |
| D6 議事録 | 2/9(質も考慮9/9) | 9/9 | Lunaは決定の文言から「出典」の語を落とす |
Lunaが判定器の読みの厳しさで落ちていたD2・D4・D6を、Haikuは27回とも判定器どおりに通しました。前回、Lunaの落ち方を「必要なものを省いて落ちる」と書きましたが、Haikuは指示の細部をそのまま守ります。「指摘しなくてよい」と書いてある箇所には指摘しない。「出典を表示する」と書いてあれば「出典」と書く。地味ですが、仕事を任せるうえではここが一番効きます。
D3の動画プロンプトは、これまで測った全モデルが苦しんできた課題です。動画生成AI(MiniMax H3)のガイドラインの細かい規則を全部守らないと通りません。Lunaは前回の9回とも、その前の旧Lunaも6回とも落ちました。HaikuはCodex CLIの既定で3回中2回通しています。同じプロンプトのまま通したクラウドのモデルは、これが初めてです。
判定器の見落としが、もう1つ見つかった
落ちた回をClaude Codeが1本ずつ読んだところ、判定器の側の見落としがもう1つ見つかりました。D5(家計の計画)で、報告書に「2026-07 の記録がない」「2026-07 が全カテゴリで欠落」と書いてあるのに、判定器は「7月のデータの欠損に触れていない」として落としていたのです。判定器は「7月」という書き方しか拾っていませんでした。
これはHaikuだけの話ではありません。全モデルの記録に同じ規則を当てると、9月に測ったQwen3.8 Flash Nextの1回(量子化違いも含めると3回)も、同じ理由で落ちていました。とはいえ、判定器を後から変えると、これまでの比較が崩れます。Claude Codeは、見出しの数字を判定器どおりのままにして、上の図では◇で区別しました。
中身の採点:モデル名を伏せて採り直した
合格・不合格とは別に、成果物の中身を0〜5点で採点するルーブリックがあります。これまでClaudeが採点してきましたが、今回は困ったことに、採点するClaudeと、採点されるHaikuが同じAnthropicのモデルです。そこでClaude Codeは、LunaとHaikuの成果物162本を乱数のIDに置き換え、順番を混ぜてから、タスクごとに別々のClaude(6体)に採点させました。どの答えがどのモデルのものかは、採点したClaudeには見えていません。
| ルーブリック平均(0〜5) | 既定 | high | xhigh |
|---|---|---|---|
| Codex × GPT-6 Luna | 3.93 | 3.81 | 3.78 |
| Codex × Haiku 5.5 | 4.46 | 4.58 | 4.56 |
| Claude Code × Haiku 5.5 | 4.58 | 4.56 | 4.76 |
名前を伏せても、中身の点はHaikuが0.5〜1.0点上でした。差が大きいのはD5(計画の立て方)とD3(ガイドラインの作法)、次いでD1(選んだ理由の書き方)です。
ただし、伏せたところで採点するのはClaudeです。文体から自分の系統の答えを好む偏りは、IDを伏せても消せません。さらに、家計のタスクの答えには実行日が書いてあって(Lunaは9月23日、Haikuは10月9〜10日)、2つのグループがあることまでは採点者から見えていました。なので、ルーブリックの点は参考にとどめます。
採点者に依存しない、判定器が機械的に数えた数字も並べておきます。
| 判定器の数字(既定・high・xhighの9回の平均) | GPT-6 Luna | Haiku 5.5(Codex) |
|---|---|---|
| D1 ニュースの順位の付け方(正解との順位相関) | 0.98 | 0.98 |
| D4 仕込んだ誤り20件のうち見つけた割合 | 0.91 | 0.84 |
| D4 指摘のうち正しかった割合 | 0.83 | 0.88 |
| D4 「指摘しなくてよい」箇所への指摘 | 1〜2件 | 0件 |
| D5 計画の削減額(スクリプトで計算) | 11.2万円 | 14.3万円 |
ここは公平に書いておきます。誤りを見つける数では、Lunaのほうが上です。 Lunaは網羅的に拾う代わりに、指摘しなくてよい所まで指摘して減点される。Haikuは拾う数がやや少ない代わりに、余計な指摘を1件もしない。何でもHaikuが上、というわけではなく、性格が違います。私のブログの校正を頼むなら、余計な指摘で「(笑」を消されない分、Haikuのほうがありがたいのですが(笑
速さと費用:速さは同じ、費用は2倍。でもコスパはHaiku
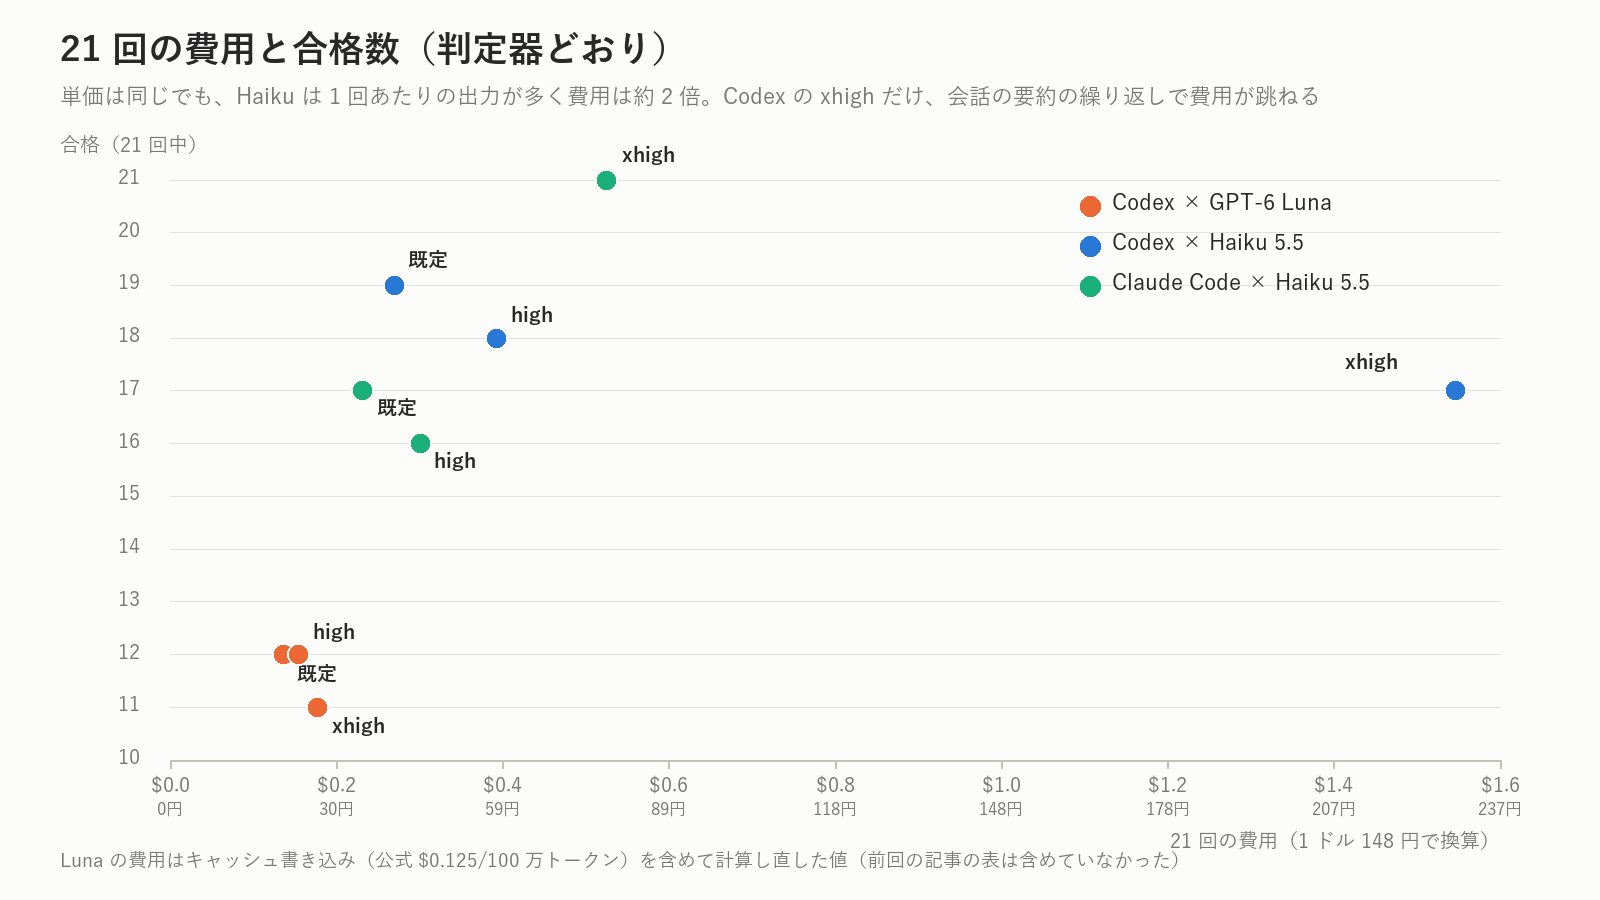
1タスクの中央値は、どちらもeffort既定で58秒。21回の合計も18.9分と19.5分で、ほぼ同じでした。
費用は、単価が同じなのにHaikuが2倍です(約20円と約40円)。理由は2つあります。
- Haikuは書く量が多い。 1回あたりの出力はLunaの5,000トークンに対してHaikuは11,800トークンで、2.4倍
- キャッシュへの書き込みが多い。 書き込みは入力の1.25倍の値段で、Haikuの書き込み代はLunaの1.8倍($0.107と$0.058)。そもそも入力のトークン数がLunaの1.6倍(1回あたり22.6万と13.7万)あります。道具を呼ぶ回数はほぼ同じ(7.8回と7.4回)なので、同じ文章を多めに数えるトークナイザ(Anthropicの説明では前の世代より約3割多い)と、長い出力が次の入力に載る分が効いている、というのがClaude Codeの見立てです
合格1本あたりで割ると、Lunaが約1.7円、Haikuが約2.1円。お金だけで見れば、Lunaのほうが安い。
それでも、私はHaikuのほうがコスパが高いと考えています。差は21回で20円です。それに対して、Lunaは21回中9回、Haikuは2回、判定器に落とされます。落ちた回は、人間が中身を確かめて直すことになる。私の時給を20円で見積もるのは、さすがに安すぎます(笑
「相性」の正体:Codexの会話の上限だった
Codex CLIで回していたとき、Haikuのhigh・xhighはLunaよりずっと時間がかかっていました。私はClaude Codeに、「Haiku 5.5はLunaよりかなり優秀なはずで、これだけ時間がかかるのはハーネスとの相性が悪い可能性が高いのでは」と聞きました。OpenAIのハーネスにAnthropicのモデルを載せているので、相性が悪くてもおかしくありません。
そこで、同じHaikuを、AnthropicのハーネスであるClaude Codeでも回してもらいました。VMにClaude Codeを入れ、同じ題材と同じプロンプトを、指示を足さずにそのまま渡しています(段取りは、手元のClaude Codeに任せました)。Codexでネット検索が使えなかったのに合わせて、ネット検索の道具は外してあります。
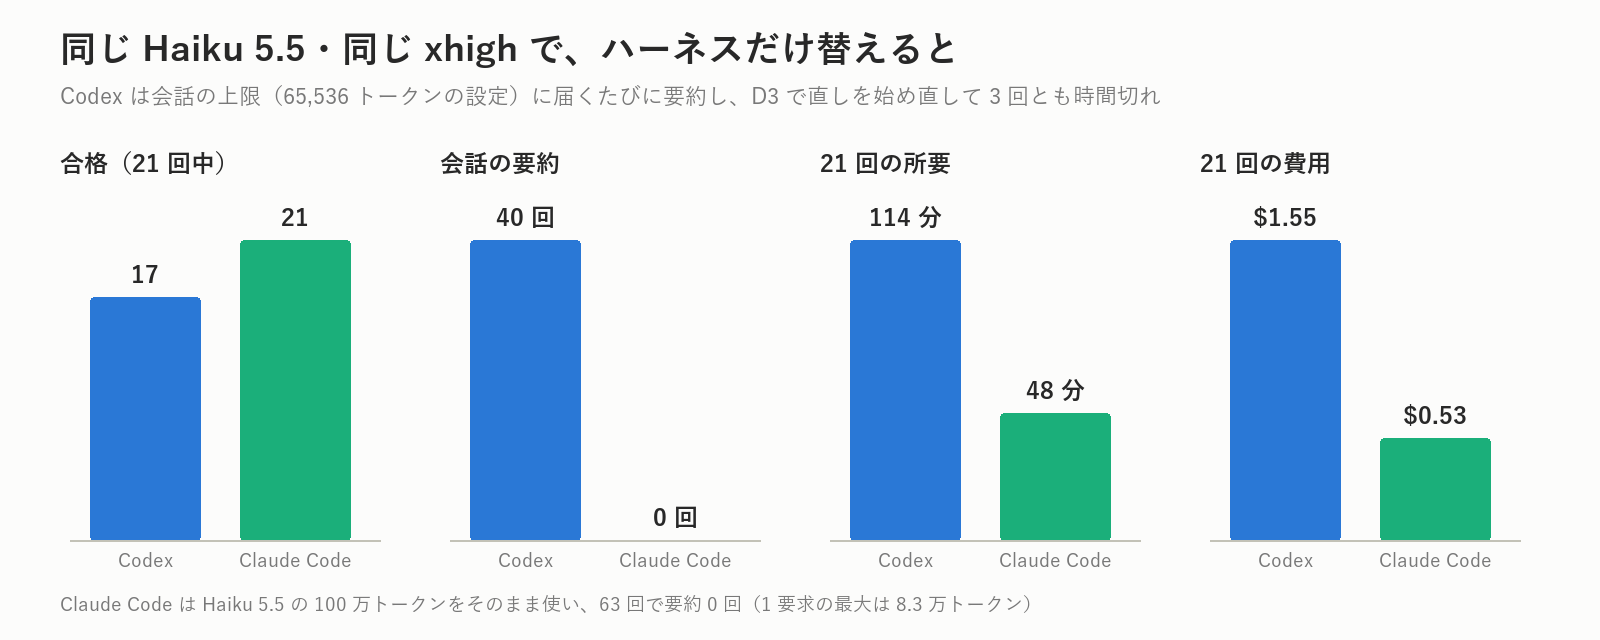
結果は、私の見立ての半分が当たり、半分が外れました。
- 既定とhighでは、差はほとんどない。 中央値はCodexが58秒・79秒、Claude Codeが56秒・83秒。合格数はCodexのほうが2本ずつ多いくらいでした(highでClaude Codeが落としたD5の3回は、すべて上の「2026-07」の判定器の見落とし)
- xhighで、はっきり差が出た。 Claude Codeは21/21、48分、78円。Codexは17/21、114分、229円
原因をClaude Codeが調べると、相性の正体は、Codex CLIの設定にある会話の上限(65,536トークン)でした。会話がこの長さに届くと、Codexは途中までのやり取りを要約して縮めます。HaikuはxhighにするとD3で資料の読み直しと直しを繰り返すので、すぐに上限に届く。要約されると細部を忘れ、資料を読み直して直しを始め直し、また上限に届く……を繰り返して、3回とも25分で打ち切られました。D3の1回あたり、平均で140回も道具を呼んでいます。
この上限は、以前ローカルモデルに合わせて入れた設定で、Lunaの回にも同じように効いていました。ところがLunaは、63回で一度も上限に届いていません。読み返しの少ないLunaと、読み返す(そして多めにトークンを数える)Haikuで、同じ設定の効き方が違った、ということです。Claude CodeはHaiku 5.5の100万トークンをそのまま使うので、63回で要約は0回でした。
なので「相性」は、「OpenAIのハーネスにAnthropicのモデルだから」ではなく、「長く考えるモデルに、短い上限」の組み合わせでした。上限を伸ばせば、Codexでもxhighは通るかもしれません(今回は試していません)。
ちなみに、Claude Codeのほうでも準備で2つつまずきました。安定版のClaude Code(2.1.286)は、まだHaiku 5.5を知らないモデルとして扱っていて、最新版(2.1.295)に上げる必要がありました。Haiku 5.5が出たのは、この測定の2日前なので、無理もありません。もう1つ、Claude CodeのBashのサンドボックスがこのVMでは起動しなかったので、手元のClaude Codeが外しました。その代わり、63回で245回呼ばれたBashのコマンドを全部調べて、ネットにつなぐコマンドが0回だったことをClaude Codeが確かめました。
ローカルの最良モデルと比べると
ここからが、私がいちばん書きたかったことです。
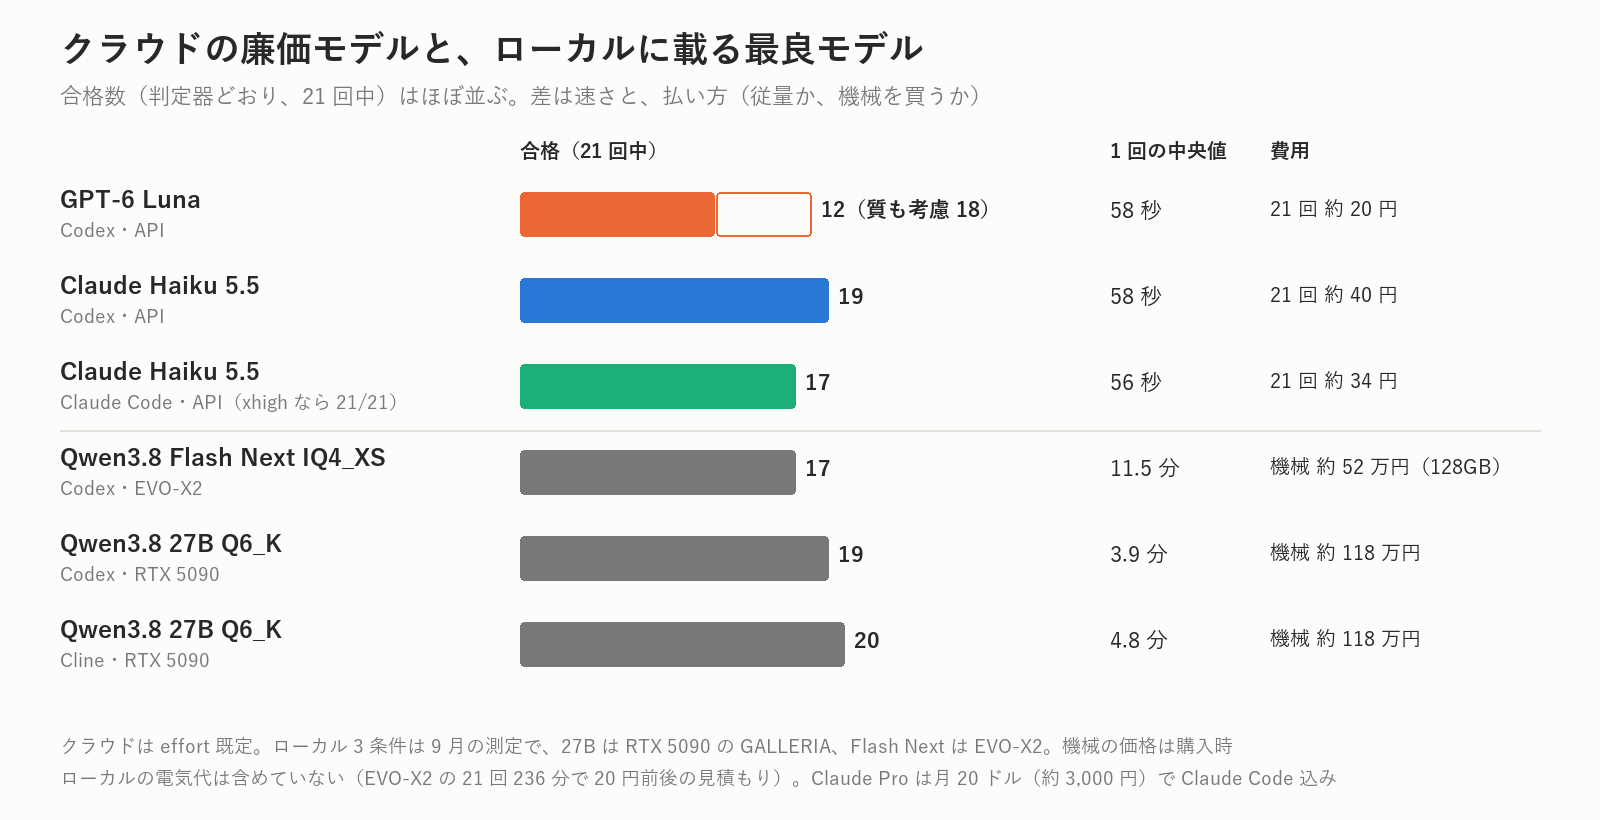
| 合格(判定器どおり) | 1タスクの中央値 | 払い方 | |
|---|---|---|---|
| Codex × Haiku 5.5 | 19/21 | 58秒 | API従量、21回 約40円 |
| Claude Code × Haiku 5.5 | 17/21(xhighで21/21) | 56秒 | API従量、21回 約34円 |
| Codex × GPT-6 Luna | 12/21(質も考慮18/21) | 58秒 | API従量、21回 約20円 |
| Codex × Qwen3.8 Flash Next IQ4_XS(EVO-X2) | 17/21 | 11.5分 | 機械 約52万円 |
| Codex × Qwen3.8 27B Q6_K(RTX 5090) | 19/21 | 3.9分 | 機械 約118万円 |
| Cline × Qwen3.8 27B Q6_K(RTX 5090) | 20/21 | 4.8分 | 機械 約118万円 |
ローカルの数字は、6モデル比較とハーネス比較の記事で、同じ題材・同じ判定器で測ったものです。128GBの統合メモリ機に載る最良のMoE(Qwen3.8 Flash Next)が17/21、RTX 5090に載る最良のDense(Qwen3.8 27B)が19〜20/21。Haiku 5.5は、そのどちらともほぼ並びます。 速さは、Flash Nextの12倍、27Bの4倍です。
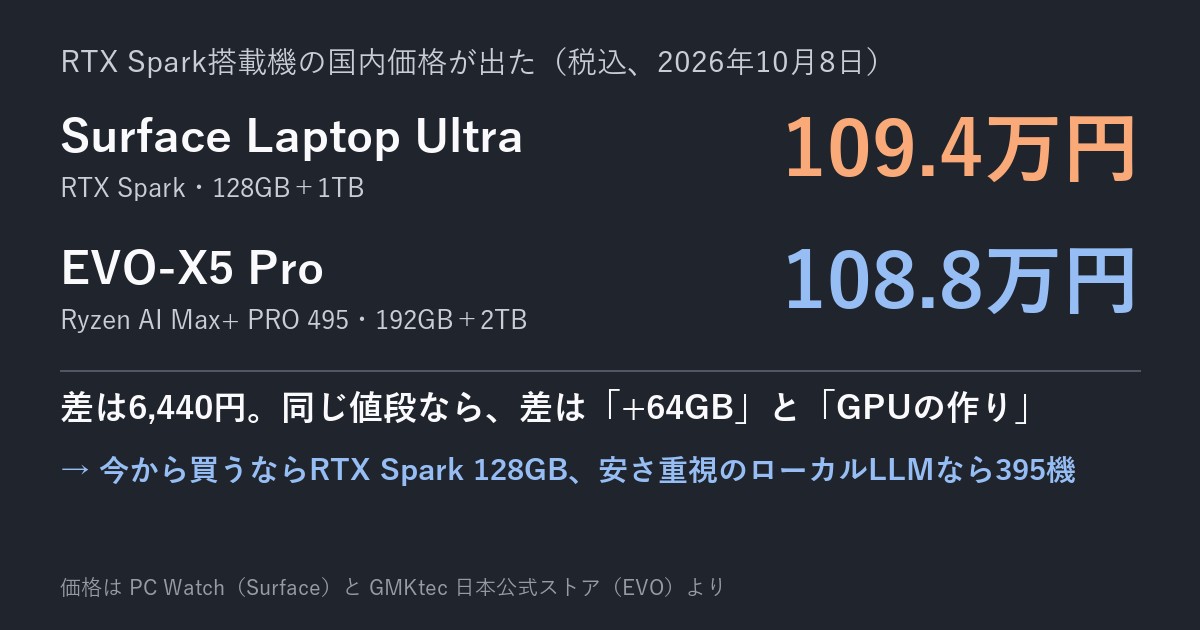
そして、機械の値段です。私の自宅AI環境は、EVO-X2が約52万円、RTX 5090のGALLERIAが約118万円でした。いま買うなら、RTX 5090はグラボだけで100万円コース、192GBのEVO-X5 Proは104万円、RTX Spark 128GBのノートは109万円。ローカルで「最良」を動かす機械は、おおむね50万〜120万円です。
一方、Claudeのいちばん安い有料プランのProは、月20ドル(年払いなら月17ドル)。1ドル148円で月3,000円ほどで、Claude Codeが付いてきて、モデルにHaikuを選べます。EVO-X2の52万円は、Proの約14年分。2台合わせた170万円なら、48年分です。五十路の私が、100歳近くまで払える計算です(笑
現実的には、Claude ProをHaiku 5.5中心で使うほうがコスパは高い。 今回の結果を見て、私はそう考えています。
ただし、注意が2つあります。今回の測定は、サブスクではなくAPIの従量課金でした。Proは5時間ごとの枠と週ごとの枠で使える量が決まっていて、その枠の中で今回のようなタスクを何本回せるかは測っていません。もっとも、APIで払っても今回の21回は40円なので、サブスクの枠を気にするほどの量ではありません。
もう1つ。それでもローカルには、ローカルにしかない良さがあります。
- データを外に出さない。 仕事の資料や個人の情報を、どこにも送らずに済む
- 検閲のないモデルを動かせる。 クラウドのモデルは安全のための判定で断ることがありますが、ローカルなら自分で選べる
- 何より、所有欲が満たされる。 机の上で唸るRTX 5090を眺めながら飲むコーヒーは格別です(笑
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 「Luna 6とHaiku 5.5を同じハーネス、同じデータで比べたい」と依頼、VMの起動 | 前回のLunaの記録の場所探し、両社の公式の価格の確認 |
| AnthropicのAPIキーの用意と、VMへの配置(キーはClaude Codeに見せない形で) | Codexの通信をAnthropicの形式に訳す中継を書き、偽のキーで配線を確かめた |
| 「時間がかかるのはハーネスとの相性では」と見立て、Claude Codeでも回すよう提案 | Codexの既定の変化(update_plan)を見つけ、Lunaのときと同じ指示文に戻した |
| 「コストは問題ない」と判断、寝ている間の無人運転を頼んだ | 126回の実行・回収・判定、落ちた回の読み込みと判定器の見落としの洗い出し |
| 記事に入れたい論調(廉価版どうしの比較、ローカル機との費用の比較)を決めた | モデル名を伏せたルーブリック採点(6体)、費用の集計、REPORT、この記事の下書きと図 |
正直、気になっていること
- 中継は自作です。 CodexとHaikuの間には、Claude Codeが書いた通訳が入っています。エラーは0回でしたが、訳し方がHaikuの成績に影響した可能性はゼロではありません。Lunaは中継なしで、Codexの純正の接続です
- 採点者はClaudeです。 モデル名は伏せましたが、上に書いたとおり偏りは消せません。Claude以外のモデルに採点させることも考えましたが、ちゃんと採点できそうなのはGPT-6 Astraぐらい。そのためにChatGPTを契約したり、単価の高いAstraのAPIに課金したりするのは気が進みませんし、そこまでやっても結果が大きく変わる可能性は低いと私は見ています。偏りがあるかもしれないことは正直に認めたうえで、採り直しはここまでにします。ルーブリックは参考にとどめ、見出しには判定器の合格数を使いました。私は採点の中身を確かめていません
- 判定器もClaudeが作ったものです。 題材を作ったのもClaudeです。このシリーズを通して同じ構造です
- 測定は、Haikuが発表の2日後、Lunaが発表の翌日です。 どちらも出たばかりで、この後の更新で変わるかもしれません
- n=3です。 1本の差は揺らぎの範囲です。Codexの既定とClaude Codeの既定の2本差(19と17)も、揺らぎで説明できる大きさです
- Codexの会話の上限(65,536トークン)は、ローカルに合わせたままです。 伸ばせばCodex×Haikuのxhighは良くなるはずですが、試していません
- サブスクの枠は測っていません。 Proの枠でどれだけ回せるかは、使い方次第です
まとめ
- OpenAIとAnthropicの廉価版、GPT-6 LunaとClaude Haiku 5.5は、単価がまったく同じ(入力$0.10・出力$0.50)
- 同じCodex CLIで、合格はHaiku 19/21、Luna 12/21。Haikuは指示の細部を守り、Lunaは網羅的に拾うが細部を落とす
- 速さは同じ(中央値58秒)、費用はHaikuが2倍(21回で約40円と約20円)。それでも、落ちる回の少なさを考えればHaikuのほうがコスパは高い
- 「ハーネスとの相性」の正体は、Codexの会話の上限。Claude Codeで回すと、xhighで21/21の満点
- ローカルの最良モデル(Qwen3.8 Flash Next 17/21、27B 19〜20/21)とほぼ並ぶ。50万〜120万円の機械より、月3,000円のClaude Pro+Haiku 5.5のほうが現実的。ただし、データを出さない・検閲がない・所有欲、はローカルだけのもの
廉価版どうしの勝負は、Haikuの圧勝でした。とはいえ、RTX 5090を手放すつもりはありません。オヤジの所有欲に、コスパは関係ないのです(断言
コメント