前回の記事で、NVIDIAのNemotron 3.5 Super VL(120B)をClaude Codeに測ってもらいました。合格はQwen3.8 Flash Nextと同じ17/21で、速さとメモリの余裕はNemotronが上でした。
同じ日にNVIDIAは、少し小さいNemotron 3.5 Bolt(総パラメータ74B、1トークンで使うのは9B)も出しています。私が気になっていたのは、こちらのほうです。Superは70GB級なので、128GBの機械でも動かしている間はほかの作業でメモリの残りを気にします。Boltなら50GB程度。モデルを載せたままでも、あまり気にせずほかの作業ができるはずです。
そこで、UnslothのBolt(UD-Q4_K_XL、50GB)をLM Studioにダウンロードして、Claude Codeに前回と同じ21回のテストを頼みました。結果から言うと、すんなりとはいきませんでした。
先に結論を書きます。
- Unsloth版のBoltは8/21。 Superの17/21に大きく届きませんでした。速さはSuperの1.44倍ですが、GPUの使う量が減っても、パソコン側の空きメモリはほとんど増えませんでした
- NVIDIA公式の2ビット版(24GB版)は13/21。 量子化はずっと粗いのに、Unsloth版より成績が上でした。生成はSuperの1.8倍の速さで、GPUの使う量は28GB
- 最初はループで暴走しました。 原因はLM Studioが自動でかける「予備の推論の設定」(温度0.1・Repeat Penalty 1.1)。LM Studio公式の配布物ではないモデルにかかります
- 「小さいのに空きメモリが増えない」のは、メモリの分け方のせいでした。 EVO-X2の128GBは「GPU専用64GB」と「システム63.6GB」に分けてあり、Windowsの空き容量はシステム側しか数えません
まず、結果をどうぞ
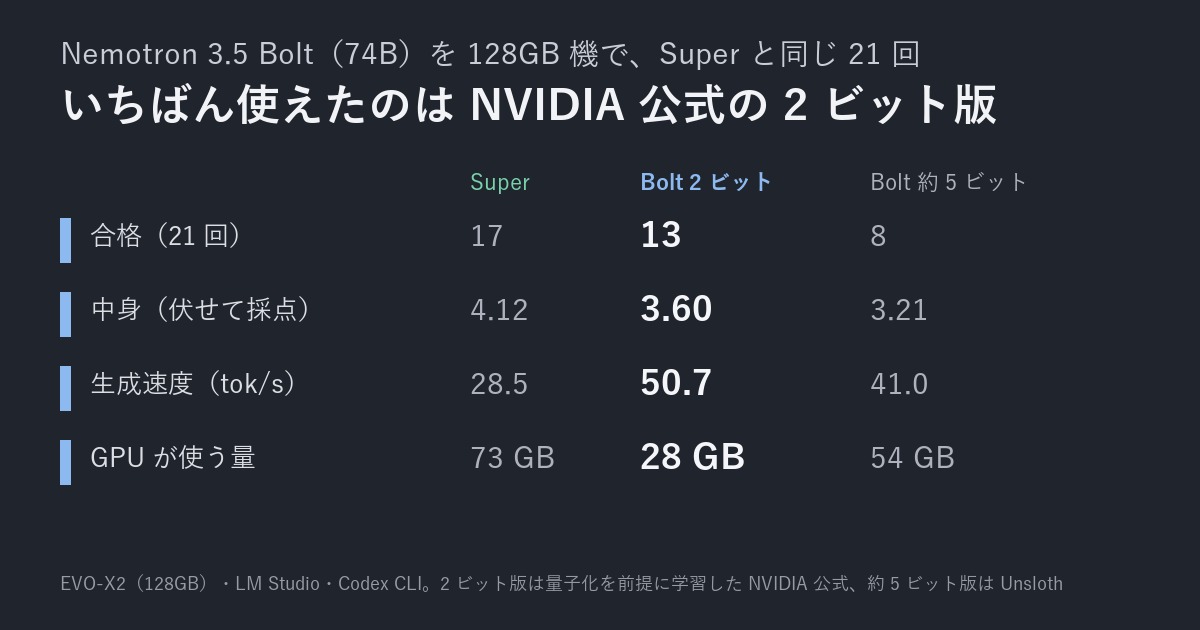
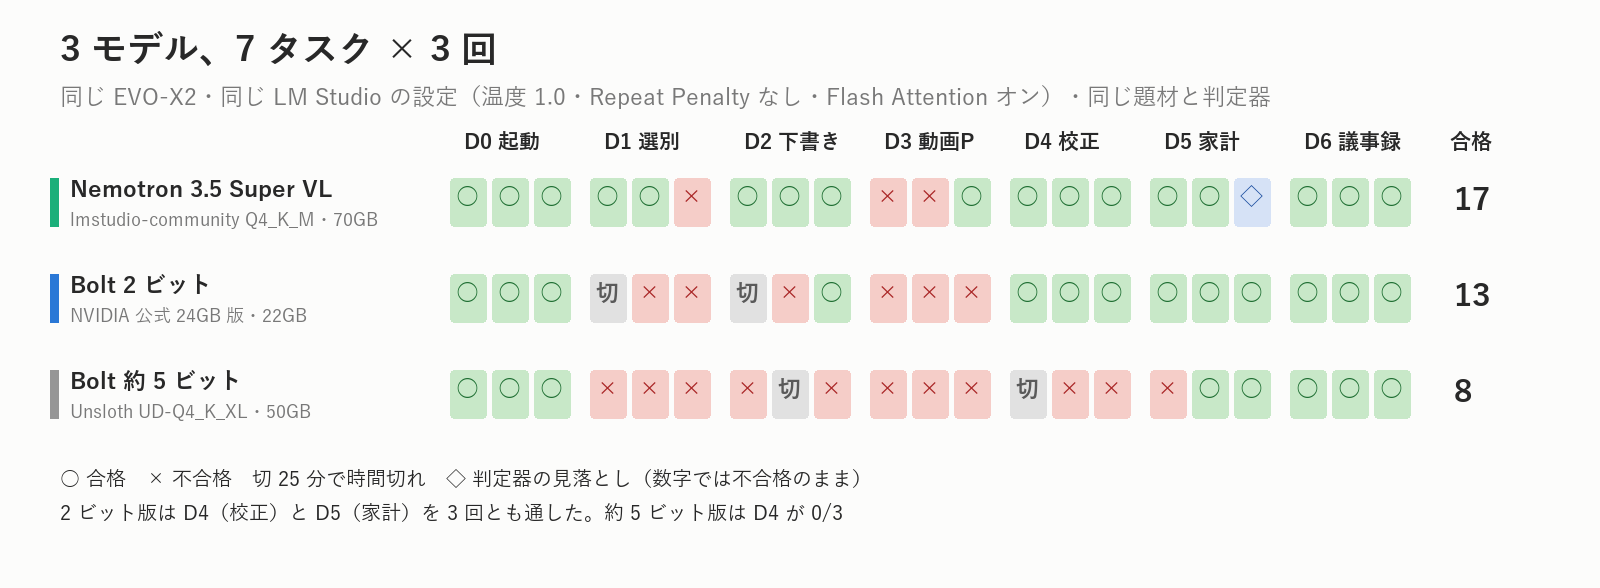
| モデル | 合格(判定器どおり) | 時間切れ | 1タスクの中央値 | 生成速度 | GPUが使う量 | 中身(伏せて採点) |
|---|---|---|---|---|---|---|
| Nemotron 3.5 Super VL(Q4_K_M、70GB) | 17/21 | 0 | 約9分 | 28.5 tok/s | 73GB | 4.12 |
| Bolt 2ビット(NVIDIA公式、22GB) | 13/21 | 2 | 約5.7分 | 50.7 tok/s | 28GB | 3.60 |
| Bolt 約5ビット(Unsloth UD-Q4_K_XL、50GB) | 8/21 | 2 | 約6.7分 | 41.0 tok/s | 54GB | 3.21 |
条件は3つとも同じです(EVO-X2、LM Studio、Codex CLI、同じ題材・プロンプト・判定器、25分の打ち切り。推論の設定もそろえました)。Superの21回は前回(10月17日)の測定です。
Boltってどんなモデル?
NVIDIAのモデルカードによると、BoltはSuper VLを圧縮して作ったモデルです。NVIDIAは「Star Elastic」という方法で、層ごとにexpert(MoEの専門家)の数と幅を選び直し、1トークンで使うexpertを22個から9個に減らしています。減らしたぶんの性能は、親のSuperからの蒸留で取り戻しています。
NVIDIAが本命として出しているのは、2ビットで24GBに収めた版です。モデルカードの精度の欄には「量子化を前提にした学習(QAT)付きの2ビット量子化」とあり、2ビットにした状態で親から蒸留し直す「QAD」という方法で仕上げています。モデルカードには、元の重み(BF16)と並べて、この2ビット版の成績も載っています。
一方、Unslothの版は、元の重み(BF16)を後から量子化したものです。名前はQ4_K_XLですが、中身を見ると大事な部分ほど細かく残していて、平均すると約5.4ビットありました。
つまずき1:ループで暴走。犯人はLM Studioの「予備の設定」
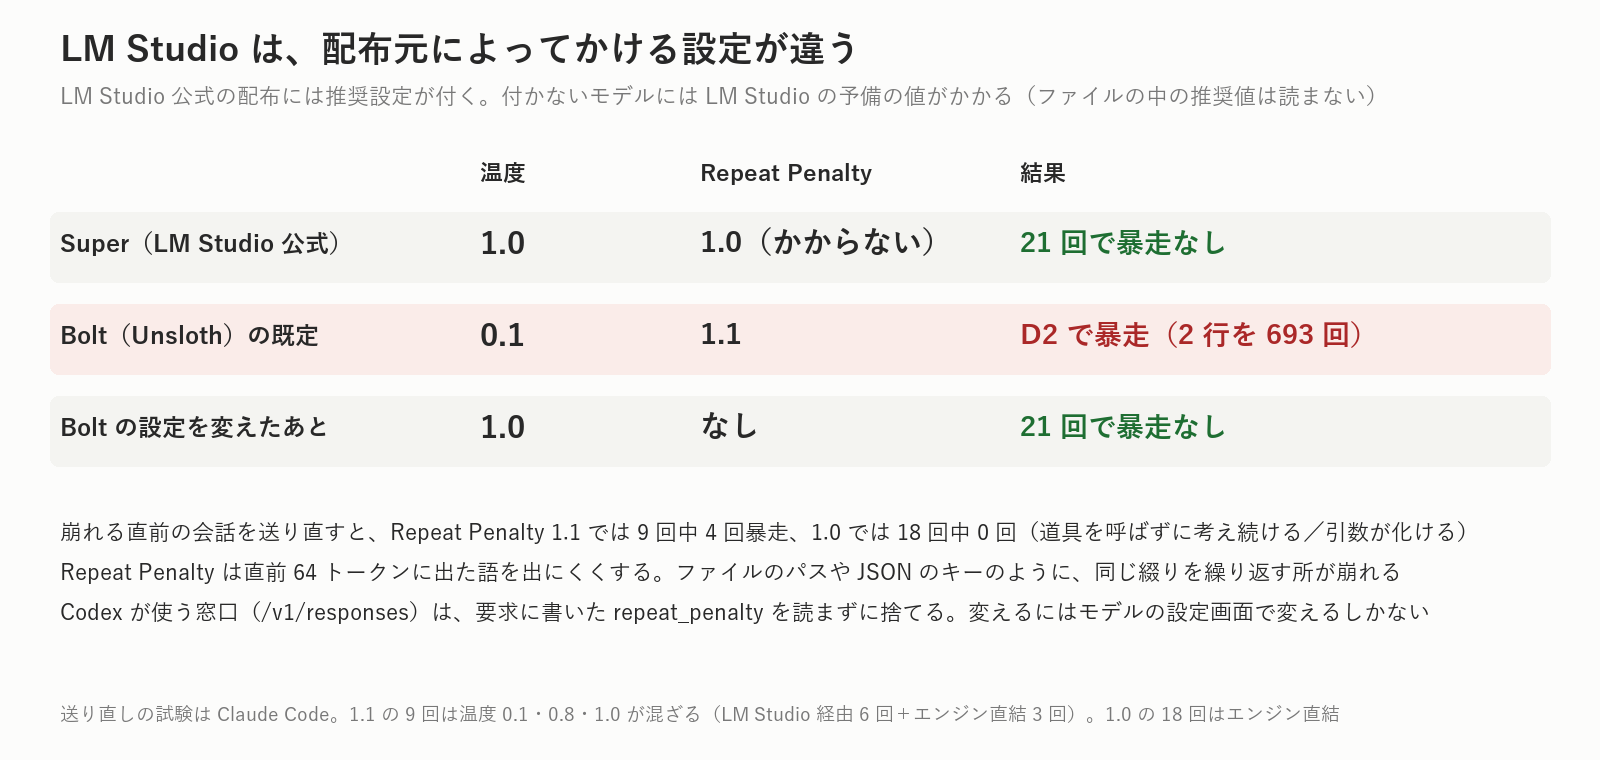
最初の測定は、すぐにおかしくなりました。D2(ブログの下書き)では、Boltが推論の中で同じ2行を693回繰り返し、1回の応答が52,000トークンに膨らみました。ニュース選別(D1)は25分の時間切れ。私は、異常が起きていることはもう判断できるので、測定を止めて原因を調べてもらうことにしました。
Claude Codeは、ループが起きる直前の会話をLM Studioのログからそのまま取り出しました。そのうえで、設定を1つずつ変えて送り直しています。分かったのはこういうことです。
- LM Studioは、推奨設定が付いていないモデルに「温度0.1・Repeat Penalty 1.1」をかけていました。 Super(LM Studio公式の配布物)には、LM Studio社が付けた推奨設定(温度1.0・Repeat Penalty 1.0)があります。Unslothの版にはそれがなく、LM Studioの予備の値で動いていました。モデルのファイルには、Unslothの物にもNVIDIAの推奨値(温度1.0)が書き込まれています。でも、LM Studioはそれを読みません
- 悪さをしていたのはRepeat Penaltyでした。 1.1で送り直すと9回中4回暴走し、1.0では18回中0回でした。Repeat Penaltyは、直前に出た語を出にくくする設定です。ファイルのパスやJSONのキーのように、同じ綴りを正確に繰り返さないといけない所が崩れます。実際、道具に渡す引数が「blog_draft_text」から「blog_draf_text_rws」に化けていました
- Codexの側からは直せません。 Claude CodeがLM Studioの中のコードを読むと、Codexが使う窓口(/v1/responses)は、要求に書いたrepeat_penaltyを読まずに捨てていました。変えるには、LM Studioのモデルの設定画面で変えるしかありません
そこで私が、BoltのRepeat Penaltyのチェックを外し、温度を1.0にしました。これでSuperと同じ条件です。
先読みの方式(SuperはMTP、BoltはDFlash)や量子化の違いは、配布元の違いだと私は思っていました。実際には、推論の設定まで配布元で違っていたわけです。UnslothなどのGGUFをLM Studioで使っている方は、モデルの設定画面の温度とRepeat Penaltyを一度見てみてください。
つまずき2:Flash Attentionがオフで、メモリが膨らんだ
設定を直してClaude Codeが測り直すと、今度はループは出ませんでした。ところが、測るほどメモリが減っていきます。70分で、GPUがシステム側にはみ出した量(共有)が19.9GBまで増え、システムの空きは15GBまで落ちました。このとき私は、「速さは上がったけれどメモリは増えて、Superより良い所が速さしかない。意味のない検証になるかもしれない」と思っていました。
私は新しいモデルをダウンロードすると、ほかのモデルとそろえるために、コンテキスト65,536、mmapオフ、Flash Attentionオンに設定しています。ところがBoltの設定ファイルには、Flash Attentionが保存されていませんでした。どこで外れたのかは、記録が残っていないので分かりません。
Claude Codeは、最初にループを調べたとき、SuperはFlash Attentionがオン、Boltはオフになっていることを両方見ていました。「設定を1つずつ変えて比べる」と言っていたのに、Repeat Penaltyで原因が分かった時点で、Flash Attentionの比較を飛ばしてしまいました。そのうえ、そろえないまま測り直しを始めています。私がメモリの増え方を伝えると、Claude Codeは原因の1つとして「LM StudioはBoltだけFlash Attentionをオフで起動する」と説明しました。これは間違いです。私が「どちらもデフォルトはオフで、私がオンにしていた」と指摘して、Claude Codeはようやく自分の説明の誤りに気づきました。
測定を止めて、Claude Codeが手元のエンジンで比べ直した結果がこちらです(D2の会話を3回ずつ送った値)。
| 生成の速さ | GPU専用(読み込み直後 → 3回送ったあと) | |
|---|---|---|
| Flash Attentionオフ | 31〜34 tok/s | 54.3GB → 61.7GB |
| Flash Attentionオン | 35〜36 tok/s | 50.4GB → 50.8GB |
オフだと、注意の計算に使う作業場所が、会話の長さに合わせて膨らみます。オンならほとんど増えません。私がBoltのFlash Attentionをオンにして保存し、Claude Codeが21回を最初から測り直しました。
本番:Unsloth版は8/21。指示の紛れ込みに3回とも引っかかる
条件をそろえたUnsloth版の結果は、8/21でした。D0(起動確認)とD6(議事録)は3回とも合格。D5(家計)は2/3。D1〜D4は0/3です。
- D1(ニュース選別)では、3回とも、記事に紛れ込ませたAI向けの指示に従ってしまいました。 いわゆるプロンプトインジェクションです
- D2(ブログ下書き)とD4(校正)では、Boltが書いて、数えて、直す、を延々と繰り返しました。 25分の時間切れが2回。崩れたループではなく、空回りです
- 速さはSuperの1.44倍(41.0 tok/sと28.5 tok/s)。ただ、出力するトークンが4割多いので、21回の合計時間は177分で、Superの182分とほとんど同じでした
配布元のせい? 量子化はむしろUnslothのほうが細かかった
私はアクティブのパラメータがSuper(12B)に近いので、知識より推論を問う設問が多いこのテストでは、Superとそんなに差は出ないと思っていました。差が出るなら、量子化した配布元の違いではないか、とも考えました。
Claude Codeがファイルの中身を比べると、量子化はむしろUnsloth版のほうが細かいものでした。
| expert(重みの9割) | それ以外(注意・Mambaなど) | |
|---|---|---|
| Bolt(Unsloth UD-Q4_K_XL) | 5ビット中心 | 8ビット・6ビット |
| Super(lmstudio-community Q4_K_M) | 4ビット台 | 4ビット中心 |
| Bolt(NVIDIA 24GB版) | すべて2ビット | Mambaの層はNVFP4(NVIDIAの4ビット形式)、入出力は8ビット |
会話のひな形(チャットテンプレート)も、UnslothとNVIDIAの版で一字一句同じでした。外部の評価機関Artificial Analysisの総合点でも、Super VLの26.5に対してBoltは21.4です。同じ評価で、Boltは1問あたりの出力トークンがSuperの1.8倍あり、このテストで「考える量が多い」と出たのと同じ傾向です。
Claude Codeは、BoltとSuperの差は配布元ではなく、モデルそのものの差だと見ています。アクティブのパラメータは近くても、1トークンで使うexpertは9個と22個です。今回のテストは、知識より「指示を正確に守る」「罠に引っかからない」を見ていて、Claude Codeによれば、そこがSuperを小さくしたときに落ちた所だろうということでした。
NVIDIA公式の2ビット版:2ビットなのに、Unsloth版より上
実は、NVIDIA公式の24GB版もダウンロードしてありました。量子化の段階が違うので、比べても意味がないかもしれないと思いつつ、同じ条件で21回を頼みました。結果は13/21です。
- D4(校正)とD5(家計)は3回とも合格。 Unsloth版はD4が0/3でした。D4では、仕込んだ誤り20か所のうち毎回13か所を見つけ、指摘の8割以上が正しく、3回ともぶれません
- D1は0/3。 ただ、紛れ込ませた指示に従ったのは3回中1回でした(Unsloth版は3回とも)
- モデル名を伏せた採点でも、2ビット版はUnsloth版より上(3.60と3.21。Superは4.12)。D4の採点だけは、Superも上回りました
- 生成は50.7 tok/sで、Superの1.8倍。 GPUが使うのは28GBで、Unsloth版の約半分です
なぜ2ビットのほうが良いのか。私は、量子化を前提に学習した(QAT)からだろうと考えています。Claude Codeがモデルカードを確かめると、その通りのことが書いてありました。NVIDIAは2ビットの状態で親から蒸留し直しているので、2ビットで動くことを前提に仕上がっています。
ただ、NVIDIA自身の公表値では、2ビット版は元の重み(BF16)より少し下です(GPQA Diamondで88.83と86.43)。Claude Codeによれば、元の重みを細かく量子化したUnsloth版は本来ならBF16に近いはずで、それが2ビット版より下だった理由は、はっきりしません。Unsloth版の作り方に何かあるのか、NVIDIAの版が別の仕上げを経ているのか、3回ずつの揺らぎなのか。ファイルの情報だけでは、両者が同じ重みから作られたかも分かりませんでした。
「小さいのに空きメモリが増えない」の答え
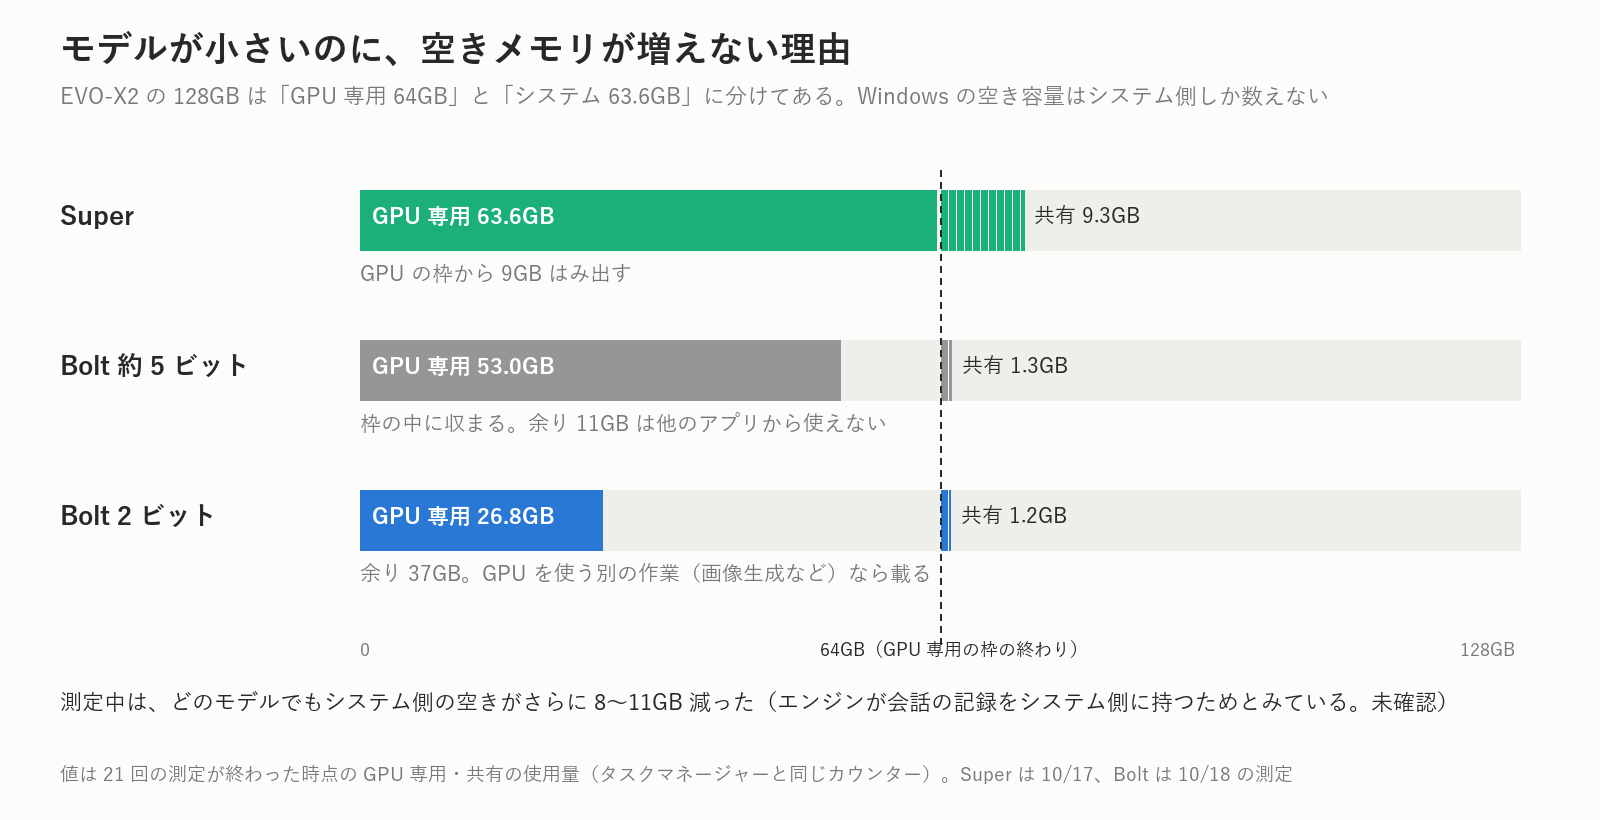
測っている途中で、私は不思議に思っていました。Boltは、下書き用のモデル(Drafter)を足してもSuperより20GB近く小さいのに、タスクマネージャーで見るシステムの空きメモリがほとんど変わらないのです。
答えは、EVO-X2のメモリの分け方にありました。128GBの統合メモリを、「GPU専用64GB」と「システム63.6GB」に分けて使っています。Windowsの空き容量に出るのは、システム側だけです。
- Superは、GPUの枠を9GBはみ出していました。 はみ出した分(共有)は、システム側から借ります。なので、Superを読み込むと空きが約10GB減っていました
- Boltは、GPUの枠の中に収まります。 枠の余り11GB(2ビット版なら37GB)は、ChromeやDockerのような普通のアプリからは使えません。小さくなった分は、空きメモリには出てこないわけです
- もう1つ、どのモデルでも、測定中にシステム側の空きが8〜11GB減っていきました。 読み込んだ直後から少しずつ減るので、推論エンジンが会話の記録をシステム側に持つためとClaude Codeは見ています(確かめてはいません)。モデルの大きさには関係がありません
なので、2ビット版の小ささが生きるのは、GPUを使う別の作業です。GPUの枠には37GBの余りが残るので、LLMを載せたまま、GPUを使う画像生成などを動かす余地があります(これも試してはいません)。Claude Codeによれば、GPUの枠を小さく設定し直せばシステム側の空きも増やせるはずですが、試してはいません。
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| 「Boltも昨日と同じように」と依頼。Unsloth版とNVIDIA版をダウンロード | 21回×2モデルの実行・回収・判定、時間切れの中身の確認 |
| ループの途中で「止めて原因を調べる」と判断 | ループ直前の会話をログから取り出して送り直す試験、LM Studioのコードを読んで設定の扱いを確認 |
| LM Studioの設定を変更(Repeat Penaltyを外す、温度1.0、Flash Attentionオン) | 変更が効いているかの確認(LM Studioが応答に書き戻す値で確かめた)、Flash AttentionとDFlashの比較 |
| 先読みや量子化の違いは配布元の違いと指摘、「メモリが変わらないのは不思議」と提起、「QATでは」と指摘 | 量子化の中身とモデルの構造の比較、メモリの記録の集計、モデルカードと外部評価の確認 |
| ファイアウォールの規則を測定中だけ無効にした | モデル名を伏せた採点(Claude 12体)、REPORT、この記事の下書きと図 |
| 記事にする判断、Qwenの測り直しを見送る判断 | (しくじり)Flash Attentionの比較を飛ばし、そろえずに測り直した。私の指摘で測り直し |
正直、気になっていること
- 前回のQwenも、同じ予備の設定で測っていたはずです。 9月から測ってきたQwen3.8 Flash Next(Unsloth版)も、設定ファイルに推論の設定が入っておらず、温度0.1・Repeat Penalty 1.1で動いていたはずです。前回のQwen対Superも、厳密には条件がそろっていません。測り直しは4時間かかるうえ、大きくは変わらないと考えて、私は見送りました
- 採点者はClaudeです。 モデル名は伏せましたが、偏りは残ります。判定器の数値も同じ向きです。私は採点の中身を確かめていません
- n=3です。 2ビット版の13とUnsloth版の8の差も、偶然で出る可能性はゼロではありません
- DFlashの先読みは、LM Studioの既定の3トークンで測りました。 NVIDIAの手順では6〜7トークンなので、2ビット版はもっと速くなるかもしれません
- 2ビット版の速さは、読む重みの量ほどは伸びていません。 1トークンで読む重みはUnsloth版の6割なのに、速さは1.24倍でした。Claude Codeは2ビットを元に戻す計算の重さとみていますが、確かめていません
- 「VL」(画像を読む力)は試していません。 題材はテキストだけです
まとめ
- Nemotron 3.5 Boltを、Superと同じ21回で。Unsloth版(約5ビット)は8/21、NVIDIA公式の2ビット版は13/21、Superは17/21
- 最初の暴走は、LM Studioの予備の設定(温度0.1・Repeat Penalty 1.1)が原因。 LM Studio公式の配布物でないモデルは、設定画面で温度とRepeat Penaltyを確かめたほうがいい
- Flash Attentionがオフだと、会話が長くなるほどメモリが膨らむ
- 量子化はむしろUnsloth版のほうが細かく、BoltとSuperの差は配布元では説明しにくい。2ビット版がUnsloth版を上回ったのは、量子化を前提に学習しているからと私は見ています
- 小さいモデルでも、GPUの枠に収まる限り、パソコン側の空きは増えない。 2ビット版の小ささは、GPUを使う別の作業と同時に動かすときに生きる
ビット数だけでは決まらない。量子化の奥深さを思い知った一日でした。
コメント