748B(7,480億パラメータ)。少し前なら、データセンターのGPUを何枚も並べないと動かなかった大きさです。そのDeepSeek V4.1 Flash 1017(以下、DeepSeek V4.1 Flash)が、わが家のGALLERIA(RTX 5090の32GB+メモリ128GB)で動きました。
使ったのは、Project Mayaという推論エンジンです。FreeTokenとStrataを比べた記事で、GPUに載り切らないMoEの専門家(expert)をメモリやSSDに逃がす仕組みを紹介しました。MayaはそのStrataのエンジンを元に作られていて、似た仕組みのエンジンは、ここ1〜2か月でどんどん増えています。遅いながらも、この大きさのモデルを個人のPCで試せるようになったわけです。ローカルLLMに関心を持っている者として、これは素直にうれしい。
では、エージェントとして使えるのか。Qwen3.8 Flash NextやNemotronを測ってきたのと同じ、Codex CLIの日常タスク21回のテストをClaude Codeに頼みました。
先に結論を書きます。
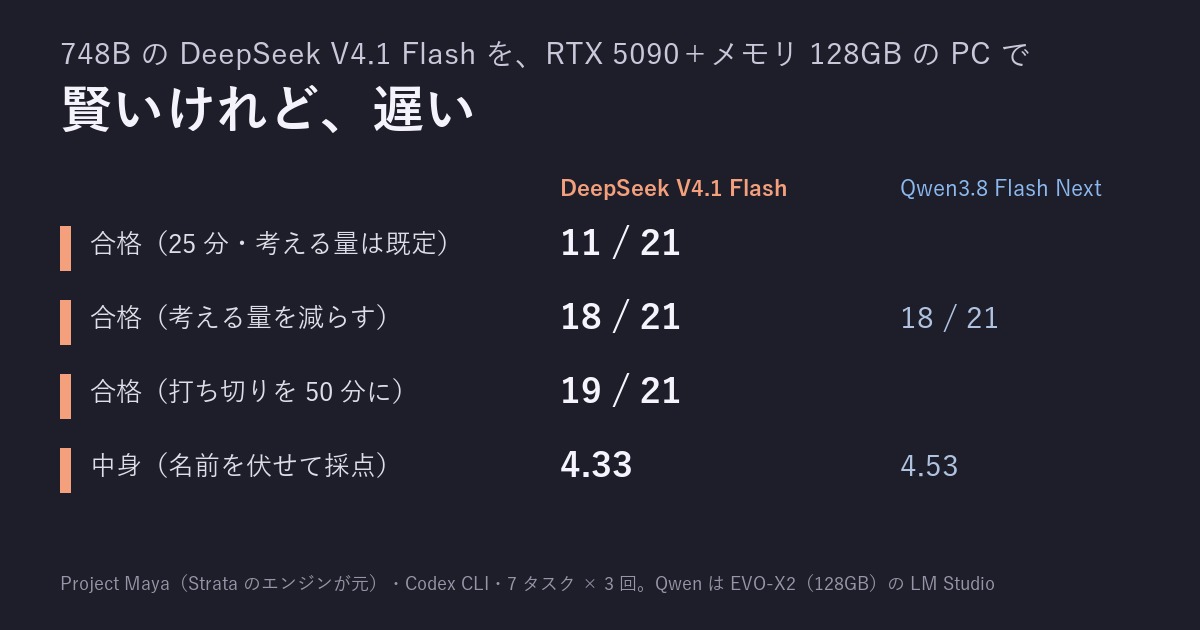
- 決まりどおりの25分では、合格は21回中11回。 21回のうち9回が時間切れでした
- 考える量を減らす(low)と18回。 Qwen3.8 Flash Nextと同点です。打ち切りを50分にすれば19回まで上がりました
- 中身は良い。 モデル名を伏せた採点では4.33点で、クラウドのClaude Haiku 5.5(4.31)と並びます。Qwen(4.53)には少し届きません
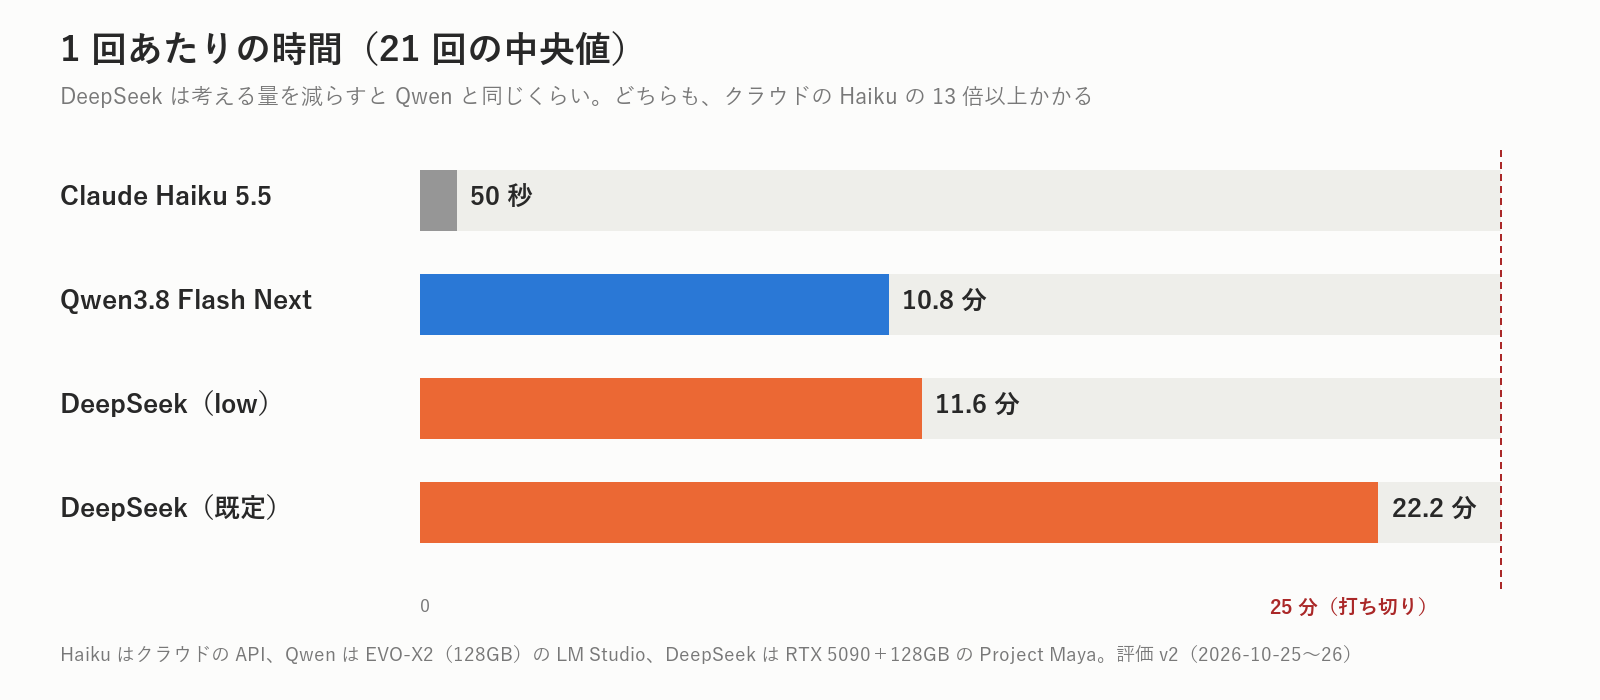
- ただ、遅い。 1回の中央値は、考える量を減らしても11.6分、既定のままだと22.2分。Haikuは50秒です
- 評価の決まりを1つ変えました。 Codexは、OpenAI以外のモデルには編集の道具(apply_patch)を渡しません。これまでは、道具がなければ別の方法で対応するところまで含めて評価していました。ただ、Mayaのような遅いモデルでは、やり直しのせいで時間切れが続きます。そこでこの要因をなくし、前に測ったモデルも測り直しました。HaikuとQwenの点は変わらず、DeepSeek(low)は15回から18回に上がりました
まず、結果をどうぞ
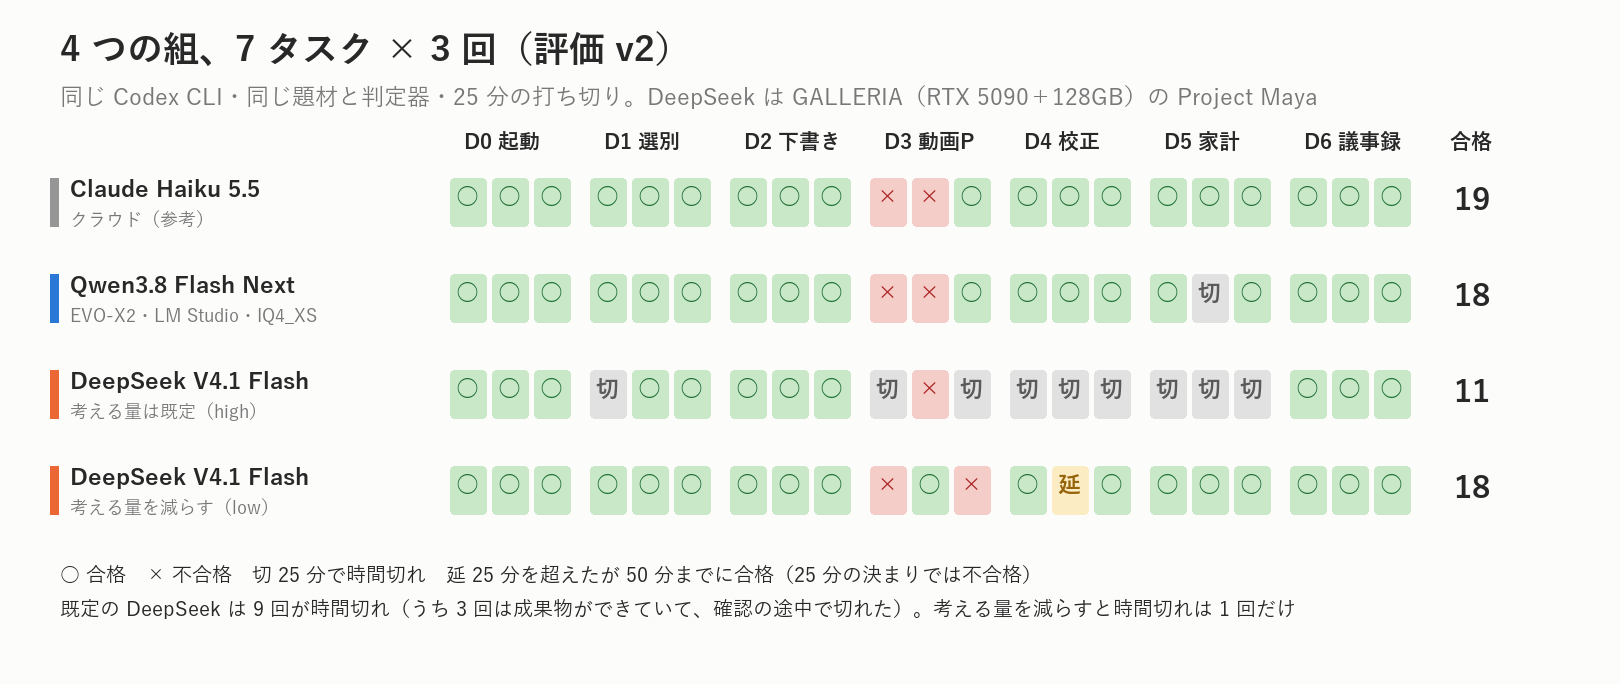
| モデル | 動かした機械 | 合格(25分) | 合格(50分) | 25分を超えた回 | 1回の中央値 | 中身(伏せて採点) |
|---|---|---|---|---|---|---|
| Claude Haiku 5.5(参考) | クラウド | 19/21 | — | 0 | 50秒 | 4.31 |
| Qwen3.8 Flash Next(IQ4_XS) | EVO-X2(128GB)・LM Studio | 18/21 | — | 1 | 10.8分 | 4.53 |
| DeepSeek V4.1 Flash(既定=high) | GALLERIA・Project Maya | 11/21 | — | 9 | 22.2分 | 3.32(時間内の回だけなら4.33) |
| DeepSeek V4.1 Flash(low) | GALLERIA・Project Maya | 18/21 | 19/21 | 1 | 11.6分 | 4.33 |
題材・プロンプト・判定器・Codex CLIは、これまでの記事と同じです。測定はどれも10月25〜26日で、後で書く「評価v2」の決まりです。
Project Mayaってなに?
Project Mayaは、GitHubで公開されている推論エンジンです(mw00/project-maya、MITライセンス、作者はPeasant Smithさん)。READMEには、MayaのエンジンはStrataのエンジンから始まり、GLM-5.3-Flash向けに書き直したとあります。いまはGLM-5.3-Flash(321B)とDeepSeek-V4.1-Flash-1017(748B)を、GPU 1枚から動かせます。よく似た名前と説明のリポジトリが別にもあるので、入れるなら公式のほうから。
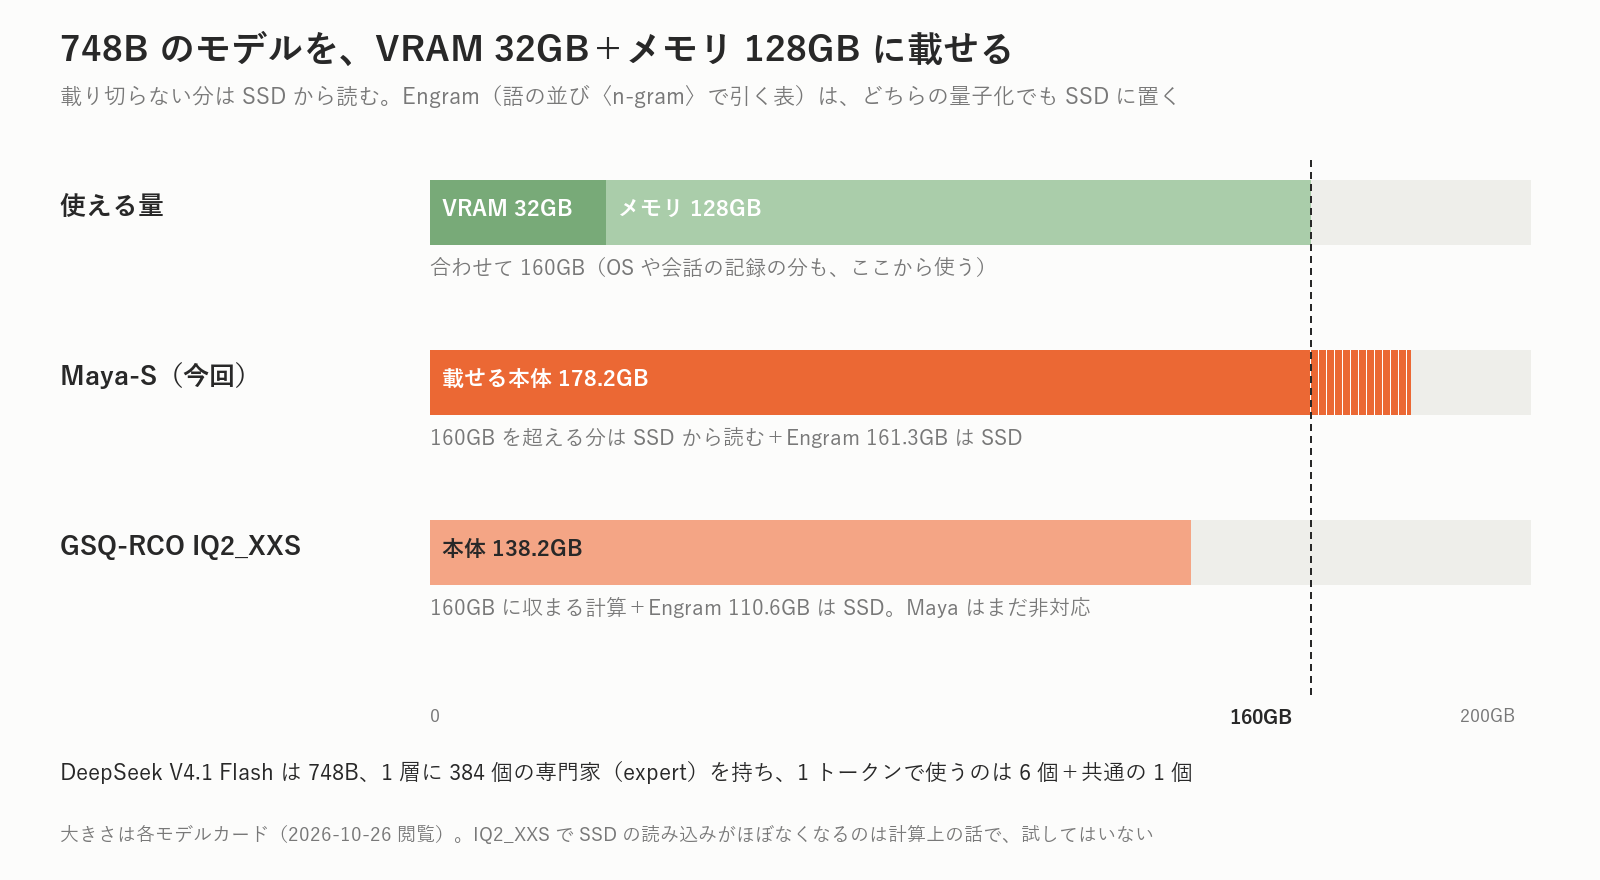
- モデル: DeepSeek V4.1 Flash 1017は748B。1層に384個の専門家を持ち、1トークンで使うのは6個と共通の1個です。量子化はMaya自身の「Maya-S」(専門家を2〜3ビットに圧縮)を使いました。モデルもMaya-Sも、ライセンスはMITです
- 載せ方: モデルカードによると、Maya-Sでメモリに載せる本体は178.2GB。GALLERIAのVRAMとメモリを合わせた160GBを超えるので、よく使う専門家をGPUに置き、残りはメモリとSSDから読みます。さらに「Engram」という、語の並び(n-gram)で引く表が161.3GBあり、こちらは最初からSSDに置きます。ダウンロードは全部で347.5GBでした
- 改良の速さ: 変更履歴を見ると、10月9日のv1.0.21から10月25日のv1.1.28まで、17日で約40版。DeepSeekへの対応は10月19日です。今回の測定はv1.1.26(10月23日)です
つなぎ方は、前に書いた「隔離+門番」と同じ考えです。MayaはGALLERIAの中からしか話しかけられない作りで、EVO-X2のVM(Codexが動く所)からは、Claude Codeが、転送だけに絞った鍵のSSHでつなぎました。MayaのAPIキーは中継が付けるので、Codexには持たせていません。管理用の窓口も中継が通しません。ほかに、Codexが送る指定のうち3つをMayaが断ったので、Claude Codeが中継で外しています。LM Studioはこの3つを黙って無視していました。
決まりどおりだと11/21。賢いのに、時間が足りない
既定のまま(Codexは考える量を指定しないので、Mayaの既定のhigh)だと、合格は11回でした。9回が25分の時間切れで、そのうち3回は成果物ができあがっていて、最後の確認の途中で切れています。
原因は、考える時間の長さです。
- 1回の応答で10分近く考えます。 ニュース選別(D1)では、記事を読み終えたあとの1回の応答が8,287トークン・585秒でした。中身のほとんどは思考です
- 校正(D4)では、最後の応答が823秒(約14分)続いたところで25分が来ました。 校正の結果(CSV)は書けていません
- 速さは毎秒11〜13トークンほど(読み込みを含む)。25分で出せるのは2万トークン足らずです。Mayaの利用者の報告には、RTX 5090で毎秒20トークン台のものもあります。Claude Codeは、Codexの会話は毎回1.5万〜3万トークンを読み直すので、そのぶん遅く見えるのだろうと見ています(確かめてはいません)
考える量を減らすと18/21、時間を延ばせば19/21
最初の測定で時間切れが続いたとき、私はこう考えました。DeepSeek V4.1 FlashはQwen3.8 Flash Nextより賢いはずなので、考える量を減らしても正解するのではないか。時間を延ばせば解けるのではないか。そこで、考える量を下げた組と、打ち切りを延ばした組も取ることにしました。
Claude Codeは、2つを1組で測る方法を提案しました。考える量をlowにして、打ち切りを50分にした21回です。打ち切りは時間が来たら止めるだけで、それまでの動きは変わりません。なので、25分以内に終わった回は、25分の打ち切りでもまったく同じ結果になります。同じ21回から、「low・25分」と「low・50分」の両方の点が出せるわけです。夜のうちに既定の組と続けて回してもらい、朝には終わっていました。
- low・25分で18/21。 時間切れが9回から1回に減りました。既定では3回とも時間切れだった校正(D4)と家計(D5)も、ほぼ通ります
- low・50分で19/21。 25分を超えたのは校正の1回(約29分で合格)だけでした
- 落としたのは動画のプロンプト(D3)の2回。 主に話者の印の付け方の誤りで、QwenやHaikuも同じように落とす課題です
- 考える量を減らしても、中身は落ちません。 伏せた採点で、lowは4.33。既定のうち時間内に終わった回も4.33でした
lowは、Mayaの目盛り(1〜100)で50に当たります。既定のhighは75です。つまり、間違えていたのではなく、考えすぎて時間が足りなかったわけです。
評価の決まりを1つ変えた(評価v2)
Codexの指示文は「ファイルの編集はapply_patchの道具で」と書いています。ところが、Codexが知らないモデル(OpenAI以外)には、その道具を渡しません。私はこのことに前から気づいていて、道具がなければ別の方法で対応するところまで含めて、モデルの力として評価していました。実際、QwenやNemotronは最初からシェルでファイルを書きます。Claude Haiku 5.5はapply_patchを呼んでは「その道具はない」と返され、シェルで書き直していました。
ところが、遅いモデルではこれが大きく響きます。
- Mayaは、一覧にない道具を呼ばれると応答を切ってしまいます。 最初の測定で、DeepSeekが何も書かずに終わる回がありました。Claude Codeが中身を追って原因を突き止め、LM Studioと同じように「その道具はない」が返る形に中継でそろえました
- やり直しに時間がかかります。 DeepSeekは毎秒11トークンほどなので、長いパッチを書いては断られ、同じ中身をシェルで書き直すだけで数分を失います。時間切れが続きました
そこで私は、この要因をなくすことにしました。今後の評価はすべて、OpenAI以外のモデルにもapply_patchを渡して行います。前に測ったモデルと比べられるよう、HaikuとQwenも測り直すことにしました。Claude Codeが作り直したのが「評価v2」です。
- Codexに本物のapply_patchを渡す。 指示文はこれまでと一字一句同じで、Codexが送る要求を捕まえて比べると、違いは道具が1つ増えただけでした。関数の形の道具しか受け付けないLM StudioとMayaには、中継が形を変えて渡します
- 判定器の取りこぼしを1つ直す。 家計(D5)で「7月の記録がない」を「2026-07の記録がない」と書くと、不合格になっていました(前の記事で「◇」を付けていた1本です)
- 25分の打ち切り、題材、プロンプトは変えない
Claude Codeが測り直した結果がこちらです。
| モデル | 前の評価(v1) | 評価v2 | apply_patchの呼び出し(v1 → v2) |
|---|---|---|---|
| Claude Haiku 5.5 | 19/21 | 19/21 | 19回すべて空振り → 59回中48回成功 |
| Qwen3.8 Flash Next | 18/21(判定器を直して読み直し。公開時は17) | 18/21 | 0回 → 43回中36回成功 |
| DeepSeek(既定) | 12/21 | 11/21 | 23回すべて空振り → 30回すべて成功 |
| DeepSeek(low) | 15/21 | 18/21 | 25回すべて空振り → 38回すべて成功 |
- HaikuとQwenの点は変わりませんでした。 これまでの記事の数字は、そのまま並べて読めます。Haikuは速いので、空振りの損は数十秒で済んでいました(中央値は58秒→50秒、費用は17%減)
- 遅いモデルほど損をしていました。 v1のDeepSeek(low)は、断られたパッチを21回で合わせて9万4,300字書いていました。生成の速さは同じなのに、v2では1回の平均が919秒から710秒に縮みました
- 既定のDeepSeekは変わりません。 こちらは道具の損より、1回の応答で10分以上考える長さのほうが効いています
中身:名前を伏せて採点すると
| 組 | 平均(5点満点) | 時間内に終わった回だけ |
|---|---|---|
| Qwen3.8 Flash Next(v2) | 4.53 | 4.63 |
| DeepSeek(low) | 4.33 | 4.33 |
| Claude Haiku 5.5(v2) | 4.31 | 4.31 |
| DeepSeek(既定) | 3.32 | 4.33 |
採点は、Claude Codeが立てたClaudeの採点者6体です。ルーブリック(採点の基準表)で、成果物を0〜5点で付けています。Claude Codeはモデル名を乱数のIDに置き換えて、順番も混ぜました。物差しの確認のため、前の評価のQwenも混ぜてあります。前の評価のQwenは4.57、v2は4.53で、apply_patchを入れても中身は変わりませんでした。
DeepSeekの弱い所は、ニュース選別の「選んだ理由の根拠」と「罠の扱い」(どちらもQwenより1点以上低い)と、家計の「計画の分解」でした。既定の3.32が低いのは、時間切れで成果物が欠けた回が0〜2点になったためです。時間内に終わった回だけなら、lowと同じ4.33になります。
私の感想
- この大きさのモデルが、32GBのVRAMと128GBのメモリとSSDで、遅いながらも試せるようになったのはうれしい。 ローカルLLMに関心を持っている者として、素直にそう思います
- DeepSeekは賢いけれど、この速さでは実用は難しい。 ただ、StrataやMayaは短い期間で改良が進んでいます。ISTA-DASLabが出したGSQ-RCO量子化のIQ2_XXS版は、本体が138.2GB。Claude Codeが計算すると、VRAMとメモリの160GBに収まるので、SSDから専門家を読む分はほぼなくなるはずです(Engramの表はSSDのまま)。作者の公表値では、3つのベンチマークで元のモデルと同じ点が出ています。いまはStrataに対応していて、llama.cppはまだ、Mayaへの対応はまだ書かれていません。Mayaが正式に対応したら、試してみたいと思っています
- 実用するなら、DeepSeekよりQwen3.8 Flash Next。 合格は同じ18/21で、中身はQwenが上。EVO-X2 1台のLM Studioで動き、考える量を調整する必要もありません。DeepSeekは、RTX 5090と128GBのメモリと350GB近いSSDの空きが要ります。バランスはQwenが良いと思います
- コーディングなら、DeepSeekのほうが良い可能性はあります。 今回の題材は日常の事務作業で、プログラミングは入っていません。ただ、QwenもDeepSeekも1回に10分以上かかる今の速さでは、どちらも実用の水準にありません。なので、評価は保留します
- Qwen 4に期待しています。 9月のアリババのイベントで、Qwen 4のMax・Flash・Plus・27Bの4つが話題になりました(名前は参加者の報告で、公式の発表文は「学習中」とだけ書いています)。この中に、Qwen3.8 Flash Nextの後継で同じくらいの大きさのものがあれば、また比べてみたいです
人間がやったこと、Claude Codeに任せたこと
| 人間(私) | Claude Code |
|---|---|
| GALLERIAにProject Mayaを入れて、DeepSeek V4.1 Flashを動かす(GALLERIA側のClaude Codeと)。つなぎ方の引き継ぎ書を渡す | 引き継ぎ書を読み、VMからMayaへの経路(SSHのトンネルと中継の設定)を作る。Mayaが断るCodexの指定を見つけて中継で外す |
| VMの鍵をGALLERIAに登録、APIキーをVMに置く(Claude Codeは中身を見ていない) | 約130回の実行・回収・判定、時間切れの中身の確認、夜通しの続けての実行 |
| MayaとLM Studio(Qwen)の起動・停止、ファイアウォールの規則の切り替え | Mayaが応答を切る原因探し、評価v2(道具の一覧、中継の形の変換、判定器の修正、モデルなしの通し試験) |
| 「時間切れの所は、考える量を下げる・時間を延ばすを試しては」「lowと打ち切り延長も取らないと比較にならないのでは」と提案 | 50分の1組から25分の点も出す測り方の設計 |
| 遅いモデルで時間切れが続くのを見て、apply_patchを渡す評価に変えると判断。前に測ったモデルも測り直すと決めた(Haikuから) | 名前を伏せた採点(Claude 6体)、REPORT |
| 記事にする判断、上の感想 | ライセンスやモデルカードの確認、この記事の下書きと図 |
正直、気になっていること
- 機械が違います。 QwenはEVO-X2(128GBの統合メモリ)、DeepSeekはGALLERIA(RTX 5090+128GB)です。速さの比較は「それぞれの機械で」の話です
- n=3です。 18と19、11と12のような1本の差は、偶然でも出ます
- 採点者はClaudeです。 名前は伏せましたが、Haikuには身内びいきが入るかもしれません。私は採点の中身を確かめていません
- Mayaの速さは、利用者の報告より遅く出ました。 理由は誰も確かめていません。Codexの使い方のせいか、こちらの設定のせいかは分かりません
- 「既定」の意味がモデルで違います。 Mayaの既定はhigh、HaikuはAPIの既定(medium)、QwenはLM Studioで考える量を変えていません
- Qwenの設定ファイルは10月12日に保存し直されていました。 会話の記録(KVキャッシュ)を8ビットで持つ設定です。Claude Codeが記録を調べましたが、9月と同じだったかは分かりませんでした。点は変わっていません
まとめ
- DeepSeek V4.1 Flash(748B)が、Project MayaでRTX 5090+メモリ128GBのPCで動いた。決まりどおりの25分では21回中11回、考える量を減らすと18回、50分なら19回
- 中身は良い(伏せた採点で4.33、Haikuと同じくらい)。ただ1回に10分以上考えることがあり、この速さではエージェントとして実用は難しい
- 実用するなら、バランスの良いQwen3.8 Flash Next。 コーディングでの比較は、速さが上がるまで保留
- 評価の決まりを変えて、OpenAI以外のモデルにもapply_patchを渡すようにした。HaikuとQwenの点は変わらない。 道具がないことで損をしていたのは、遅いモデル
- StrataやMayaの改良は速い。IQ2_XXSでSSDの読み込みが減るなら、もう一段速くなるかもしれない。Qwen 4と合わせて、続きを試します
RAMを足せばもっと速くなるのでは…。Mac Studio M5 Ultra 512GBがあれば…。そんな誘惑に負けないように必死で我慢しています。
コメント